在此前的几篇文章中,我们提出:AI智能体应当组合经过测试的分析节点,而不是从零重写代码(第一篇文章);审计一项研究的规则,应当在工作进行之时就作为软件运行(第二篇文章);研究人员和智能体需要一个超越聊天窗口的、可检查的共享环境(第三篇文章)。在第四篇文章中,我们深入到单项研究的内部,追问为什么来自反推数学的五个公理系统[1](我们把它们解读为五个动作,即执行()、选择()、稳定化()、分层()和自我反思())支配着我们的七个技能审计一份稿件、一张图或一张统计表的方式。
然而,没有哪位科学家会只凭一篇论文去设计一个为期两年的项目,或者撰写一份基金申请。在订购一管抗体或者选定一个基因靶点之前,研究人员必须广泛阅读整个课题的文献:几十篇乃至几百篇论文,由不同的实验室在几十年间发表,使用的检测方法、队列和统计惯例各不相同。这些针对单篇论文的检查,怎样才能帮助科学家理解一整个领域,并且在每周都有新研究出现的情况下让这个答案保持最新?
答案延续了我们在第四篇文章中讲过的故事:人类知识是怎样越过工作记忆的极限继续攀登的,即把已经证明的链条打包成构件,然后在这些构件之上,把同样的五个认知动作在高一层上再运行一遍。
为什么文献综述和AI摘要都受困于有损打包
正如我们在第四篇文章中看到的,人的工作记忆一次大约容纳四个组块;按照我们那个并不严格的类比,到了一条包含四次量词翻转的链(),就连训练有素的数学家也会感到吃力。数学家是靠概念压缩越过这一上限的:把一条多步的量词链打包进一个有名字的黑箱(例如一致收敛),使下一条定理可以把整条链当作一个名词来使用。这种压缩要让读者付出一些代价,因为一个名字遮住了它底下的依赖关系。然而它总是可以还原的,因为定义保留了每一个细节。
经验科学依靠的是完全相同的技巧,并把它叫作引用。当论文B在引言中引用论文A时(“通路促进骨关节炎中的软骨降解[A]”),它就把一份三十页的实验报告打包成了一句话的论断,好让这个领域转向下一个问题。
麻烦在于,引用是一种无法还原的压缩。在一个数学名称的背后,是一个任何人都可以展开的定义。而在一句引用的背后,只有一个指向那篇论文的指针:要找回那些条件,就得重新打开那篇论文并再审计一遍,而下一位作者很少这样做。在实践中,这句浓缩成一句话的摘要继续流传下去,而决定论文A的论断是否真正成立的那些条件,几乎一个也没有带上:
- 论文A报告的值,与它自己的检验统计量和自由度对得上吗?Nuijten及其同事用R软件包
statcheck检查了八种心理学期刊的30,717篇文章,在其中16,695篇里找到了可核对的、按APA格式报告的零假设检验(共258,105个值)。这些文章中有一半至少含有一个与自身检验统计量和自由度不一致的值:占这16,695篇的49.6%。在2,150篇文章(12.9%)中,重新计算值会改变结果在阈值上是否显著[2]。 - 论文A中的生物学检测,测到的真的是它所说的那个靶标吗?2026年10月,Sholto David报告了一项检索,对象是20种常用细胞系,它们带有已确认的基因缺失或双等位基因失活突变,涉及10种蛋白质。他在221篇已发表论文中找到了230份蛋白质印迹(Western blot)报告,它们声称在该基因未被重新表达的情况下检测到了那种缺失的蛋白质。例子有MCF-7细胞中的caspase-3(49篇论文)、Jurkat细胞中的BAX(47篇论文)和PC-3细胞中的STAT3(35篇论文)[3]。
- 论文A是否只在雄性小鼠中做过,只取了一个时间点,或者只做在mRNA上,而与之配对的蛋白质检测却没有出现变化?
- 论文B引用论文A的时候,论文A甚至还有效吗?Hsiao和Schneider考察了7,813篇已撤稿的PubMed论文,以及PubMed Central开放获取语料库中的48,134条正文内引文语境,发现撤稿并没有改变这些已撤稿论文被引用的方式;在撤稿之后的13,252条引文语境中,只有5.4%(722条)指出了该文已撤稿[4]。
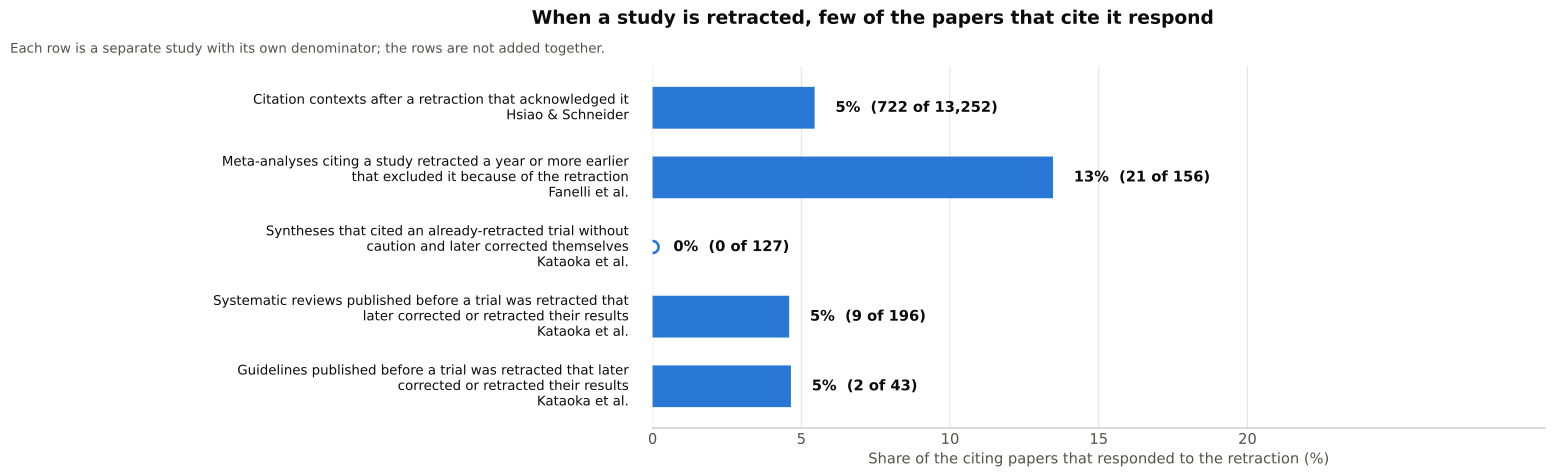
每一行来自不同的研究,各有自己的分母,所以各行不能相加。空心标记表示实测为零。来源:参考文献[4]、[10]和[11]。
这种丢失是可以追踪的。Steven Greenberg沿着242篇论文和675次引用,追踪了一个信念:β-淀粉样蛋白这种蛋白质异常而特异地存在于包涵体肌炎患者的肌纤维中。其中有十篇论文用原始数据检验过这一论断:四篇支持它,六篇削弱或否定了它。在指向这十篇论文的214次引用中,94%指向了那四篇持支持态度的论文。他还记录了一个仅仅通过引用就变成了事实的假说[19]。
论文本身保留下来的东西,比我们以为的要少。当“可重复性项目:癌症生物学”(Reproducibility Project: Cancer Biology)着手重复53篇高影响力论文中的193项实验时,没有一项实验能够仅凭已发表的论文及其补充材料设计出来;每一项都需要进一步澄清[20]。重新打开一篇论文,只能找回写下来的东西;在缺少某个实验方案细节的地方,审计必须把这个缺口记录下来,而不是假定该条件已经满足。
当一篇由人撰写的综述文章,或者一个对摘要做总结的标准检索增强AI工具,只读主要结论就把五十篇论文打包起来时,它就把那些不成立的假设、选择性的引用和没有说明的条件,一并压缩进了一个表面上的共识。正如Derek Lowe在Science上评论David关于缺失蛋白质的预印本时所警告的,那些据说将替科学家阅读全部文献的AI系统,也将被喂入这些错误的印迹,连同其他一切内容[5]。即使是正式的系统评价和荟萃分析,如果不先审计原始研究就把它们合并,也会落入同样的陷阱,而如今这样的系统评价和荟萃分析数量极多。John Ioannidis考察了1991年至2014年间PubMed收录的证据合成文献的增长。年发表量在系统评价上增长了2,728%,在荟萃分析上增长了2,635%,而PubMed整体为153%。仅“抗抑郁药治疗抑郁症”这一个题目,在2007年至2014年间就有185项不同的荟萃分析。在遗传流行病学中,他判断那一大批候选基因荟萃分析几乎全都具有误导性,因为它们合并的是零散而且经过选择性报告的研究[6]。
保留条件的打包:把一篇经过筛查的论文变成经过审计的证据胶囊(Evidence Capsule)
当我们从一份稿件扩展到一整个课题时,要阻止错误层层累积,打包就必须先经过审计,然后才能压缩。这就是我们正在构建的设计。我们不把一篇论文作为一段扁平的文字摘要,或者作为其摘要的嵌入向量存进数据库,而是把我们的单篇论文审计工作流用作把每篇论文打包成结构化证据胶囊的编译器。这些工作流是:biomedical-literature-evidence技能(验证记录)、academic-peer-review技能(技能页面、基准测试、PeerJ 20995盲测评审)、scientific-figure-master技能、scientific-writing技能(发布说明)、荟萃分析(meta-analysis)技能(性能报告)和孟德尔随机化(Mendelian randomization)技能(复现报告)。它与第四篇文章中的Big5c(即Big-5编译器)遵循同一个思路:在五个梯级上组织审查。Big5c把这种审查用在AI智能体拟执行的操作上;胶囊编译器则把它用在一篇论文上。
证据胶囊是一个保留了条件的科学压缩包。除了论文的书目身份信息和提取出的论断之外,它还保存了这项研究的五个大五元验证坐标:
- 第1梯级(执行回执):重新计算的检验统计量(
t、F、z、、比值比和标准误)、确切的样本量,以及解析后的物理单位(ug/g与particles/g严格分开)。 - 第2梯级(实验选择树):论断所依据的那条确切的实验分支:物种、品系、性别、年龄或暴露时长、组织区室、mRNA读数还是蛋白质读数,以及对照Cellosaurus等公共数据库核对过的细胞系和抗体,也就是我们在第二篇文章中描述过的那种查询。
- 第3梯级(多重性回执):这篇论文在同一个假设族中检验了多少个假设,以及核心结果是否经得住全族错误率校正或错误发现率校正。
- 第4梯级(层级与来源标签):这句陈述来自文档的哪个章节(
Methods和Results与Introduction、Discussion和References中关于文献的论述分开),分析的是哪个基础患者队列或数据集ID,以及这项研究设计处在证据等级中的什么位置。 - 第5梯级(混杂因素与状态台账):哪些混杂因素、阴性对照或多效性检查确实做过,哪些仍然是
unavailable,以及这篇论文或它的任何一篇关键参考文献是否带有更正、关注声明或撤稿声明。
范围狭窄的AI节点,每个都带有一个定制的提示词、它加载的技能和上下文,以及一个用于质量控制的关卡钩子(gated hook),把研究设计树和候选论断提取到显式的结构模式(schema)中;确定性代码节点则重新核算数值,检查细胞系和单位,并锁定胶囊的验证状态。
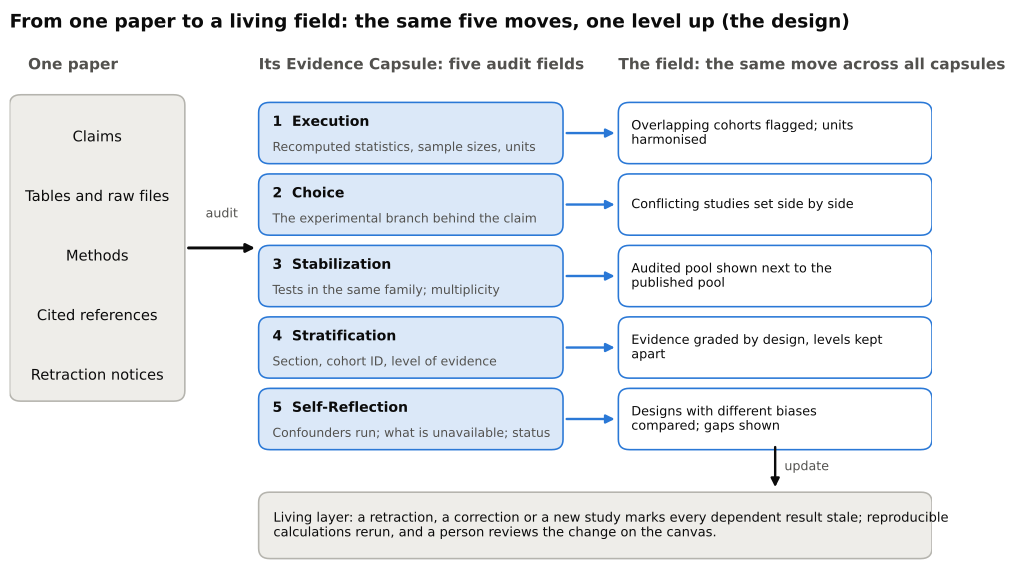
设计示意图。每个胶囊字段针对单篇论文回答梯子上的一个梯级;把同一梯级用在所有胶囊上,就得到右侧的领域层面动作。
二阶大五元梯子:覆盖整个领域的自动化元科学
在我们于第四篇文章中讲过的故事里,一旦一个复杂的过程被打包成一个经过验证的构件,数学家并不会发明第六种思考方式:他们踏上这块新的地基,在高一层上把同一架大五元梯子()再走一遍。
把已发表的论文打包成经过审计的证据胶囊,就让Nexitia和Nexitia Core(目前列为AROS Core)能够为科学家的研究课题做同样的事。当研究人员打开一个感兴趣的课题时,系统就会在该领域的全部胶囊之上,攀登一架二阶大五元梯子:
1. 领域层面的(执行):队列去重与单位统一
在两项研究可以比较或合并之前,确定性代码节点检查提取出的队列标识符、招募时间窗和物理单位,以检验这些研究是否相互独立、是否可通约。引擎利用biomedical-literature-evidence技能的“研究与报告”映射,把同一项研究的多份报告关联到这项研究上。对于两项研究可能共享受试者的情况(来自同一个医院登记库或生物样本库的论文常常如此),它单独加以记录,并把尚未解决的重叠显示出来,而不是把它计算两次。它对齐效应方向,并对相容的测量尺度进行转换,同时在没有经过验证的换算系数时,拒绝合并不可通约的物理单位。
2. 领域层面的(选择):交叉核对结论与“解压”矛盾
在几乎每一个活跃的领域里,科学家迟早会遇到矛盾:实验室A报告某个靶点具有保护作用,实验室B却报告它有害或者没有作用。传统的综述会把这种冲突抹平成一句客气话(“结果仍存在争议”)。引擎首先检查这两个结果针对的是否是同一个问题、是否真的不一致,因为一个显著的估计值和一个无定论的估计值可以是相容的。
由于每个证据胶囊都保存着它的实验选择树,我们的领域层面引擎把这些胶囊映射到一张共享的分支图上,并在Nexitia画布上把相互冲突的成对结果并排解压。科学家看到的不再是一个含糊的争议,而是两个实验室分道扬镳的那条确切的分支:
- 是不是实验室A在雄性小鼠中于6周时测的是mRNA,而实验室B在雌性小鼠中于24周时测的是蛋白质?
- 是不是一项研究用的是PC-3细胞(它缺少内源性STAT3[3]),而另一项用的是人的原代组织?
- 是不是一项流行病学研究评估的是4.6年的随机化药物暴露,而另一项评估的是54.9年的终生遗传暴露[7]?
把矛盾解压开来,就把文献中的一个僵局变成了一份简短的实验清单,这些实验能够把相互竞争的解释区分开。
3. 领域层面的(稳定化):“先审计、后合并”的动态合成
当多个胶囊测量的是同一个定量对比时,荟萃分析技能会计算合并效应、异质性()、预测区间和小样本研究偏倚标记;其与RevMan兼容的引擎在28篇Cochrane系统评价中复现了1,061项合并分析中的1,060项,以及11,351个可核对的定量条目中的10,797个(95%)。
关键在于,由于每个胶囊都带着它的单篇论文审计回执,数据库会计算两份并排的合成结果:
- 已发表合并:应用胶囊检查之前的估计值,每一个已发表的结果都按其报告的原样采用。
- 大五元审计后合并:经过以下处理之后留下来的结果:剔除已撤稿的研究,对相互重叠的队列去重,把重新计算的值会改变其显著性的结果(即
statcheck所检测的严重不一致[2])标记出来交给人核对,同时给出包含与不包含那些仍未解决的结果时的合并结果,并把互不相容的检测方法分开。
一个由四十篇论文构成的“共识”,在经过“先审计、后合并”的筛选之后,可能坍缩成两个规模很小、彼此不一致的人类队列;及早看到这一点,可以让一个实验室省下追逐一个假象所耗费的十八个月和一笔基金预算。
4. 领域层面的(分层):让各个层级保持分开的证据分级
并非所有胶囊都处在现实的同一个梯级上。GRADE框架从研究设计出发,因研究局限性、不一致性、间接性、不精确性和报告偏倚而下调证据质量评级,因效应量大或存在剂量–反应梯度而上调[8];我们的分层引擎应用这一框架背后的原则,把每个胶囊放到一个严格偏序上:
这与第四篇文章中的那个顺序不同,那个顺序记录的是每一层与所提出的论断相距多远。这一个则是我们自己为针对人类的因果论断所排的顺序。它从GRADE借用了这样一个想法:从研究设计出发,然后因证据的缺陷而下调评级,或因证据的长处而上调评级[8]。
由于各层被严格分开,三十篇使用未经验证的抗体的细胞系论文,永远无法在票数上压过一个统计效能充足的人类队列,或者一项工具变量选择得当的孟德尔随机化研究。每一个课题问题都会得到一个明确的、可检查的证据等级,它锚定在通过审计检查的最高层上,并根据仍然存在的局限加以调整。
5. 领域层面的(自我反思):证据三角互证与空白发现
在前沿生物学和病因流行病学中,研究人员很少有二十项完全相同的随机试验可供合并。更多的时候,他们手里是几条性质各异的证据线索:一项前瞻性队列研究、一项孟德尔随机化分析、一项同胞比较、一项动物扰动实验和一项阴性对照研究。
正如Lawlor、Tilling和Davey Smith在他们的证据三角互证框架中所阐述的,当多种方法的结果一致,而这些方法的关键偏倚来源彼此无关(最好还使估计值朝相反的方向偏倚)时,因果推断的把握最强。例如,把多变量队列回归(容易受到残余的社会经济混杂的影响)与两样本孟德尔随机化(主要容易受到水平多效性而不是生活方式混杂的影响)以及随机试验的中间结局配合起来,同时考虑暴露的持续时间和时机[7]。反过来,当Lawlor及其同事围绕母乳喂养与日后的体重指数,对队列研究、低收入和中等收入国家的跨情境比较、一项随机化的促进试验和阴性对照结局(父母报告的家中有老鼠或鸽子侵入)进行三角互证时,阴性对照和相互正交的设计支持这样的解释:队列中表面上的保护性关联,来自社会经济和家庭背景造成的残余混杂[7]。
在第5梯级(),我们的领域层面引擎借助我们的各个技能把三角互证付诸实施:它比较不同研究设计的因果对比、暴露时机和预期偏倚,并检查它们的结果是否支持同一个相容的解释;标记出在整个课题范围内哪些混杂因素或多效性通路仍未得到检验;并在Nexitia画布上突出显示候选的科学空白(一项缺失的实验,或者一个尚未调整的混杂因素),可以直接送入grant-write-master技能(验证记录、事实保留记录),或者送入一个CohortDAG(发布说明)和Tracyte分析工作流。
一个具有编译器式依赖失效机制的动态数据库
一个静态的文献数据库,从编成的那一天起就开始衰败。Shojania及其同事追踪了ACP Journal Club收录的100篇针对随机试验的定量系统评价。其中57%出现了要求更新的定量或定性信号,而一篇系统评价在此之前存活时间的中位数是5.5年。有些老化得快得多:23%在发表后2年内就已过时,15%在1年内过时,还有7%在发表当天就已过时[9]。
更糟的是,当一项被纳入的试验后来被撤稿时,静态的系统评价几乎从不自我更正。Kataoka及其同事考察了587篇引用了已撤稿随机对照试验的系统评价和临床实践指南。其中127篇未加警示地引用了一项当时已经撤稿的试验,而截至2022年5月,它们没有一篇做过更正。另有239篇发表于该试验撤稿之前;在这些文献中,只有5%的系统评价(196篇中的9篇)和5%的指南(43篇中的2篇)更正或撤回了自己的结果[10]。
这些引用中有许多本来是可以避免的。Fanelli、Wong和Moher考察了2013年至2016年间发表的229项引用了某项已撤稿研究的荟萃分析。其中156项(68%)所引研究的撤稿,比施引的荟萃分析发表早了至少一年,然而在这156次本可避免的引用中,只有21次(13%)因为该研究已被撤稿而把它排除在外[11]。
而且正如Bakker、Schneider及其同事在BMJ Evidence-Based Medicine上指出的,虽然剔除单独一篇已撤稿的论文之后,大多数荟萃分析的结果基本不变,但有缺陷的或者伪造的数据可以改变结论:排除两项有缺陷的研究,使一篇已发表的综述关于伊维菌素降低COVID-19死亡率的结论不再成立;而排除一项受数据造假影响的试验,将改变22项阿哌沙班荟萃分析中一半以上的分析[12]。
为了解决这个问题,Elliott、Higgins及其同事提出了动态系统评价(living systematic review):持续更新的在线证据合成,文献检索的结果不断进入质量评价、数据提取和荟萃分析,他们还讨论了用序贯方法和贝叶斯方法来处理反复更新可能产生的假阳性[13]。
我们的数据库架构把动态系统评价变成一张编译而成的依赖图,围绕科学家订阅的课题来构建:
- 持续摄入与打包:对于研究人员或实验室在Nexitia上关注的每一个课题,系统监测PubMed、Europe PMC和Crossref上新发表的文章和预印本,把每一项它能读到全文的新研究编译成经过审计的证据胶囊,把只有摘要的记录保持为未核实状态,并把两者都挂接到课题图上。
- 编译器式的依赖失效:由于数据库中的每一个合并估计值、证据等级和三角互证箭头,都记录了它通向底层证据胶囊的明确依赖路径(
bound_paths),这个数据库的行为就像一个软件构建系统。如果上游的一篇论文在Crossref/Retraction Watch上被撤稿或更正,或者一项新的审计检查标记出某种试剂或统计上的缺陷,那么依赖该胶囊的每一个下游合成节点都会被自动标记为过期。一项新发表的研究进入某个课题的合格研究集合时,也会同样把该课题的合成结果自动标记为过期。随后,可复现的计算重新运行,需要判断的决定则交还给人。 - 以信号为门槛、面向人的通知:这份动态台账不是每天用论文提醒把研究人员淹没,而是在一项新打包的研究或一次上游失效越过预先设定的更新边界、实质性地改变某个合并估计值或其不确定性、改变某个证据等级,或者化解一个已解压的矛盾时,在画布上(包括AXIO这样的下游可视化工具)通知人类科学家。而通过我们在第三篇文章中描述的共享大脑联邦和MCP服务器(白皮书、隐私政策、精选交换平台),由一个实验室整理的、经过验证的胶囊图可以作为可复用的科学资产来分享,这样下一位研究人员就再也不必从零开始重新筛查同样的三百篇论文。
为什么科学家仍然处在中心
这一架构也说明了我们的做法与过去两年出现的通用“AI科学家”流水线有何不同:
- 在合并之前审计原始材料,而不是对摘要或三元组做总结:对摘要做总结、在文本中标记句子层面的矛盾,或者把论文简化成扁平的
(Subject, Predicate, Object)知识图谱三元组的检索增强文献工具,会把已发表的文字中所含的任何错误原样带下去。证据胶囊则在任何一个数字进入合并之前,审计已发表的表格、可获得的.xlsx补充材料和.docx图表缓存、多重性界限、细胞系遗传学[3]、statcheck算术[2]和撤稿声明[4],并记录哪些检查缺少它们所需的输入。 - 执行经过验证的工作流节点,而不是为每篇论文临时编写新脚本:让语言模型从零编写新分析代码的端到端论文生成器,可以产出一份在人类读者看来令人信服的稿件,同时却隐藏着数据泄漏缺陷和图文矛盾。Yamada及其同事把The AI Scientist-v2自主生成的三份稿件提交给ICLR 2025的一个研讨会进行同行评议。三份中有一份通过了,得分6.33,位列全部投稿的前45%;另外两份被拒。更糟的是,作者随后审计了那篇被接收的论文。重新运行它的合成数据生成器之后发现,大约57%的测试条目也出现在训练集中。图3的图注错误地描述了验证损失的趋势,而正文称两种架构表现相当,图5却显示其中一种领先[14]。在我们的架构中(第一篇文章、第二篇文章),智能体组合的是确定性代码节点和审计科研的AI智能体工作流,而不是临时编写未经检查的脚本。
- 把确定性软件与人在GUI画布上的领域评审结合起来,而不是让模型给模型打分:由一个语言模型评判另一个模型的想法的内部辩论循环,替代不了实证检验,也替代不了领域专长。在一项由79名NLP研究者为研究想法打分的盲法研究中,每一个被测试的语言模型评估器与专家排序的一致率(43.3%至53.3%),都低于专家彼此之间的一致率(56.1%)[15]。在Nexitia中,软件负责强制执行确定性的算术和数据库规则,而人类科学家则使用对人友好的GUI,在工具的画布上审阅智能体的选择。
为什么要让人类科学家处在一个自动化合成引擎的中心?因为物理世界里的生物学和临床医学,是按一只单靠算力无法压缩的时钟运行的。Wong、Siah和Lo利用41,040条产业界药物研发路径(15,102种药物,每种药物针对它试验过的每一种疾病各计一次),估计从1期临床试验起获批的概率为13.8%[16],而每一条路径都要花费数年的湿实验检测和临床随访。由于在已有的实证数据集上进行的纯in silico探索(孟德尔随机化技能中的人类遗传工具变量、荟萃分析技能中的试验表格、CohortDAG中的临床队列,以及Tracyte中的单细胞图谱)只需几小时或几天,而不是湿实验台上的几个月,我们预期一位研究人员能够在一个两个月的周期内检验大约十个干实验假设,并把实验台上的实验留给那些经受住全部五个审计梯级的信号。
更快的干实验探索,把瓶颈从产生候选假设转移到了验证和消化它们。Terence Tao在他2026年国际数学家大会报告的书面版本中指出,从稀缺时代走向AI带来的丰裕时代,会让解决一个问题背后的五个阶段显露出来(生成、验证、阐述、学界接受即消化,以及规范化为定型的理论),每当未经加工的机器解答积累得比人类专家验证、解释和消化它们的速度更快时,就会产生他所说的“证明消化不良”(proof indigestion)[17]。OpenAI在2026年10月批量发布了722个已解决的数学问题,分属350多项发现,正说明了这个问题:在Tao读过的其中大约十篇论文里,有一两篇包含真正巧妙的新想法,也有一两篇已经因为错误而被撤回[18]。Tao提议:把优先权给予最先以清晰、公开的科学阐述呈现某个结果的作者,把学术贡献的认可以至少把证明完善到可发表的阶段为条件,并把声望转向那些验证和消化结果的人[18]。在经验性的生物学中也和在数学中一样,随着AI系统接手穷举式的计算和文献筛查,人类科学家的一项首要职责,就是提出正确的问题,审计AI的假设,并把密集的定量输出转化为同行能够理解和检验的清晰的生物学解释。我们正在与我们的科研合作者一起开发这套人与AI协同的验证工作流,他们的参与通过三种输入直接构建着引擎和动态数据库:
- 感兴趣的课题(科学品味)为数据库播种:算力可以检查四万个基因,却没有科学品味去判断哪一个生物学悖论或临床瓶颈是重要的。当合作者选定他们想要关注的课题时,这些问题就确立了我们在Nexitia上的动态证据胶囊数据库的奠基课题图。
- 原创想法引导因果三角互证:合作者贡献出需要在相互正交的干实验数据集上探索的机制假说和悖论[7],把引擎引向这样的问题:在那里,化解一个矛盾会改变下一项研究,或者改变grant-write-master技能中的下一份基金申请。
- 评审意见升级验证节点:当一位合作者在Nexitia画布上审计一份稿件或一份证据胶囊合成结果,并发现一个微妙的生物学混杂因素、一种检测假象或一处解释上的漏洞时,这条批评所做的不只是修正一篇论文。研究人员可以把这项检查编码成一个自定义节点(它可以容纳研究人员自己的代码,适用于任何情况),或者在scientific-writing技能或academic-peer-review技能中改进一个AI节点(它带有一个定制的提示词、它加载的技能和上下文,以及一个用于质量控制的关卡钩子),并为这个节点命名、编写说明,使他们自己的智能体能够复用它。
通过Nexitia Core(目前列为AROS Core)和共享大脑联邦分享出去之后,这样一项检查就把一位科学家的细致阅读传递了下去,成为另一个实验室可以检查和复用的规则。
参考文献
- Simpson SG (2009). Subsystems of Second Order Arithmetic, 2nd ed. Perspectives in Logic, Cambridge University Press. doi:10.1017/CBO9780511581007. 定义了二阶算术、量词交替复杂度和五个主要子系统(、、、和)。
- Nuijten MB, Hartgerink CHJ, van Assen MALM, Epskamp S, Wicherts JM (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods 48(4): 1205–1226. doi:10.3758/s13428-015-0664-2. 在八种心理学期刊的30,717篇HTML文章上运行了自动化的R软件包
statcheck,从16,695篇文章中提取出258,105个按APA格式报告的零假设检验:这16,695篇文章中有49.6%(8,273篇)至少含有一个不一致的值,12.9%(2,150篇)至少含有一处跨越显著性阈值的严重不一致。 - David S (2026). Erroneous reports of protein expression in cell lines with genetic deletions and mutations. Zenodo (21 October 2026). doi:10.5281/zenodo.23498482. 对照Cellosaurus、人类蛋白质图谱(Human Protein Atlas)、Cell Model Passports和GEO测序数据,核查了20种带有已确认的纯合缺失或双等位基因失活突变的常用细胞系,涉及10种蛋白质;在一人完成的检索中,在221篇已发表论文里发现了230份错误的蛋白质印迹报告。
- Hsiao T-K, Schneider J (2021). Continued use of retracted papers: temporal trends in citations and (lack of) awareness of retractions shown in citation contexts in biomedicine. Quantitative Science Studies 2(4): 1144–1169. doi:10.1162/qss_a_00155. 分析了7,813篇已撤稿的PubMed论文、169,434次iCite引用,以及来自PubMed Central开放获取子集的48,134条正文内引文语境:撤稿没有改变论文被引用的方式,在撤稿之后的13,252条引文语境中只有5.4%(722条)指出了该文已撤稿。
- Lowe D (2026). The case of the should-be-missing proteins. Science, In the Pipeline, 21 October 2026. https://www.science.org/content/blog-post/case-should-be-missing-proteins. 对David预印本的评论,指出一个人就在221篇论文中找到了230个错误的蛋白质印迹例子,并警告说,为综合已发表文献而构建的AI系统将把这些错误一并吸收进去。
- Ioannidis JPA (2016). The mass production of redundant, misleading, and conflicted systematic reviews and meta-analyses. The Milbank Quarterly 94(3): 485–514. doi:10.1111/1468-0009.12210. 综述了1986年至2015年的PubMed收录情况和实证评价:1991年至2014年间,年发表量在系统评价上增长了2,728%,在荟萃分析上增长了2,635%,而PubMed全部条目为153%;其中包括2007–2014年间185项关于抗抑郁药治疗抑郁症的荟萃分析,以及大量合并了零散而有偏倚的原始研究的候选基因荟萃分析。
- Lawlor DA, Tilling K, Davey Smith G (2016). Triangulation in aetiological epidemiology. International Journal of Epidemiology 45(6): 1866–1886. doi:10.1093/ije/dyw314. 把因果三角互证定义为:比较至少两种关键偏倚来源彼此无关(最好偏倚方向相反)的方法所得的结果,同时考虑暴露的持续时间和时机;文中用收缩压与冠心病(4.6年的RCT、13.2年的队列研究和54.9年的遗传工具变量研究)、母亲空腹血糖与出生体重,以及母乳喂养与日后的体重指数(其中阴性对照结局揭示了残余混杂)作了示例。
- Guyatt GH, Oxman AD, Vist GE, Kunz R, Falck-Ytter Y, Alonso-Coello P, Schünemann HJ; GRADE Working Group (2008). GRADE: an emerging consensus on rating quality of evidence and strength of recommendations. BMJ 336(7650): 924–926. doi:10.1136/bmj.39489.470347.AD. 概述了GRADE系统:从研究设计出发,并根据研究局限性、不一致性、间接性、不精确性、报告偏倚、效应大小和剂量–反应梯度加以调整,把证据分为四个质量等级(高、中、低和极低)。
- Shojania KG, Sampson M, Ansari MT, Ji J, Doucette S, Moher D (2007). How quickly do systematic reviews go out of date? A survival analysis. Annals of Internal Medicine 147(4): 224–233. doi:10.7326/0003-4819-147-4-200708210-00179. 对100篇针对随机或半随机试验的定量系统评价(中位数为13项研究和2,663名受试者)所作的生存分析:57%出现了定量或定性的更新信号,中位生存时间为5.5年,而23%在2年内过时,15%在1年内过时,7%在发表之日就已过时。
- Kataoka Y, Banno M, Tsujimoto Y, Ariie T, Taito S, Suzuki T, Oide S, Furukawa TA (2022). Retracted randomized controlled trials were cited and not corrected in systematic reviews and clinical practice guidelines. Journal of Clinical Epidemiology 150: 90–97. doi:10.1016/j.jclinepi.2022.06.015. 一项元流行病学研究,对象是587篇引用了已撤稿RCT的系统评价(525篇)和临床实践指南(62篇):在未加警示地引用了一项当时已撤稿的RCT的127篇证据合成文献中,有0篇在发表后作了更正;在该RCT撤稿之前发表的239篇证据合成文献中,只有5%的系统评价(196篇中的9篇)和5%的指南(43篇中的2篇)更正或撤回了自己的结果。
- Fanelli D, Wong J, Moher D (2022). What difference might retractions make? An estimate of the potential epistemic cost of retractions on meta-analyses. Accountability in Research 29(7): 442–459. doi:10.1080/08989621.2021.1947810. 考察了2013–2016年发表的229项引用了某项已撤稿研究的荟萃分析:68%的撤稿发生在施引的证据合成文献发表之前至少一年,而在这些本可避免的引用中,只有13%(156次中的21次)因该研究已撤稿而将其排除;在合并了已撤稿研究的50项荟萃分析中,剔除它之后汇总估计值平均变化很小,当撤稿涉及数据或结果时变化更大。
- Bakker C, Boughton S, Faggion CM, Fanelli D, Kaiser K, Schneider J (2024). Reducing the residue of retractions in evidence synthesis: ways to minimise inappropriate citation and use of retracted data. BMJ Evidence-Based Medicine 29(2): 121–126. doi:10.1136/bmjebm-2022-111921. 综述了已撤稿研究为何在证据合成中持续存在(数据库标记不一致、到撤稿平均滞后33个月,以及撤稿信息没有传递到系统评价的工作流程中),并记录了排除有缺陷或伪造的数据后结论发生改变的案例,包括一项关于伊维菌素与COVID-19死亡率的结论,以及22项阿哌沙班荟萃分析中一半以上的分析。
- Elliott JH, Turner T, Clavisi O, Thomas J, Higgins JPT, Mavergames C, Gruen RL (2014). Living systematic reviews: an emerging opportunity to narrow the evidence-practice gap. PLoS Medicine 11(2): e1001603. doi:10.1371/journal.pmed.1001603. 提出了动态系统评价:持续更新的在线证据合成,由持续检索、半自动化筛选、结构化的关联数据存储库驱动,并且作为尚在讨论中的选项,用序贯方法或贝叶斯方法处理反复更新中的假阳性。
- Yamada Y, Lange RT, Lu C, Hu S, Lu C, Foerster J, Clune J, Ha D (2025). The AI Scientist-v2: workshop-level automated scientific discovery via agentic tree search. arXiv:2504.08066. 把三份自主生成的稿件提交给ICLR 2025一个研讨会的盲法同行评议:其中一篇报告组合正则化(compositional regularisation)阴性结果的论文得分6.33(前45%,高于接收阈值),而作者自己对其代码和文本的审计发现了57%的训练集与测试集重叠、一条不准确的图3图注,以及与图5相矛盾的正文。
- Si C, Yang D, Hashimoto T (2024). Can LLMs generate novel research ideas? A large-scale human study with 100+ NLP researchers. arXiv:2409.04109; ICLR 2025. 一项盲法研究,有49名专家撰写想法、79名专家评审(298份评审):每一个被测试的LLM评估器与专家的排序一致率(43.3%至53.3%),都低于专家彼此之间的一致率(56.1%)。
- Wong CH, Siah KW, Lo AW (2019). Estimation of clinical trial success rates and related parameters. Biostatistics 20(2): 273–286. doi:10.1093/biostatistics/kxx069. 对2000年至2015年间覆盖21,143种化合物的406,038条临床试验记录逐条路径进行分析:在所有适应证中进入1期的41,040条产业界研发路径(15,102种药物)里,估计有13.8%最终获得监管批准。
- Tao T (2026). Mathematics in the age of AI. Proceedings of the International Congress of Mathematicians 2026 (submitted); arXiv:2608.16753. 把数学问题的解决拆解为五个阶段,即证明的生成、验证、阐述、学界的消化/接受,以及规范化为定型的理论(Goal 6.5,Figure 4),并分析了从证明稀缺到AI驱动的证明丰裕的转变,如何在生成快于人类的验证、阐述和同行评议时造成“证明消化不良”。
- Tao T (2026). Terence Tao on AI in mathematics (and beyond): a living, curated summary of my current thinking on AI, with a companion interview (updated 2 November 2026). https://teorth.github.io/tao-web/ai-views.html. 综合了Tao的若干讲座和评论,内容涉及Lean中的形式化验证,“Math 2.0”(他为继证明稀缺的“Math 1.0”之后的证明丰裕时代提出的纲领),OpenAI在2026年10月批量发布的、分属350多项发现的722个已解决问题,以及他的提议:把优先权和学术贡献的认可给予那些照管、验证并把结果解释到发表标准的研究者。该页面自述由一个AI助手(Claude)根据Tao公开的文章、演讲和访谈编写并起草,再经他审阅和修订。
- Greenberg SA (2009). How citation distortions create unfounded authority: analysis of a citation network. BMJ 339: b2680. doi:10.1136/bmj.b2680. 围绕一个关于包涵体肌炎中β-淀粉样蛋白的论断,绘制了由242篇论文和675次引用构成的网络:在指向十篇原始数据论文的214次引用中,94%指向了其中支持该论断的四篇,而削弱或否定它的六篇得到6%;该研究对引用作了分类,并没有检验该论断是否为真。
- Errington TM, Denis A, Perfito N, Iorns E, Nosek BA (2021). Challenges for assessing replicability in preclinical cancer biology. eLife 10: e67995. doi:10.7554/eLife.67995. 在来自53篇高影响力癌症生物学论文的193项实验中,没有一项能够不经澄清、仅凭论文及其补充材料设计出来;完成了来自23篇论文的50项实验。
我们的记录:
- Biomedical Literature Evidence 1.0.0-public.1 验证记录:19个unittest方法通过;把研究与相互重叠的队列文章区分开;3条RIS和CSL-JSON记录中有3条保持为未核实状态;合成的“已完成但证据不足”台账检查(
completed: true, support_ready: false)。 - 孟德尔随机化(Mendelian randomization) 1.0.0-public.2 复现报告:Walker等人2019年研究v2,案例2(存档的163行中保留157行,19个核心单元格中有19个一致,记录了一处正文与表4之间的不一致)。
- 荟萃分析(Meta-analysis) 1.0.0 性能报告:28篇开放获取的Cochrane系统评价,1,061项合并分析中的1,060项以及11,351个可核对的定量条目中的10,797个得到复现(95%)。
- Scientific Figure Master 1.1.2 技能页面:20条真实图注的61个评分字段中有61个正确;当重新计算的与图注相矛盾时,不画显著性星号。
- Grant Writing Master 7.0.0-public.1 验证记录和事实保留记录:阴性的预实验结果()和非因果性的措辞在多轮修订和多种语言之间得到保留。
- Scientific Writing 1.1.0 发布说明:完整的稿件修订对比,并附有单独的编辑决定记录和数值源表核对。
- Academic Peer Review 1.0.2 技能页面、基准测试和PeerJ 20995盲测评审:依据60份公开评审中的1,035条意见进行了校准;在一份盲测投稿上,捕捉到49个逐条审稿要点中的6个,并要求做出9处从v1到v2的修改中的5处。
- CohortDAG 0.2.0 发布说明、Tracyte和AXIO:经过验证的工作流节点和可视化的画布检查。
- Nexitia Core(在产品页面上列为AROS Core)、共享大脑统计、AROS白皮书、隐私政策、MCP服务器和精选交换平台:联邦式程序性记忆、渐进式上下文披露和工作流交换;以课题为范围的动态证据胶囊数据库(尚无公开记录)。