これまでの論考で私たちは、AIエージェントはコードを一から書き直すのではなく、テスト済みの解析ノードを組み合わせるべきだということ(最初の論考)、研究を監査するための規則は、作業が行われている最中にソフトウェアとして実行されるべきだということ(2番目の論考)、そして研究者とエージェントには、チャットウィンドウを越えた、点検可能な共有の環境が必要だということ(3番目の論考)を論じました。4番目の論考では、1つの研究の内側に目を向け、逆数学の5つの公理系 [1] が、私たちの7つのスキルによる原稿、図、統計表の監査のあり方をなぜ決めるのかを問いました。私たちはこの5つの公理系を、5つの一手、すなわち実行()、選択()、安定化()、階層化()、自己省察()として読んでいます。
しかし、1本の論文だけをもとに2年がかりのプロジェクトを設計したり、研究費の申請書を書いたりする科学者はいません。抗体を1本注文する前にも、標的遺伝子を選ぶ前にも、研究者は1つのトピック全体を読み渡さなければなりません。それは、異なる研究室が、異なるアッセイ、コホート、統計上の慣行を使って、数十年にわたって発表してきた数十本から数百本の論文です。では、こうした1本の論文に対するチェックは、科学者が分野全体を理解し、毎週新しい研究が現れるなかでその答えを最新に保つうえで、どのように役立つのでしょうか。
その答えは、4番目の論考で語った物語の続きにあります。人間の知識は、証明済みの連鎖を部品に詰め込み、その部品の上で同じ5つの認知的な一手を1つ上の水準で繰り返すことによって、ワーキングメモリの限界を超えて登っていく、という物語です。
文献レビューとAIによる要約が、非可逆なパッキングに苦しむ理由
4番目の論考で見たように、人間のワーキングメモリが一度に保持できるのはおよそ4つのチャンクであり、私たちのゆるやかな類推で言えば、量化子の反転が4回続く連鎖()は、経験を積んだ数学者でさえ苦労するところです。数学者は概念の圧縮によってその天井を越えました。複数の段階からなる量化子の連鎖を、たとえば一様収束のような名前のついたブラックボックスに詰め込み、次の定理がその連鎖全体を1つの名詞として扱えるようにしたのです。この圧縮は読み手に代償を求めます。名前は、その下にある依存関係を隠してしまうからです。それでも、圧縮はいつでも元に戻せます。定義があらゆる細部を保っているからです。
実証科学もまったく同じ仕掛けに頼っていて、それを引用と呼びます。論文Bが序論で論文Aを引用して「経路 は変形性関節症における軟骨の分解を促進する [A]」と書くとき、論文Bは30ページの実験報告を1文の主張に詰め込み、分野が次の問いに進めるようにしています。
困ったことに、引用は元に戻せない圧縮です。数学の名前の背後には、誰でも展開できる定義があります。引用する1文の背後にあるのは、論文を指すポインタだけです。条件を取り戻すには、その論文をもう一度開いて監査し直さなければなりませんが、次の著者がそうすることはめったにありません。実際には、1文の要約は、論文Aの主張が本当に成り立つかどうかを決めていた条件のほとんどすべてを置き去りにしたまま、先へ伝わっていきます:
- 論文Aで報告された 値は、その論文自身の検定統計量と自由度に一致していたでしょうか。Nuijtenらは、Rパッケージの
statcheckを8つの心理学誌の30,717本の論文に対して実行し、そのうち16,695本で、APA形式で書かれたチェック可能な帰無仮説検定を見つけました( 値は合計258,105個)。それらの論文の半数には、自身の検定統計量と自由度に合わない 値が少なくとも1つありました。16,695本のうちの49.6%です。2,150本の論文(12.9%)では、 値を再計算すると、 の閾値で結果が有意かどうかが変わりました [2]。 - 論文Aの生物学的アッセイは、名指しされた標的を本当に測定していたでしょうか。2026年10月にSholto Davidは、遺伝子欠失または両アレル性の不活化変異が確認されている、よく使われる20種類の細胞株を対象とし、10種類のタンパク質にわたる検索の結果を報告しました。彼は、遺伝子を再発現させていないのに、欠けているタンパク質を検出したと主張するウェスタンブロットの報告を、221本の出版論文のなかに230件見つけました。例としては、MCF-7細胞のcaspase-3(49本)、Jurkat細胞のBAX(47本)、PC-3細胞のSTAT3(35本)があります [3]。
- 論文Aは、雄のマウスだけで、あるいは単一の時点だけで実施されたものではなかったでしょうか。あるいは、対になるタンパク質のアッセイでは変化が見られなかったのに、mRNAの結果だけに基づいていなかったでしょうか。
- 論文Bが引用した時点で、論文Aはそもそもまだ有効だったでしょうか。HsiaoとSchneiderが、撤回された7,813本のPubMed論文と、PubMed Centralのオープンアクセスコーパスにある48,134件の本文中の引用文脈を調べたところ、撤回は、撤回論文の引用のされ方を変えていませんでした。撤回後の13,252件の引用文脈のうち、撤回に触れていたのは5.4%(722件)だけでした [4]。
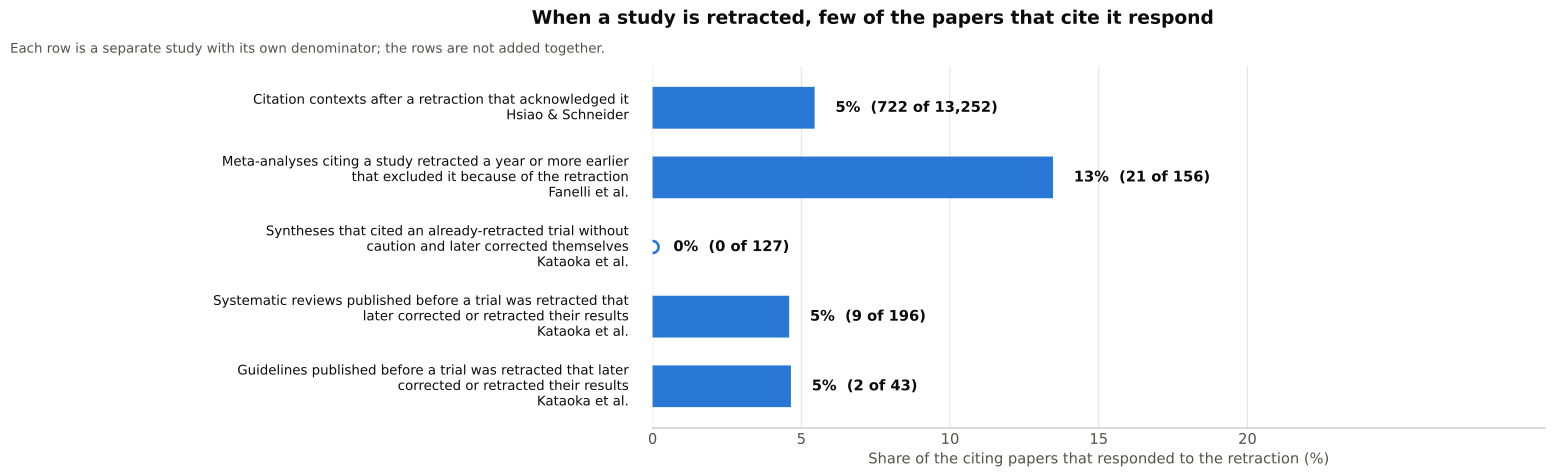
各行は別々の研究で分母もそれぞれ異なるため、行どうしは足し合わせない。白抜きの印は実測値のゼロを表す。出典:参考文献[4]、[10]、[11]。
この損失はたどることができます。Steven Greenbergは、封入体筋炎の患者の筋線維にアミロイドβというタンパク質が異常に、かつ特異的に存在するという1つの信念を、242本の論文と675件の引用を通して追跡しました。そのうち10本の論文が、一次データでこの主張を検証していました。4本は主張を支持し、6本は主張を弱めるか反証していました。この10本の論文への214件の引用のうち、94%は支持する4本に向けられていました。彼はまた、引用だけによって仮説が事実になった例も記録しています [19]。
論文そのものが保っているものも、私たちが思っているより少ないのです。Reproducibility Project: Cancer Biologyが、影響力の大きい53本の論文から193件の実験を再現しようとしたとき、出版された論文とその補足資料だけから設計できた実験は1件もなく、どの実験でも追加の確認が必要でした [20]。論文をもう一度開いても、取り戻せるのは書き留められたことだけです。プロトコルの細部が欠けているところでは、監査は、その条件が満たされていたと仮定するのではなく、欠落があることを記録しなければなりません。
人間が書くレビュー論文が(あるいは、抄録を要約する標準的な検索拡張型のAIツールが)、主要な結論だけを読んで50本の論文を詰め込むとき、それは、崩れた前提、選択的な引用、明示されていない条件を、見かけ上のコンセンサスのなかに圧縮してしまいます。Derek Loweが、Davidの欠損タンパク質のプレプリントを論評した際にScience誌で警告したように、科学者のために文献全体を読むと言われているAIシステムには、こうした誤ったブロットが、ほかのあらゆるものと一緒に与えられることになります [5]。正式なシステマティックレビューやメタアナリシスでさえ、一次研究を先に監査せずに統合すれば同じ罠に陥りますし、いまやその数は膨大です。John Ioannidisは、1991年から2014年にかけて、PubMedに収載されたエビデンス統合の研究がどれだけ増えたかを調べました。年間の出版数は、システマティックレビューで2,728%、メタアナリシスで2,635%増え、PubMed全体では153%の増加でした。うつ病に対する抗うつ薬だけでも、2007年から2014年のあいだに185件の別々のメタアナリシスが発表されました。遺伝疫学については、候補遺伝子のメタアナリシスの洪水はほぼすべてが誤解を招くものだと彼は判断しています。断片的で選択的に報告された研究を統合していたからです [6]。
条件を保つパッキング:スクリーニングした論文を、監査済みのエビデンスカプセルに変える
1本の原稿からトピック全体へと規模を広げるときに誤りが積み重なるのを止めるには、パッキングは、圧縮する前に監査されていなければなりません。これが、私たちが構築している設計です。私たちは、論文を平坦なテキストの要約や抄録の埋め込みベクトルとしてデータベースに保存するのではなく、1本の論文を監査する私たちのワークフローを、それぞれの論文を構造化されたエビデンスカプセル(Evidence Capsule)に詰め込むコンパイラとして使います。そのワークフローとは、biomedical-literature-evidenceスキル(検証記録)、academic-peer-reviewスキル(スキルページ、ベンチマーク、PeerJ 20995の盲検査読)、scientific-figure-masterスキル、scientific-writingスキル(リリースノート)、メタアナリシス(meta-analysis)スキル(性能レポート)、メンデルランダム化(Mendelian randomization)スキル(再現レポート)です。これは、4番目の論考のBig-5 compilerであるBig5cと同じ考え方に従っています。レビューを5つの段の上に組み立てる、という考え方です。Big5cはそのレビューをAIエージェントが提案した行動に当てはめ、カプセルのコンパイラはそれを論文に当てはめます。
エビデンスカプセルは、条件を保つ科学的なzipファイルです。論文の書誌的な識別情報と抽出された主張に加えて、その研究の、大五元による5つの検証座標を保存します:
- 第1段:実行のレシート():再計算した検定統計量(
t、F、z、、オッズ比、標準誤差)、正確なサンプルサイズ、そしてパース(構文解析)した物理単位(ug/gはparticles/gと厳密に分けておきます)。 - 第2段:実験の選択の木():主張が拠って立つ、正確な実験上の枝。すなわち、種、系統、性別、年齢または曝露期間、組織の区画、mRNAかタンパク質かという測定値、そして細胞株と抗体です。細胞株と抗体は、Cellosaurusなどの公開データベースと照合します。これは2番目の論考で述べた照合です。
- 第3段:多重性のレシート():その論文が同じ仮説族のなかでいくつの仮説 を検定したか、そして主要な結果がファミリーワイズエラー率または偽発見率の補正を生き残ったかどうか。
- 第4段:層と来歴のタグ():その記述が文書のどのセクションから来たか(
MethodsとResultsは、Introduction、Discussion、Referencesにある文献への言及と分けておきます)、もとになるどの患者コホートまたはデータセットIDが解析されたか、そしてその研究デザインがエビデンスの階層のどこに位置するか。 - 第5段:交絡因子とステータスの台帳():どの交絡因子、陰性対照、多面発現のチェックが実際に実行されたか、どれが
unavailableのままか、そしてその論文またはその主要な参考文献のいずれかに、訂正、懸念表明、撤回通知がついているかどうか。
範囲を絞ったAIノード(それぞれがカスタマイズされたプロンプト、読み込むスキルとコンテキスト、品質管理のためのゲート付きフックを備えています)が、研究デザインの木と主張の候補を明示的なスキーマへと抽出します。決定論的なコードノードは、計算をやり直し、細胞株と単位をチェックし、カプセルの検証状態をロックします。
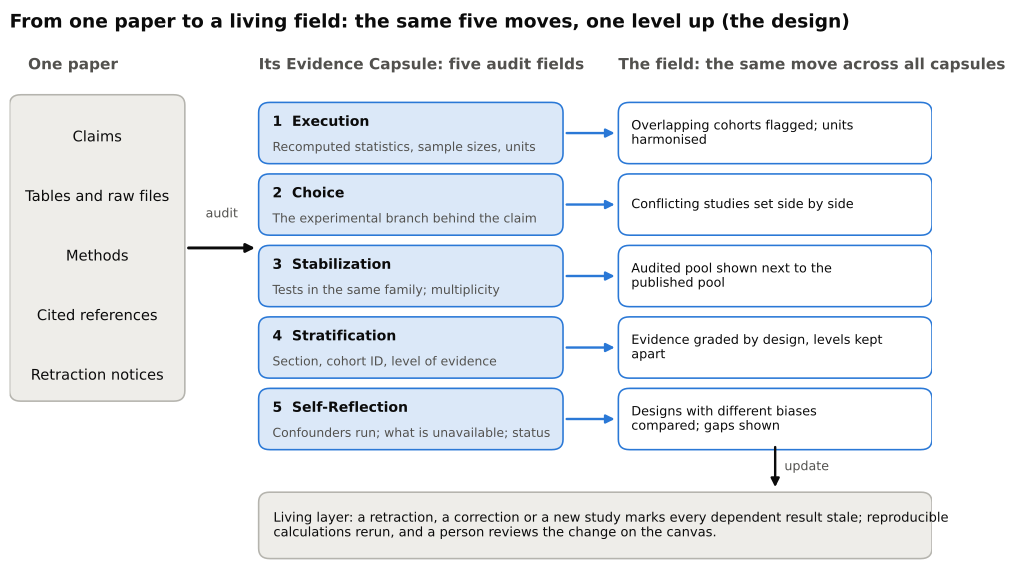
設計図。各カプセルのフィールドは1本の論文についてはしごの1段に答える。同じ段をすべてのカプセルに適用したものが、右側の分野レベルの操作である。
二次の大五元のはしご:分野全体にわたる自動化されたメタサイエンス
4番目の論考で語った物語では、複雑な過程がひとたび検証済みの部品に詰め込まれると、数学者は6番目の考え方を発明したりはしません。新しい土台の上に立ち、同じ大五元のはしご()を1つ上の水準で登るのです。
出版された論文を監査済みのエビデンスカプセルに詰め込むことで、NexitiaとNexitia Core(現在はAROS Coreとして掲載)は、科学者の研究トピックについて同じことができるようになります。研究者が関心のあるトピックを開くと、システムはその分野のすべてのカプセルにわたって、二次の大五元のはしごを登ります:
1. 分野レベルの (実行):コホートの重複排除と単位の統一
2つの研究を比較したり統合したりする前に、決定論的なコードノードが、抽出されたコホートの識別子、募集期間、物理単位をチェックして、それらの研究が独立していて、同じ尺度で比べられるかどうかを確かめます。biomedical-literature-evidenceスキルが備える研究と報告の対応づけを使って、エンジンは1つの研究から出た複数の報告を、その研究に結びつけます。2つの研究が参加者を共有しているかもしれない箇所は、別に記録します。1つの病院レジストリやバイオバンクから出た論文ではよくあることです。そして、解決していない重複は、二重に数えるのではなく、未解決の重複として表示します。エンジンは効果の方向をそろえ、互換性のある尺度を変換しますが、検証済みの換算係数がないかぎり、同じ尺度で比べられない物理単位を統合することは拒みます。
2. 分野レベルの (選択):結論の相互照合と、矛盾の「解凍」
活発な分野ではほとんどどこでも、科学者はいずれ矛盾に出会います。研究室Aはある標的が保護的だと報告し、研究室Bはそれが有害である、または効果が認められないと報告している、というような矛盾です。従来のレビューは、その対立を当たり障りのない1文にならしてしまいます(「結果については依然として議論が分かれている」)。エンジンはまず、2つの結果が同じ問いを扱っていて、本当に食い違っているのかをチェックします。有意な推定値と結論の出ていない推定値は、互いに矛盾しないことがありうるからです。
どのエビデンスカプセルも の実験の選択の木を保存しているので、私たちの分野レベルのエンジンは、カプセルを共有の分岐グラフの上に対応づけ、対立する組をNexitiaのキャンバス上で横に並べて解凍します。科学者が目にするのは、漠然とした論争ではなく、2つの研究室が分かれた正確な枝です:
- 研究室Aは雄のマウスで6週の時点のmRNAを測定し、研究室Bは雌のマウスで24週の時点のタンパク質を測定したのでしょうか。
- 一方の研究はPC-3細胞(内因性のSTAT3を欠いています [3])を使い、もう一方はヒトから直接採取した組織を使ったのでしょうか。
- 一方の疫学研究は4.6年間のランダム化された薬剤曝露を評価し、もう一方は54.9年間の生涯にわたる遺伝的な曝露を評価したのでしょうか [7]。
矛盾を解凍することで、文献上の行き詰まりは、競合する説明を見分けることのできる実験の短いリストに変わります。
3. 分野レベルの (安定化):「統合の前に監査する」リビングな統合
複数のカプセルが同じ定量的な対比を測定しているとき、メタアナリシススキルが、統合効果、異質性()、予測区間、小規模研究バイアスのフラグを計算します。このスキルのRevMan互換のエンジンは、28件のコクランレビューにわたって、統合解析1,061件のうち1,060件、チェック可能な定量的項目11,351件のうち10,797件(95%)を再現しています。
ここで決定的に重要なのは、どのカプセルも1本の論文に対する監査のレシートを携えているので、データベースが2つの統合を並べて計算することです:
- 公表されたままの統合:カプセルのチェックを適用する前の推定値で、出版されたすべての結果を報告されたとおりに受け取ります。
- 大五元で監査した統合:撤回された研究を取り除き、重複するコホートを重複排除し、再計算した 値によって有意性が変わる結果(
statcheckが検出する重大な不整合です [2])に人がチェックするための印をつけ、未解決のまま残る結果を含めた場合と除いた場合の統合結果を示し、互換性のないアッセイを分けたあとに残るものです。
40本の論文による「コンセンサス」が、統合の前に監査するフィルタリングのあとでは、小規模で互いに一致しない2つのヒトのコホートにまで崩れてしまうことがあります。それを早い段階で見ることができれば、研究室は、アーティファクトを追いかけて費やす18か月と研究費の予算を節約できます。
4. 分野レベルの (階層化):階層を分けておくエビデンスの等級づけ
すべてのカプセルが、現実の同じ段の上にあるわけではありません。GRADEの枠組みは、エビデンスの質を研究デザインから出発して評価し、研究の限界、非一貫性、非直接性、不精確さ、報告バイアスがあれば評価を下げ、大きな効果や用量反応勾配があれば評価を上げます [8]。その背後にある原則を当てはめて、私たちの の階層化エンジンは、すべてのカプセルを狭義の半順序の上に置きます:
これは、4番目の論考の順序とは別の順序です。あちらの順序は、それぞれの水準が、なされている主張からどれだけ離れているかを記録するものでした。こちらは、ヒトにおける因果的な主張のための、私たち自身の順序づけです。GRADEからは、研究デザインから出発し、そのうえで欠点に応じてエビデンスの評価を下げ、強みに応じて上げるという考え方を借りています [8]。
層が厳密に分けられているので、検証されていない抗体を使った30本の細胞株の論文が、十分な検出力を持つヒトのコホートや、適切な操作変数を備えたメンデルランダム化研究を、数で押し切ることは決してできません。トピックのそれぞれの問いには、明示的で点検可能なエビデンスの等級がつきます。その等級は、監査のチェックに合格した最上位の層を基準とし、残っている限界に応じて調整されます。
5. 分野レベルの (自己省察):エビデンスのトライアンギュレーションと空白地帯の発見
最先端の生物学や病因疫学では、統合できる同一のランダム化試験が20件もそろっていることはめったにありません。多くの場合、研究者の手元にあるのは、異質なエビデンスの系統です。前向きコホート、メンデルランダム化解析、きょうだい比較、動物での摂動実験、陰性対照研究といったものです。
Lawlor、Tilling、Davey Smithがエビデンスのトライアンギュレーション(三角測量、evidence triangulation)の枠組みで定式化したように、因果関係への確信がもっとも強くなるのは、主要なバイアスの原因が互いに無関係な(そして理想的には推定値を逆方向に偏らせる)複数のアプローチのあいだで結果が一致するときです。たとえば、多変数のコホート回帰(社会経済的な残余交絡に弱い)を、2標本メンデルランダム化(生活習慣による交絡よりも、主に水平多面発現に弱い)やランダム化試験の中間指標と組み合わせ、同時に曝露の期間とタイミングを考慮に入れる、といった場合です [7]。逆に、Lawlorらが、母乳育児とその後の体格指数(BMI)について、コホート、低・中所得国での異なる文脈間の比較、ランダム化された母乳育児推進の試験、陰性対照アウトカム(ネズミやハトが家に入り込んだという親の報告)にわたってトライアンギュレーションを行ったときには、陰性対照と直交するデザインは、コホートで見られた見かけ上の保護的な関連の説明として、社会経済的背景と家庭背景による残余交絡を支持しました [7]。
第5段()で、私たちの分野レベルのエンジンは、私たちのスキルを横断してトライアンギュレーションを実際の手順に落とし込みます。異なる研究デザインの因果的な対比、曝露のタイミング、予想されるバイアスを比較して、それらの結果が1つの矛盾のない説明を支持するかどうかをチェックし、トピック全体を通じてどの交絡因子や多面発現の経路が未検証のまま残っているかに印をつけ、科学的な空白地帯の候補(欠けている実験や、調整されていない交絡因子)をNexitiaのキャンバス上で強調表示します。それらは、grant-write-masterスキル(検証記録、事実保持の記録)や、CohortDAG(リリースノート)とTracyteの解析ワークフローに、そのまま渡すことができます。
コンパイラ式の依存関係の無効化を備えたリビングデータベース
静的な文献データベースは、まとめられたその日から劣化し始めます。Shojaniaらは、ACP Journal Clubに収載された、ランダム化試験の定量的なシステマティックレビュー100件を追跡しました。その57%で、更新が必要であることを示す定量的または定性的なシグナルが現れました。そうなるまでにレビューが生き延びた期間の中央値は、100件全体で5.5年でした。もっと速く古くなったものもあります。23%は出版から2年以内に、15%は1年以内に古くなり、7%は出版されたその日にすでに古くなっていました [9]。
さらに悪いことに、レビューに含まれた試験があとで撤回されても、静的なレビューが自らを訂正することはほとんどありません。Kataokaらは、撤回されたランダム化比較試験を引用していた587件のシステマティックレビューと診療ガイドラインを調べました。そのうち127件は、すでに撤回されていた試験を注意書きなしに引用しており、2022年5月までに自らを訂正したものは1件もありませんでした。別の239件は、試験が撤回される前に出版されたものです。そのなかで結果を訂正または撤回していたのは、システマティックレビューの5%(196件中9件)とガイドラインの5%(43件中2件)だけでした [10]。
こうした引用の多くは避けることができたはずです。Fanelli、Wong、Moherは、2013年から2016年のあいだに出版され、撤回された研究を引用していた229件のメタアナリシスを調べました。そのうち156件(68%)では、引用した側のメタアナリシスが出版される少なくとも1年前に撤回が行われていましたが、その156件の避けられたはずの引用のうち、撤回を理由にその研究を除外していたのは21件(13%)だけでした [11]。
そして、Bakker、SchneiderらがBMJ Evidence-Based Medicineで指摘しているように、撤回された論文を1本取り除いても、ほとんどのメタアナリシスの結果はおおむね変わりませんが、欠陥のあるデータや捏造されたデータは結論を変えることがあります。欠陥のある2つの研究を除外すると、イベルメクチンがCOVID-19の死亡率を下げたという、ある出版済みレビューの知見は成り立たなくなりました。また、データ捏造の影響を受けた1件の試験を除外すると、アピキサバンの22件のメタアナリシスで、解析の半数以上が変わることになります [12]。
これを解決するために、Elliott、Higginsらはリビングシステマティックレビュー(living systematic review)を提案しました。これは継続的に更新されるオンラインの統合で、文献検索が、質の評価、データ抽出、メタアナリシスへと絶えず流れ込みます。彼らは、繰り返しの更新が生みうる偽陽性を扱うための、逐次的な手法とベイズ的な手法についても論じています [13]。
私たちのデータベースのアーキテクチャは、このリビングレビューを、科学者が購読するトピックを中心に構築された、コンパイルされた依存関係グラフに変えます:
- 継続的な取り込みとパッキング:研究者や研究室がNexitiaでウォッチしているトピックごとに、システムはPubMed、Europe PMC、Crossrefで新しく出版された論文とプレプリントを監視し、全文を読める新しい研究をそれぞれ監査済みのエビデンスカプセルにコンパイルし、抄録だけのレコードは未確認として保持し、その両方をトピックのグラフに結びつけます。
- コンパイラ式の依存関係の無効化:データベース内のすべての統合推定値、エビデンスの等級、トライアンギュレーションの矢印は、もとになるエビデンスカプセルへの明示的な依存パス(
bound_paths)を記録しているので、データベースはソフトウェアのビルドシステムのように振る舞います。上流の論文がCrossref/Retraction Watchで撤回または訂正された場合や、新しい監査のチェックが試薬や統計の欠陥に印をつけた場合には、そのカプセルに依存する下流の統合ノードはすべて、自動的に「古くなった」と印づけられます。新しく出版された研究が、あるトピックの適格な研究の集合に入った場合も、そのトピックの統合に同じことが起こります。そのあと、再現可能な計算は再実行され、判断を要する決定は人に戻されます。 - シグナルで絞り込んだ人への通知:研究者を毎日の論文アラートであふれさせるのではなく、リビング台帳は、新しく詰め込まれた研究や上流の無効化が、事前に定めた更新の境界を越えたとき、統合推定値やその不確実性を実質的に変えたとき、エビデンスの等級を変えたとき、あるいは解凍された矛盾を解決したときに、キャンバス上で(AXIOのような下流の視覚的なツールも含めて)人間の科学者に通知します。また、3番目の論考で述べた共有ブレインのフェデレーションとMCPサーバー(ホワイトペーパー、プライバシーポリシー、キュレーションされた交換の場)を通じて、1つの研究室がキュレーションした検証済みのカプセルのグラフを、再利用可能な科学的資産として共有できるので、次の研究者が同じ300本の論文を一からスクリーニングし直す必要は決してなくなります。
科学者が中心にとどまる理由
このアーキテクチャは、私たちのアプローチが、この2年間に現れた汎用の「AIサイエンティスト」パイプラインとどう違うのかも明らかにします:
- 抄録やトリプルを要約するのではなく、統合の前に生の成果物を監査する:抄録を要約したり、テキスト中の文レベルの矛盾に印をつけたり、論文を平坦な
(Subject, Predicate, Object)の知識グラフのトリプルに還元したりする検索拡張型の文献ツールは、出版された文章に含まれる誤りをそのまま引き継ぎます。エビデンスカプセルは、数値が1つでも統合に入る前に、出版された表、入手できる.xlsxの補足資料と.docxのグラフキャッシュ、多重性の上限、細胞株の遺伝学的情報 [3]、statcheckの算術 [2]、撤回通知 [4] を監査し、必要な入力が欠けていたチェックがどれかを記録します。 - 論文ごとに新しいスクリプトを即興で書くのではなく、検証済みのワークフローノードを実行する:言語モデルに新しい解析コードを一から書かせるエンドツーエンドの論文生成システムは、データリークのバグや図と本文の矛盾を隠したまま、人間の読み手には説得力があるように見える原稿を作り出すことがあります。Yamadaらは、The AI Scientist-v2による3本の自律生成の原稿を、ICLR 2025のワークショップの査読に投稿しました。3本のうち1本が通過し、そのスコアは6.33で、投稿の上位45%に入りました。残りの2本は不採択でした。さらに悪いことに、著者たちはそのあと、採択された論文を監査しました。その合成データ生成器を再実行すると、テスト項目の約57%が訓練セットにも現れていることがわかりました。図3のキャプションは検証データでの損失の傾向を誤って述べており、本文は2つのアーキテクチャを同等としていましたが、図5では一方が上回っていました [14]。私たちのアーキテクチャ(最初の論考、2番目の論考)では、エージェントは、点検されていないスクリプトを即興で書くのではなく、決定論的なコードノードと、研究を監査するAIエージェントのワークフローを組み合わせます。
- モデルにモデルを採点させるのではなく、GUIのキャンバス上で、決定論的なソフトウェアと人間の専門家によるレビューを組み合わせる:ある言語モデルが別のモデルのアイデアを判定する内部の討論ループは、実証的な検証や専門知識の代わりにはなりません。79人のNLP研究者が研究アイデアを採点した盲検の研究では、テストされた言語モデルの評価器はどれも、専門家どうしが一致する割合(56.1%)よりも低い割合(43.3%から53.3%)でしか、専門家の順位づけと一致しませんでした [15]。Nexitiaでは、ソフトウェアが決定論的な算術とデータベースの規則を強制し、人間の科学者が、人間にとって使いやすいGUIを使って、ツールのキャンバス上でエージェントの選択をレビューします。
自動化された統合エンジンの中心に、なぜ人間の科学者を置き続けるのでしょうか。それは、実物を相手にする生物学と臨床医学が、計算資源だけでは縮めることのできない時計の上で動いているからです。Wong、Siah、Loは、産業界の41,040件の医薬品開発パス(15,102種類の薬剤を、試験された疾患ごとに1回ずつ数えたもの)を使って、第1相からの承認確率を13.8%と推定しました [16]。しかも、それぞれのパスには、何年ものウェットラボでのアッセイと臨床での追跡が必要です。既存の実証データセットを横断する純粋なin silicoの探索(メンデルランダム化スキルでのヒトの遺伝的操作変数、メタアナリシススキルでの試験の表、CohortDAGでの臨床コホート、Tracyteでのシングルセルアトラス)は、ウェットラボの実験台での数か月ではなく、数時間から数日で実行できます。そのため私たちは、研究者が2か月のサイクルで10個ほどのドライラボの仮説を検証でき、実験台での実験を、監査の5つの段すべてを生き残ったシグナルのためにとっておけるようになると予想しています。
ドライラボでの探索が速くなると、ボトルネックは、候補を生成することから、それを検証し消化することへと移ります。Terence Taoが2026年の国際数学者会議での講演の文章版で述べたように、欠乏の時代からAIによる豊富さの時代へ移ると、問題を解くことの背後にある5つの段階、すなわち生成、検証、解説、コミュニティによる受容(消化)、決定版の理論への正典化があらわになり、機械による生の解が、人間の専門家が検証し、説明し、消化できるよりも速く積み上がるときにはいつでも、彼が「証明の消化不良」と呼ぶものが生じます [17]。OpenAIが2026年10月に、350を超える成果に含まれる722の解決済みの数学の問題を一括で公開したことは、この問題を示しています。Taoが読んだ10本ほどの論文のうち、1本か2本には本当に巧妙な新しいアイデアが含まれていましたが、1本か2本はすでに誤りのために取り下げられていました [18]。Taoは、ある結果を明確で公開された科学的な解説として最初に提示した著者に優先権を与えること、証明を少なくとも出版の段階まで仕上げることを、功績を認める条件とすること、そして結果を検証し消化する人々のほうへ威信を移すことを提案しています [18]。数学と同じく実証的な生物学でも、AIシステムが網羅的な計算と文献のスクリーニングを引き受けるにつれて、人間の科学者の主要な責任の1つは、正しい問いを立て、AIの前提を監査し、密度の高い定量的な出力を、同僚が理解し検証できる明確な生物学的説明へと翻訳することになります。私たちは、この人間とAIによる検証のワークフローを、研究協力者とともに開発しています。協力者の参加は、3つの入力を通じて、エンジンとリビングデータベースの両方を直接つくり上げていきます:
- 関心のあるトピック(科学的なセンス)がデータベースの種になる:計算資源は4万個の遺伝子をチェックできますが、どの生物学的なパラドックスや臨床上のボトルネックが重要なのかを判断する科学的なセンスは持っていません。協力者がウォッチしたいトピックを選ぶと、それらの問いが、Nexitia上の私たちのリビングなエビデンスカプセルのデータベースの、礎となるトピックグラフを形づくります。
- 独自のアイデアが因果のトライアンギュレーションを導く:協力者は、直交するドライラボのデータセットを横断して探究すべき機序の仮説やパラドックスを持ち寄り [7]、矛盾の解決が次の研究やgrant-write-masterスキルでの次の研究費申請を変えるような問いへと、エンジンを向かわせます。
- レビューのコメントが検証ノードを改良する:協力者がNexitiaのキャンバス上で原稿やエビデンスカプセルの統合を監査し、微妙な生物学的交絡因子、アッセイのアーティファクト、解釈上のギャップを見つけたとき、その批評は1本の論文を直す以上の働きをします。研究者は、そのチェックをカスタムノード(どのような状況に対しても、研究者自身のコードを保持するノードです)に組み込んだり、scientific-writingスキルやacademic-peer-reviewスキルのAIノード(カスタマイズされたプロンプト、読み込むスキルとコンテキスト、品質管理のためのゲート付きフックを備えています)を改良したりして、そのノードに名前と説明をつけ、自分のエージェントが再利用できるようにすることができます。
Nexitia Core(現在はAROS Coreとして掲載)と共有ブレインのフェデレーションを通じて共有されると、そうしたチェックは、1人の科学者の注意深い読みを、別の研究室が点検して再利用できる規則として、先へ運んでいきます。
参考文献
- Simpson SG (2009). Subsystems of Second Order Arithmetic, 2nd ed. Perspectives in Logic, Cambridge University Press. doi:10.1017/CBO9780511581007. 二階算術 、量化子の交代の複雑さ、5つの主要な部分体系(、、、、)を定義しています。
- Nuijten MB, Hartgerink CHJ, van Assen MALM, Epskamp S, Wicherts JM (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods 48(4): 1205–1226. doi:10.3758/s13428-015-0664-2. 自動化されたRパッケージ
statcheckを8つの心理学誌の30,717本のHTML論文に対して実行し、16,695本の論文からAPA形式の帰無仮説検定258,105件を抽出しました。その16,695本の論文の49.6%(8,273本)に不整合な 値が少なくとも1つあり、12.9%(2,150本)に、有意水準 の閾値をまたぐ重大な不整合が少なくとも1つありました。 - David S (2026). Erroneous reports of protein expression in cell lines with genetic deletions and mutations. Zenodo (21 October 2026). doi:10.5281/zenodo.23498482. 10種類のタンパク質にわたってホモ接合性欠失または両アレル性の不活化変異が確認されている、よく使われる20種類の細胞株を、Cellosaurus、Human Protein Atlas、Cell Model Passports、GEOのシーケンシングデータと照合し、一人で行った検索で、221本の出版論文にわたる230件の誤ったウェスタンブロット報告を見つけました。
- Hsiao T-K, Schneider J (2021). Continued use of retracted papers: temporal trends in citations and (lack of) awareness of retractions shown in citation contexts in biomedicine. Quantitative Science Studies 2(4): 1144–1169. doi:10.1162/qss_a_00155. 撤回された7,813本のPubMed論文、169,434件のiCiteの引用、PubMed Central Open Access Subsetにある48,134件の本文中の引用文脈を分析しました。撤回は論文の引用のされ方を変えず、撤回後の13,252件の引用文脈のうち、撤回に触れていたのは5.4%(722件)だけでした。
- Lowe D (2026). The case of the should-be-missing proteins. Science, In the Pipeline, 21 October 2026. https://www.science.org/content/blog-post/case-should-be-missing-proteins. Davidのプレプリントについての論評で、230例の誤ったウェスタンブロットが一人によって221本の論文で見つかったことを指摘し、出版された文献を統合するために作られたAIシステムがこれらの誤りを取り込むことになると警告しています。
- Ioannidis JPA (2016). The mass production of redundant, misleading, and conflicted systematic reviews and meta-analyses. The Milbank Quarterly 94(3): 485–514. doi:10.1111/1468-0009.12210. 1986年から2015年までのPubMedの収載状況と実証的な評価を概観しています。1991年から2014年にかけて、年間の出版数はシステマティックレビューで2,728%、メタアナリシスで2,635%増え、PubMedの全項目では153%の増加でした。これには、2007–2014年のうつ病に対する抗うつ薬のメタアナリシス185件や、断片的でバイアスのある一次研究を統合した候補遺伝子のメタアナリシスの広がりが含まれます。
- Lawlor DA, Tilling K, Davey Smith G (2016). Triangulation in aetiological epidemiology. International Journal of Epidemiology 45(6): 1866–1886. doi:10.1093/ije/dyw314. 因果のトライアンギュレーションを、主要なバイアスの原因が互いに無関係な(理想的にはバイアスの方向が逆の)少なくとも2つのアプローチのあいだで、曝露の期間とタイミングを考慮しながら結果を比較することと定義しています。例として、収縮期血圧と冠動脈性心疾患(4.6年のRCT、13.2年のコホート、54.9年の遺伝的操作変数研究)、母体の空腹時血糖と出生体重、母乳育児とその後のBMI(陰性対照アウトカムが残余交絡を明らかにした例)を取り上げています。
- Guyatt GH, Oxman AD, Vist GE, Kunz R, Falck-Ytter Y, Alonso-Coello P, Schünemann HJ; GRADE Working Group (2008). GRADE: an emerging consensus on rating quality of evidence and strength of recommendations. BMJ 336(7650): 924–926. doi:10.1136/bmj.39489.470347.AD. エビデンスを4つの質の水準(高、中、低、非常に低)に層別するGRADEシステムの概要を示しています。研究デザインから出発し、研究の限界、非一貫性、非直接性、不精確さ、報告バイアス、効果の大きさ、用量反応勾配に応じて修正します。
- Shojania KG, Sampson M, Ansari MT, Ji J, Doucette S, Moher D (2007). How quickly do systematic reviews go out of date? A survival analysis. Annals of Internal Medicine 147(4): 224–233. doi:10.7326/0003-4819-147-4-200708210-00179. ランダム化試験または準ランダム化試験の定量的なシステマティックレビュー100件(中央値で13件の研究、2,663人の参加者)の生存時間解析です。57%で更新を要する定量的または定性的なシグナルが生じ、生存期間の中央値は5.5年でした。一方で、23%は2年以内に、15%は1年以内に古くなり、7%は出版日までに古くなっていました。
- Kataoka Y, Banno M, Tsujimoto Y, Ariie T, Taito S, Suzuki T, Oide S, Furukawa TA (2022). Retracted randomized controlled trials were cited and not corrected in systematic reviews and clinical practice guidelines. Journal of Clinical Epidemiology 150: 90–97. doi:10.1016/j.jclinepi.2022.06.015. 撤回されたRCTを引用していた587件のシステマティックレビュー(525件)と診療ガイドライン(62件)のメタ疫学研究です。すでに撤回されていたRCTを注意書きなしに引用していた127件の統合研究のうち、出版後に自らを訂正したものは0件でした。RCTの撤回前に出版された239件の統合研究のなかで、結果を訂正または撤回していたのは、システマティックレビューの5%(196件中9件)とガイドラインの5%(43件中2件)だけでした。
- Fanelli D, Wong J, Moher D (2022). What difference might retractions make? An estimate of the potential epistemic cost of retractions on meta-analyses. Accountability in Research 29(7): 442–459. doi:10.1080/08989621.2021.1947810. 2013–2016年に出版され、撤回された研究を引用していた229件のメタアナリシスを調べました。撤回の68%は、引用した側の統合研究が現れる少なくとも1年前に行われており、そうした避けられたはずの引用のうち、撤回を理由にその研究を除外していたのは13%(156件中21件)だけでした。撤回された研究を統合に含めていた50件のメタアナリシスでは、それを取り除いても要約推定値は平均してほとんど変わらず、撤回がデータや結果に関わるものだった場合には変化がより大きくなりました。
- Bakker C, Boughton S, Faggion CM, Fanelli D, Kaiser K, Schneider J (2024). Reducing the residue of retractions in evidence synthesis: ways to minimise inappropriate citation and use of retracted data. BMJ Evidence-Based Medicine 29(2): 121–126. doi:10.1136/bmjebm-2022-111921. 撤回された研究がエビデンス統合のなかに残り続ける理由(データベースでのタグづけの不統一、撤回までの平均33か月の遅れ、レビューのワークフローに撤回が伝わらないこと)を概観し、欠陥のあるデータや捏造されたデータを除外すると結論が変わった事例を記録しています。そのなかには、COVID-19に対するイベルメクチンの死亡率に関する知見や、アピキサバンの22件のメタアナリシスにわたる解析の半数超が含まれます。
- Elliott JH, Turner T, Clavisi O, Thomas J, Higgins JPT, Mavergames C, Gruen RL (2014). Living systematic reviews: an emerging opportunity to narrow the evidence-practice gap. PLoS Medicine 11(2): e1001603. doi:10.1371/journal.pmed.1001603. リビングシステマティックレビューを提案しています。これは継続的に更新されるオンラインの統合で、継続的な検索、半自動のスクリーニング、構造化されたリンクトデータのリポジトリに支えられます。検討中の選択肢として、繰り返しの更新にわたる偽陽性を扱うための逐次的またはベイズ的な手法も挙げています。
- Yamada Y, Lange RT, Lu C, Hu S, Lu C, Foerster J, Clune J, Ha D (2025). The AI Scientist-v2: workshop-level automated scientific discovery via agentic tree search. arXiv:2504.08066. 3本の自律生成の原稿をICLR 2025のワークショップの盲検査読に投稿しました。構成的正則化についての否定的な結果を報告した1本の論文は6.33のスコア(上位45%、採択の閾値を上回る)を得ましたが、著者たち自身がそのコードと本文を監査したところ、57%の訓練・テスト間の重複、不正確な図3のキャプション、図5と矛盾する本文が見つかりました。
- Si C, Yang D, Hashimoto T (2024). Can LLMs generate novel research ideas? A large-scale human study with 100+ NLP researchers. arXiv:2409.04109; ICLR 2025. 49人の専門家がアイデアを書き、79人の専門家が査読した盲検の研究です(298件のレビュー)。テストされたLLMの評価器はどれも、専門家との順位づけの一致度(43.3%から53.3%)が、専門家どうしの一致度(56.1%)より低くなりました。
- Wong CH, Siah KW, Lo AW (2019). Estimation of clinical trial success rates and related parameters. Biostatistics 20(2): 273–286. doi:10.1093/biostatistics/kxx069. 2000年から2015年までの、21,143種類の化合物を対象とする406,038件の臨床試験記録を、パスごとに分析しています。すべての適応症にわたって第1相に入った産業界の41,040件の開発パス(15,102種類の薬剤)のうち、推定13.8%が最終的に規制当局の承認に至りました。
- Tao T (2026). Mathematics in the age of AI. Proceedings of the International Congress of Mathematicians 2026 (submitted); arXiv:2608.16753. 数学の問題解決を5つの段階(証明の生成、検証、解説、コミュニティによる消化と受容、決定版の理論への正典化)に分解し(Goal 6.5、Figure 4)、証明の欠乏からAIが駆動する証明の豊富さへの移行が、生成が人間による検証、解説、査読を追い越すときに、どのように「証明の消化不良」を生み出すかを分析しています。
- Tao T (2026). Terence Tao on AI in mathematics (and beyond): a living, curated summary of my current thinking on AI, with a companion interview (updated 2 November 2026). https://teorth.github.io/tao-web/ai-views.html. Leanによる形式検証についてのTaoの講演と論評、証明が欠乏していた「Math 1.0」のあとの、証明が豊富な時代に向けて彼が提案するプログラム「Math 2.0」、OpenAIが2026年10月に350を超える成果にわたる722の解決済みの問題を一括で公開したこと、そして、結果を責任をもって扱い、検証し、出版の水準まで説明する研究者に優先権と科学的なクレジットを与えるという彼の提案をまとめています。このページは、AIアシスタント(Claude)がTaoの公開された文章、講演、インタビューをもとにまとめて起草し、そのあと彼が確認・修正したものだと自ら述べています。
- Greenberg SA (2009). How citation distortions create unfounded authority: analysis of a citation network. BMJ 339: b2680. doi:10.1136/bmj.b2680. 封入体筋炎におけるアミロイドβについての1つの主張をめぐる、242本の論文と675件の引用を地図にしています。一次データを含む10本の論文への214件の引用のうち、94%は主張を支持する4本に向けられ、主張を弱めるか反証する6本が受けたのは6%でした。この研究は引用を分類するもので、主張が正しいかどうかは検証していません。
- Errington TM, Denis A, Perfito N, Iorns E, Nosek BA (2021). Challenges for assessing replicability in preclinical cancer biology. eLife 10: e67995. doi:10.7554/eLife.67995. 影響力の大きいがん生物学の論文53本からの193件の実験のうち、論文とその補足資料から、追加の確認なしに設計できたものは1件もありませんでした。23本の論文からの50件の実験が完了しました。
私たちの記録:
- Biomedical Literature Evidence 1.0.0-public.1 検証記録:19個のunittestメソッドが合格。重複するコホートの論文から研究を区別。RISとCSL-JSONのレコード3件中3件を未確認として保持。合成の「完了したが証拠不十分」の台帳チェック(
completed: true, support_ready: false)。 - Mendelian randomization 1.0.0-public.2 再現レポート:Walker et al. 2019 v2、ケース2(アーカイブされた163行のうち157行を保持、主要な結果セル19個中19個が一致、本文とTable 4の食い違いを記録)。
- Meta-analysis 1.0.0 性能レポート:オープンアクセスのコクランレビュー28件、統合解析1,061件のうち1,060件、チェック可能な定量的項目11,351件のうち10,797件を再現(95%)。
- Scientific Figure Master 1.1.2 スキルページ:20件の実際のキャプションにわたって、採点対象のキャプション項目61個中61個が正解。再計算した がキャプションと矛盾するときには、有意性の星印を描きません。
- Grant Writing Master 7.0.0-public.1 検証記録と事実保持の記録:有意でなかったパイロット試験の結果()と非因果的な言い回しを、改訂や言語をまたいで保持。
- Scientific Writing 1.1.0 リリースノート:原稿の改訂の完全な比較と、別建ての編集上の判断の記録、および数値のソース表との照合。
- Academic Peer Review 1.0.2 スキルページ、ベンチマーク、PeerJ 20995の盲検査読:60件の公開査読からの1,035件のコメントに照らして較正。盲検の投稿原稿で、行単位の査読者の指摘49件のうち6件を捉え、v1からv2への変更9件のうち5件を要求。
- CohortDAG 0.2.0 リリースノート、Tracyte、AXIO:検証済みのワークフローノードと、視覚的なキャンバスでの点検。
- Nexitia Core(製品ページではAROS Coreとして掲載)、共有ブレイン統計、AROSのホワイトペーパー、プライバシーポリシー、MCPサーバー、キュレーションされた交換の場:フェデレーションによる手続き記憶、コンテキストの段階的な開示、ワークフローの交換。トピック単位のリビングなエビデンスカプセルのデータベース(公開記録はまだありません)。