下载 CohortDAG
由 nexitia.ai 直接分发。每个链接都是为您的组织生成的私有限时下载链接。
安装前须知:辅助配置运行环境
- 经过验证的 0.2.0 Windows 版本需要 Windows x64
- 经过验证的 0.2.0 Mac 版本需要搭载 Apple 芯片的 macOS 15 或更高版本;不支持 Intel Mac
- x64 Linux;0.2.9 在 Ubuntu 22.04 上构建并安装,并在干净的 Ubuntu 24.04 容器中完成冒烟测试(0.2.4 已在 Ubuntu 22.04 上验证);Debian 和 Ubuntu 可通过 apt-get 和桌面授权进行辅助修复
- 首次运行配置运行环境时需要联网
- 约 2 GB 可用空间,用于独立的分析环境
在 macOS 上,CohortDAG 会复用已安装且兼容的原生 Python 3.12 和 Java 17;如果没有,会在您允许后,直接从各上游项目获取固定版本的原生构建,放入当前用户的 Application Support 目录。默认流程不需要 Homebrew,不需要管理员权限,也不会修改 shell 配置文件。
在 Windows 上,请使用 EXE 安装程序。如果后端环境不完整,请选择 Repair automatically,等待修复回执出现后,再选择 Retry Backend。只有在仍有可执行的修复步骤时,才会显示修复按钮。
在 Debian 或 Ubuntu Linux 上,请安装 x64 DEB,或运行 x64 AppImage。如果后端不完整,请选择 Repair automatically。CohortDAG 通过 pkexec 调用 apt-get;桌面授权服务可能会请求管理员批准,但 CohortDAG 永远不会接触到您的管理员密码。在没有 apt-get 和 pkexec 的发行版上,请使用安装窗口中显示的手动命令。
首次运行配置期间需要联网。配置完成后,无需联网即可在本地运行分析。Python、Temurin、Apache Spark 及其他分析软件包仍遵循各自上游的许可证,不包含在安装程序中。
本版本需要手动更新。请在本页查看更新,下载适用于您架构的新版本,并在安装前校验其 SHA-256。
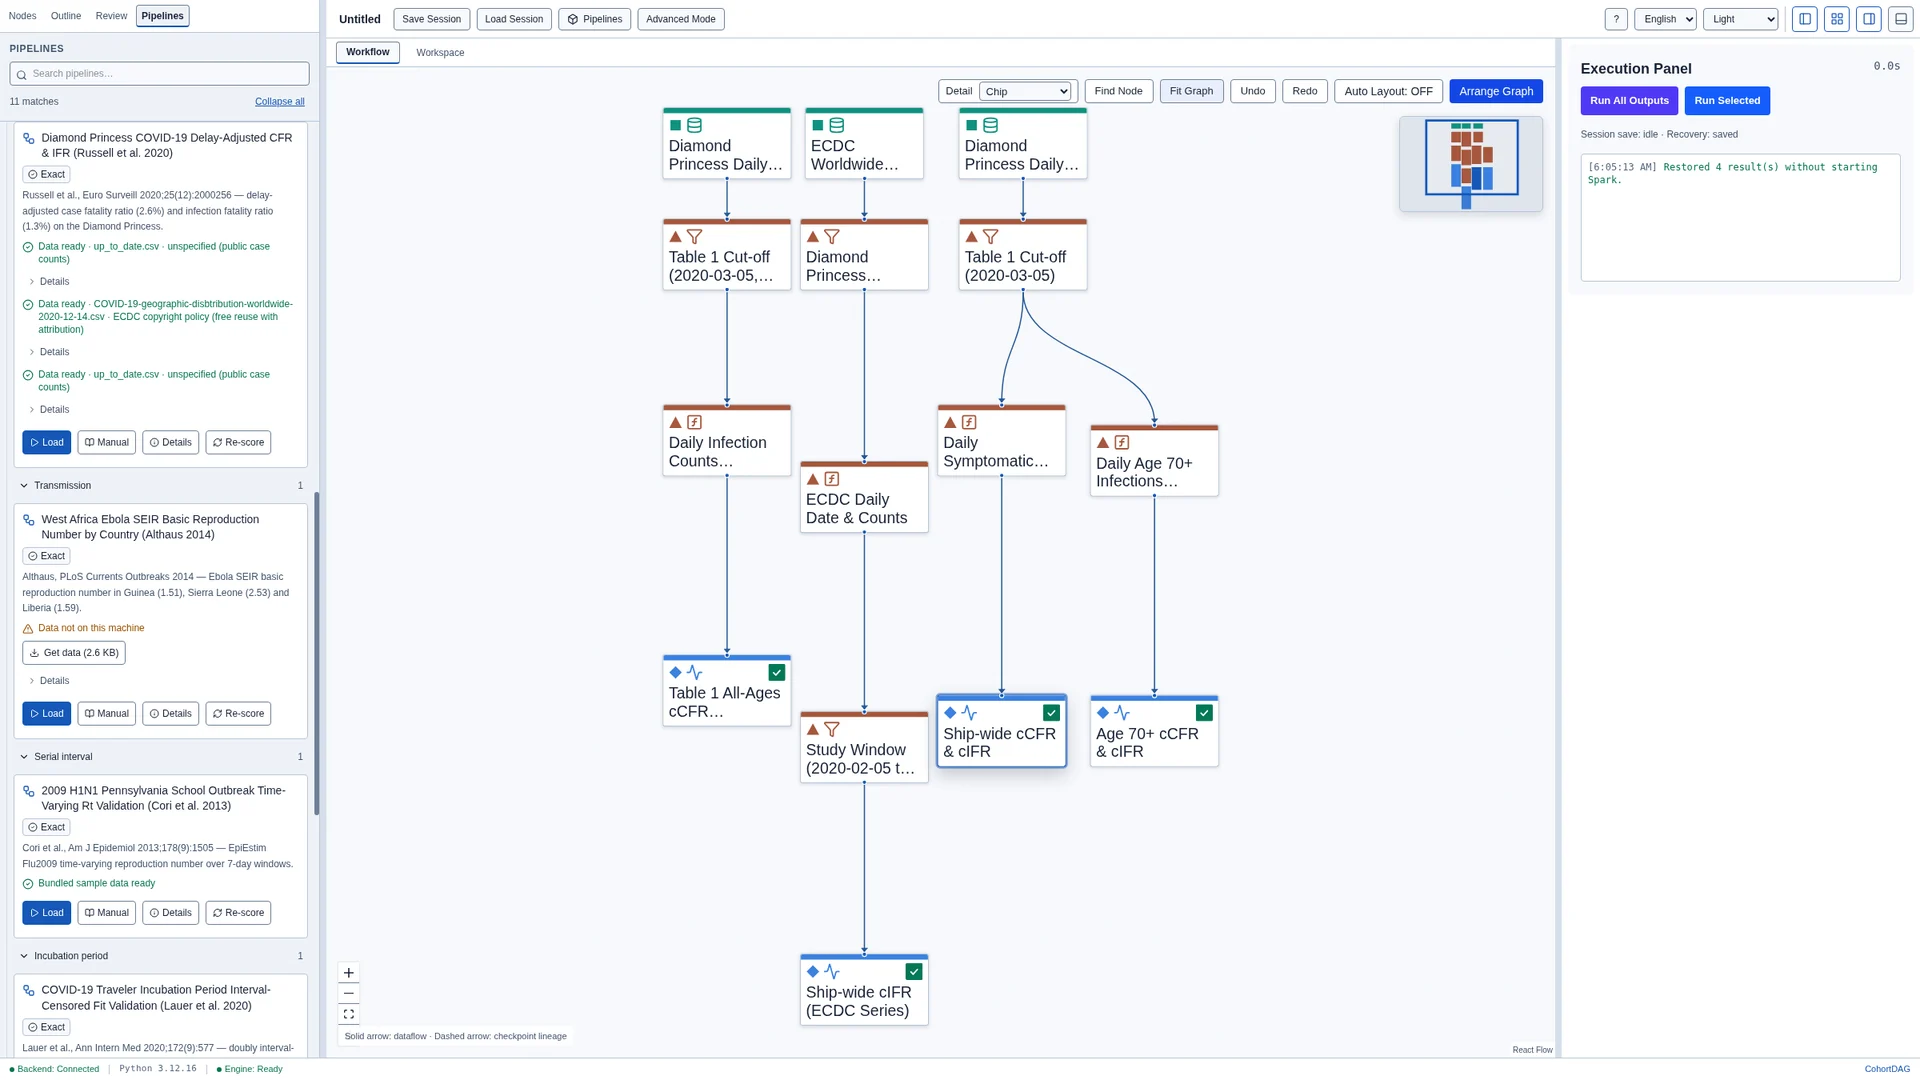
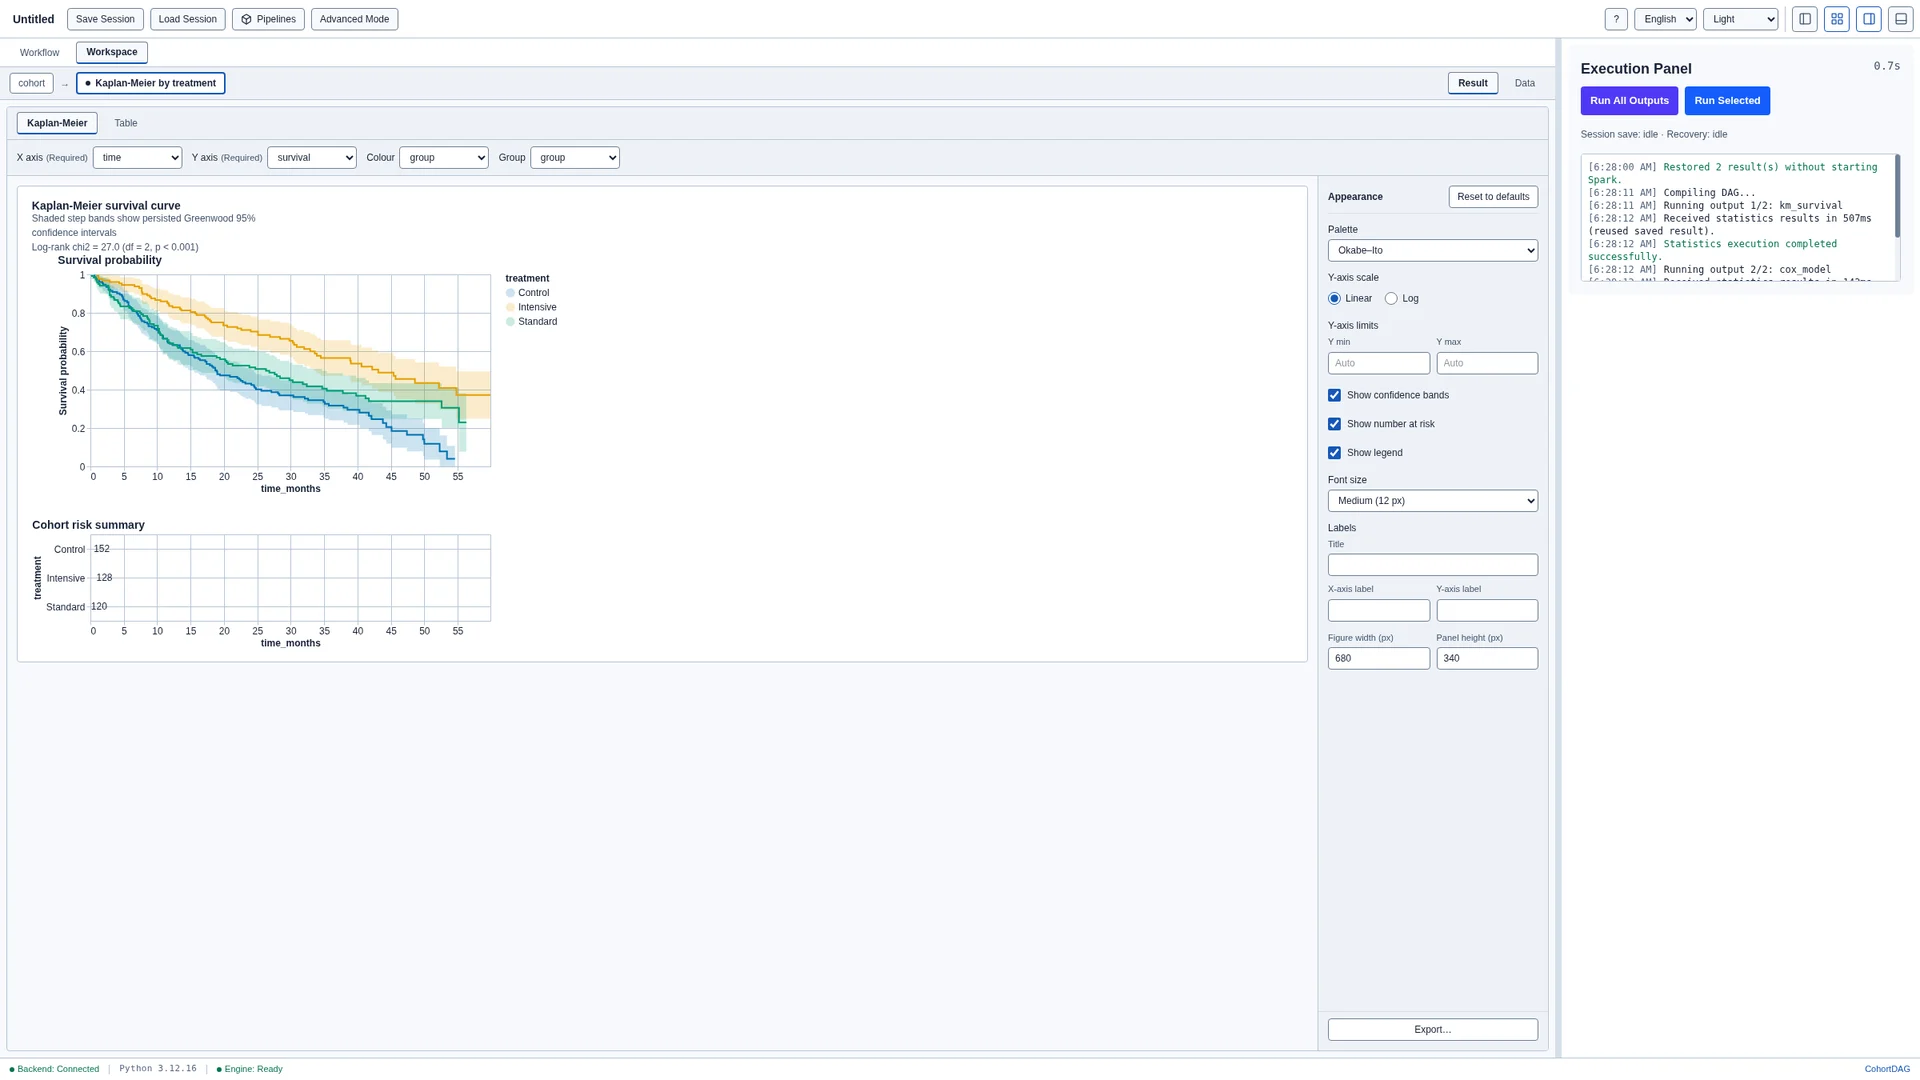
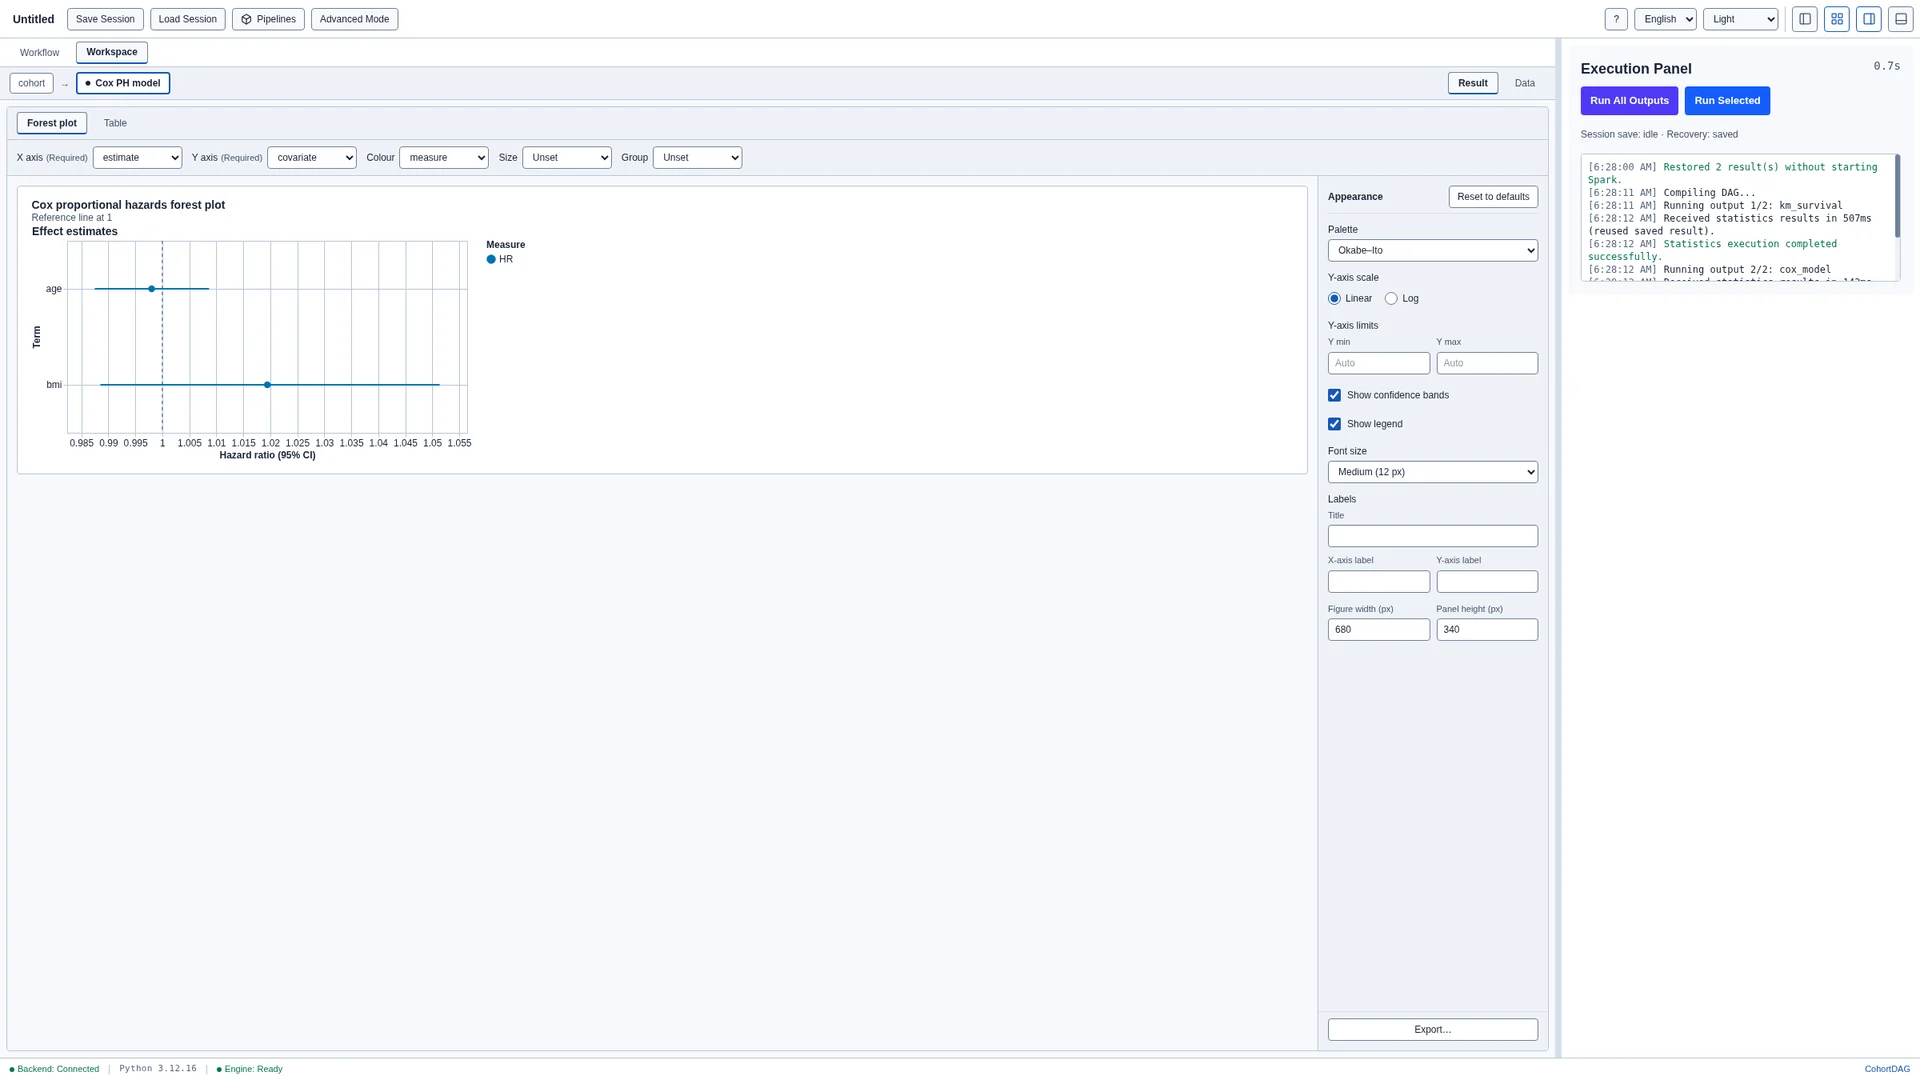
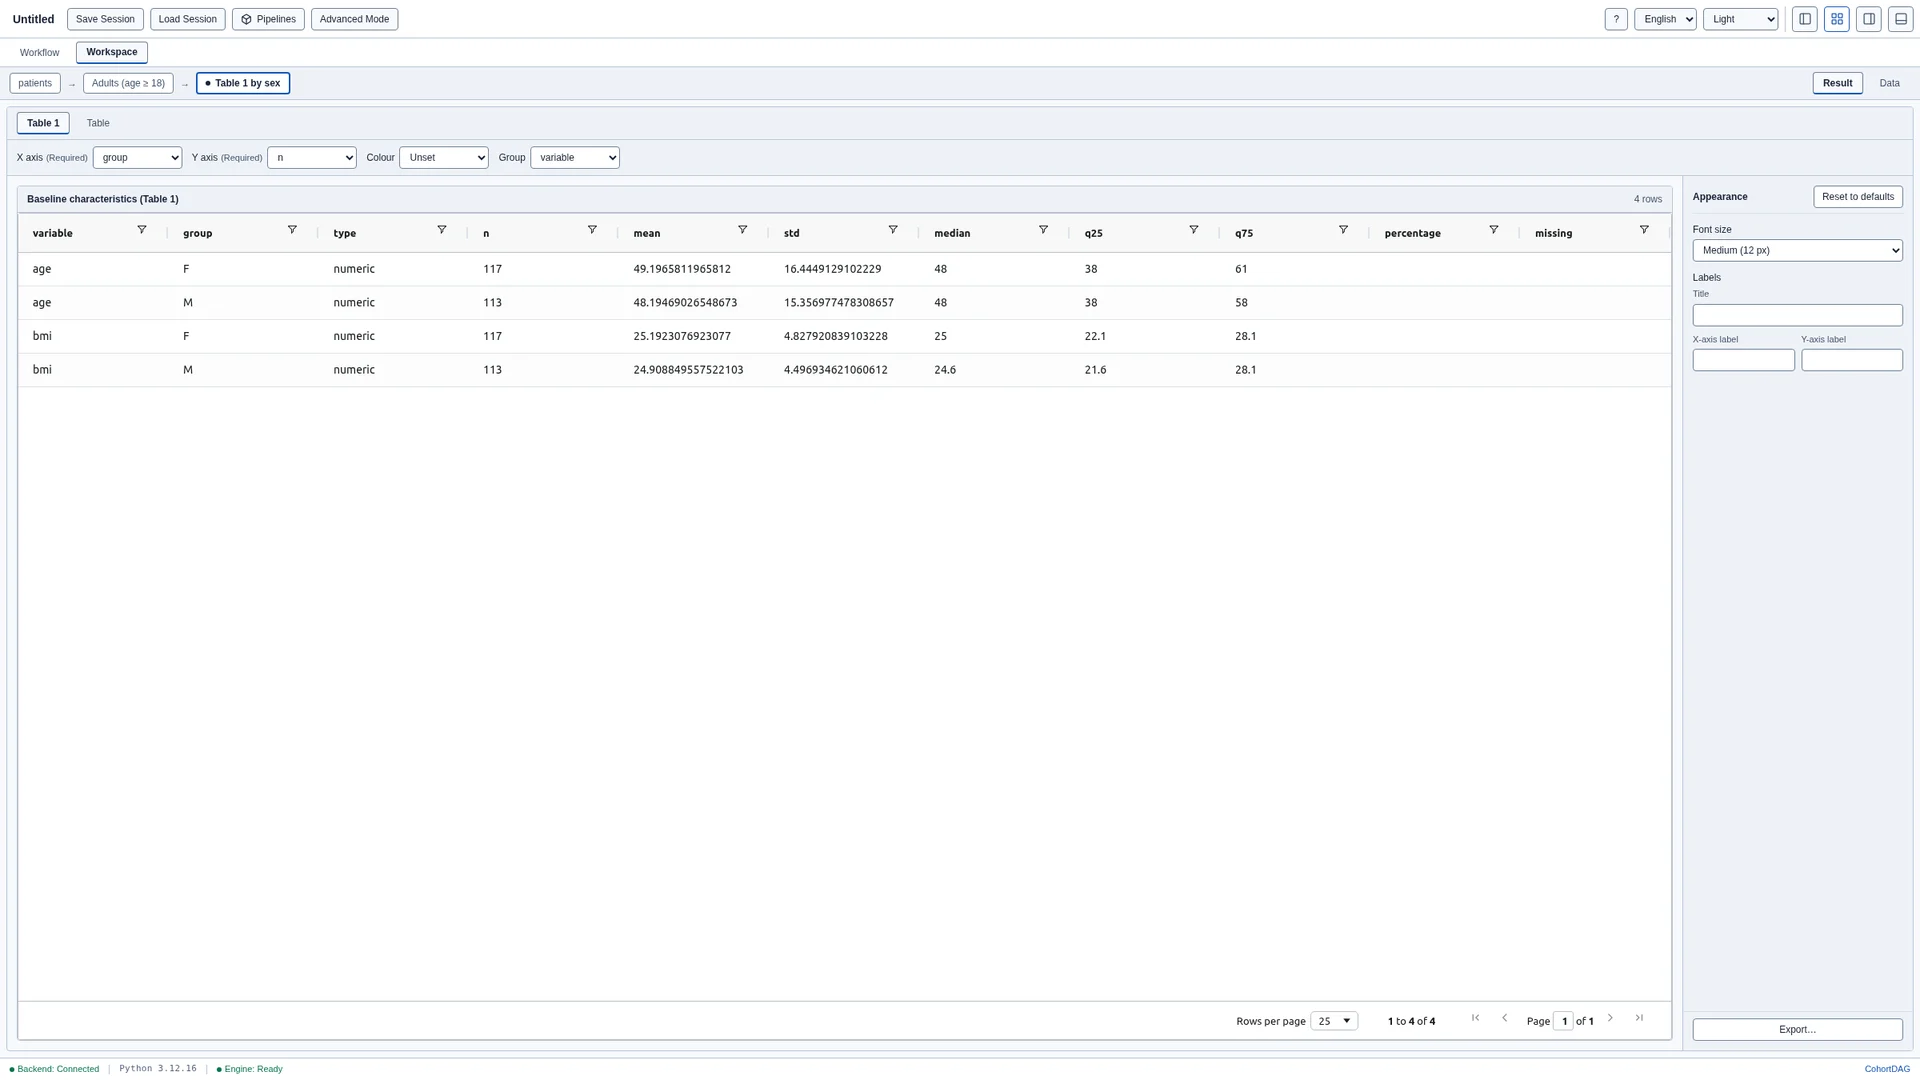
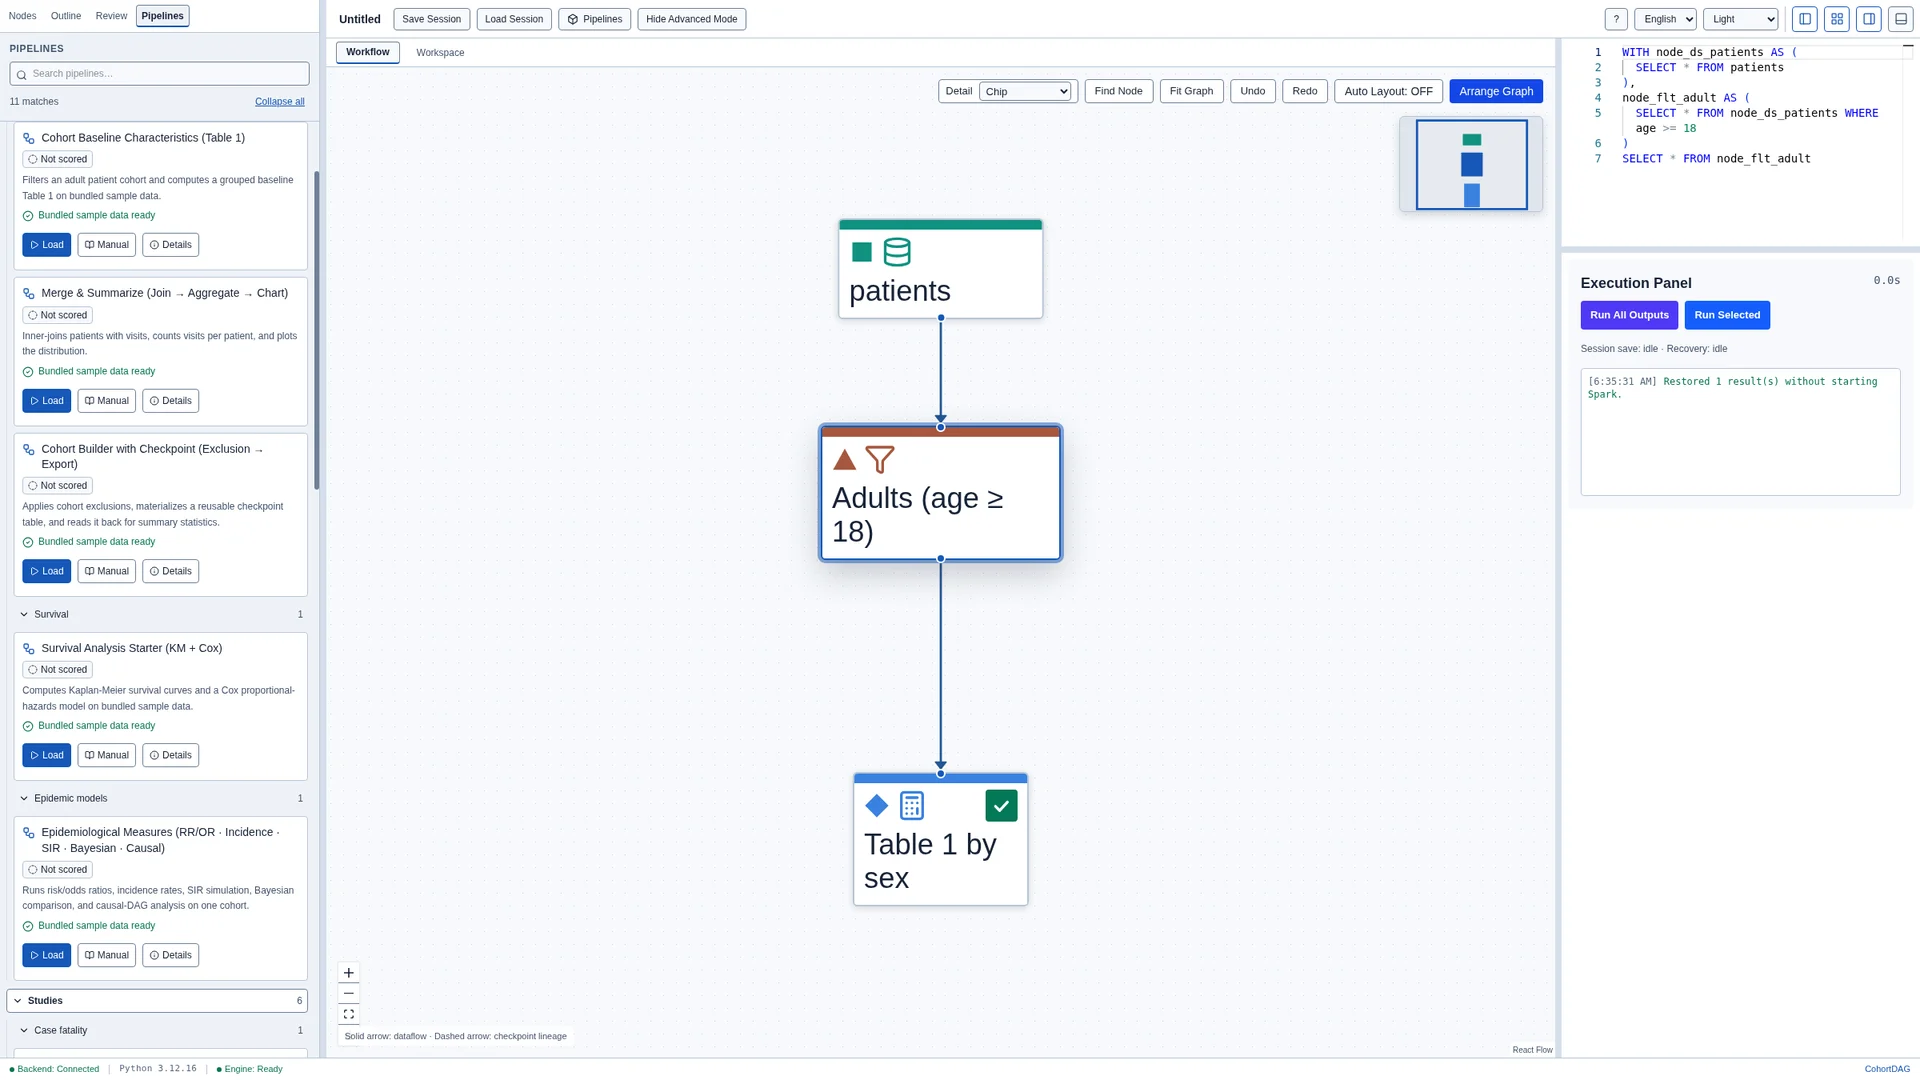
以下截图取自 CohortDAG 0.2.3 教程视频的画面,视频在已发布的 Linux 软件包上录制。文档和教程视频都标明了其制作所依据的版本。
简介
一款基于 Apache Spark、用于临床大数据分析的桌面可视化工作流编辑器。研究人员在画布上把数据源、筛选、表连接和统计节点连接起来;编译器生成 Spark SQL,混合统计引擎计算 Table 1、Kaplan-Meier 曲线、Cox 模型和流行病学指标,所有内容都保存在可移植的 .csp 会话中,重新打开时结果完整保留。
工作原理
智能体编写由节点、边和分析设置组成的 .csp 图。CohortDAG 的编译器和统计引擎用固定的应用代码执行它,应用本身不包含任何语言模型。因此执行过程可检查、可重复;但这并不能证明智能体对变量、SQL 表达式、假设或解读的选择是正确的。研究人员仍需审核分析及其结果。
flowchart LR
  A["导入数据<br/>CSV、Excel、SAS、SPSS"] --> B["注册数据表"]
  B --> C["在画布上搭建流程:<br/>数据源、筛选、表连接、窗口、<br/>队列排除、统计<br/>(实时预览 Spark SQL)"]
  C --> D["验证并编译为<br/>确定性的 Spark SQL"]
  D --> E["运行"]
  E --> F[("export_data 检查点<br/>parquet,按指纹复用")]
  F --> G["结果:Table 1、Kaplan-Meier、<br/>Cox、发病率与风险比、图表"]
G --> H["保存可移植的 .csp<br/>并内嵌结果"]flowchart TD
subgraph AG["AI 智能体:Claude Code、Codex 或 Antigravity"]
direction TB
R["读取节点词汇表<br/>(list_node_types)"] --> S["以只读方式读取当前会话<br/>(get_session_state)"]
S --> W["编写 .csp:<br/>节点、设置和边<br/>(审核 SQL 和假设)"]
end
U["用户指令"] --> R
W --> V["验证(validate_pipeline)"]
V --> P["编译为确定性的 Spark SQL"]
P --> RUN["运行(run_pipeline / run_statistics)"]
RUN --> CK[("检查点<br/>parquet,按 Merkle 链复用")]
CK --> AU["对照参照结果精确审计:<br/>verify_template.py<br/>双向 exceptAll = 0"]
AU --> Q{"通过?"}
Q -- "是" --> FR["冻结已验证的结果:<br/>把结果数据嵌入 .csp"]
Q -- "否 / 未解决" --> ST["停止,保留产物,<br/>诊断原因,起草重试方案"]
ST --> R
FR --> HB["交还给研究人员:<br/>launch_app / push_dag(需经同意)"]经过验证的诊断与重试示例
- 对全部节点逐一执行并审计,发现了测试套件虽全部通过却漏掉的 36 个真实缺陷,例如 Kaplan-Meier 中位数的置信区间上下限被颠倒。这些问题后来都成了流程验证器的必填配置检查。
- 检查点的复用基于 Merkle 链:修改上游节点会使其下游的所有检查点失效,因此绝不会给出过时的结果。
- 统计引擎的版本被计入每个结果的指纹,因此修复统计代码后,原本指纹无法察觉的缓存结果也会失效。
- 超时只表示后端已停止响应,而不是给实际工作设上限:依赖 Spark 的调用有更长的时限,预览也绝不会对惰性视图做全表扫描。
- 返回结构化错误负载却仍以状态码 0 退出,曾误导智能体的执行循环;现在 CLI 在返回错误负载时会以非 0 状态码退出。
- 在 Windows 上,直接调用 python3 会指向 Microsoft Store 的占位程序,导致所有 Spark worker 退出,因此现在固定了 Spark driver 使用的解释器。
- 一项有意保留、如实记录而非隐瞒的科学注意事项:某个 Cox 协变量使用的是按字典序取最小值的身高,而不是最早一次检查的身高。
2026-09-17 依据 CohortDAG 0.1.0-rc16 源代码核实:共享的无界面运行与编译层、Python 与 Apache Spark 后端、只读的智能体桥接,以及冻结的权威审计(verify_template.py --all,在一个非公开的临床队列上与 notebook 参照结果逐字节一致)。
文档与教程
- 端到端复现一篇已发表研究:Russell 等人 2020 · 2:10
- 复现一篇已发表研究:Althaus 2014,西非埃博拉疫情 · 1:37
- 复现一篇已发表研究:Bello-Chavolla 2020,墨西哥新冠死亡风险 · 1:48
- 复现一篇已发表研究:Cori 2013,时变再生数 · 1:20
- 复现一篇已发表研究:Lauer 2020,新冠潜伏期 · 1:33
让 AI 智能体帮您安装
智能体会下载软件,把 MCP 服务器和技能注册到自身,运行自检,然后告诉您检查结果。任何操作执行前都需要您批准。
“用 Claude Code 部署”按钮会打开 Claude Code 并预先填好指令(按 Enter 即可运行)。这需要 Claude Code 的桌面链接处理程序;如果按钮没有反应,请点击复制安装提示词,再粘贴到 Claude Code、Codex、Antigravity、Gemini CLI 或任何带聊天框的智能体中。
已经安装?注册服务器
这些按钮会把 MCP 服务器添加到本机已装有该工具的客户端中,不会安装软件本身。
cohortdag agent install --target claude-codecohortdag agent install --target codexcohortdag agent install --target antigravitycohortdag doctor为智能体安装
按照您所用客户端的步骤操作,最后运行自检。
- 1.
把 CohortDAG 接入 Claude Code
安装应用后运行一次即可。它会注册 cohortdag MCP 服务器,并安装用于搭建流程的技能。
bashcohortdag agent install --target claude-code - 2.
让智能体检查运行环境
检查 Node、Python、pyspark 和 JVM,并对缺失的部分给出具体的修复方法。
bashcohortdag doctor - 3.
用日常语言提出分析需求
智能体会编写 .csp 流程,验证、编译并运行,然后打开会话供您审核。
prompt"Build a survival analysis comparing stroke-free survival by treatment arm in my trial table, adjusted for age, SBP and diabetes."
cohortdag agent install --target antigravity 以同样的一条命令接入 Google Antigravity。以上命令假定已安装桌面应用;请通过下方联系实验室获取安装程序。
运行环境与自检
前提条件
- 经过验证的 0.2.0 Windows 版本需要 Windows x64
- 经过验证的 0.2.0 Mac 版本需要搭载 Apple 芯片的 macOS 15 或更高版本;不支持 Intel Mac
- x64 Linux;0.2.9 在 Ubuntu 22.04 上构建并安装,并在干净的 Ubuntu 24.04 容器中完成冒烟测试(0.2.4 已在 Ubuntu 22.04 上验证);Debian 和 Ubuntu 可通过 apt-get 和桌面授权进行辅助修复
- 首次运行配置运行环境时需要联网
- 约 2 GB 可用空间,用于独立的分析环境
环境变量
| 变量 | 用途 |
|---|---|
COHORTDAG_MASTER可选 | Spark 部署方式:local[N](默认 local[*]);独立集群用 spark://host:port;Spark Connect 用 sc://host:port。 |
COHORTDAG_DATA_ROOT可选 | 存放源 parquet 表的目录,仅在运行读取这些表的流程时需要。 |
COHORTDAG_DRIVER_MEMORY可选 | 覆盖本地模式下驱动程序的堆内存(默认:内存的 25%,限定在 4–16 GB 之间)。 |
智能体首先运行的自检
cohortdag doctor ✓ Node.js: v22.22.3 (running this CLI)
✓ Python: Python 3.12.9 (python3)
✓ Java (JVM): openjdk version "11.0.31" 2026-04-21
✓ pyspark: 3.5.5
✓ backend (server.py): …/ClinicalSparkStudio/src/python/server.py
! data root: $COHORTDAG_DATA_ROOT not set
fix: Set $COHORTDAG_DATA_ROOT to the directory holding your
source parquet tables (only needed to run pipelines that read them).
Environment OK — the CohortDAG backend can run.示意输出
一句话输入,完整的试验分析输出
产品自带的演示用一句话请智能体完成一项降压药试验分析。智能体搭建流程(Table 1、按组的 Kaplan-Meier、校正后的 Cox 模型和风险比),在无界面模式下验证并运行,然后交回一个 .csp 会话,打开时所有结果都已呈现。演示数据由固定种子生成,统计计算是确定性的,因此这些数字可以精确复现。
- 校正后的治疗效果
- HR 0.56
- 95% CI 0.43–0.73,Cox 比例风险模型
- 生存差异
- log-rank 检验 p < 0.001
- 药物组对比安慰剂组
- 血压未控制 → 卒中
- RR 1.74
- 95% CI 1.43–2.12
- 队列
- 600 名患者
- 由固定种子生成的模拟试验数据
实测:来自产品的 demo/hypertension-trial.csp 会话,由确定性种子生成,并以已运行的状态随每次安装附带。
功能
可视化 DAG → Spark SQL 编译器
数据源、筛选、表连接、窗口、透视、队列排除等 27 种节点,都会确定性地编译为 Spark SQL,可在 Advanced Mode 中查看。从图到查询之间没有黑箱。
临床统计引擎
带 Greenwood 置信区间和 log-rank 检验的 Kaplan-Meier、Cox 比例风险模型、分组 Table 1、发病率、风险比与比值比、SIR 建模、贝叶斯比较,以及基于因果 DAG 的混杂因素分析。
面向 AI 智能体的完整接口
cohortdag CLI(doctor、validate、compile、run、convert 等)、包含 18 个工具的 MCP 服务器,以及打包好的 SKILL.md。一条命令即可接入 Claude Code、Codex 或 Google Antigravity。
为人工审核而设计
智能体交回的是可移植的 .csp 会话,在图形界面中打开即可看到全部结果。智能体也能把节点推送到您正在使用的画布上,但必须先经您在同意对话框中批准。
检查点与可靠的缓存
导出节点会生成 parquet 检查点;只有在所有上游节点都未改变时,指纹链才会复用它们。预览以 Arrow IPC 流式传输,绝不收集整张表。
Notebook 与 SQL 迁移
cohortdag convert 可把旧的 MySQL 工作流脚本和 PySpark notebook 转换为流程。能证明等价的结构会转为原生节点,无法证明的部分保留为 Custom SQL,结果不会在不知不觉中改变。
界面一览
使用前须知
- 预发布版本:请以每个下载项旁显示的对应平台版本和发布日期为准。
- Windows 0.2.0 安装程序没有 Authenticode 签名;在 Windows SmartScreen 中选择“更多信息”→“仍要运行”之前,请先校验页面显示的 SHA-256。
- macOS 0.2.0 的 DMG 和 ZIP 是未签名、未公证的 Apple 芯片预览版;请校验 SHA-256,若信任此版本,请在“隐私与安全性”中选择“仍要打开”。
- Linux 0.2.9 的 DEB 和 AppImage 是未签名的 x64 预览版;安装或运行前请校验页面显示的 SHA-256。
- 安装程序不包含 Java、Python 和 pyspark;首次运行时会创建独立的用户环境,并在征得同意后获取所需的软件包。
- 本地模式只使用单个 JVM:对未经筛选的超大表做连接时,需要采用技能中介绍的检查点做法,或使用真正的 Spark 集群。
- 智能体对当前会话只能访问元数据;把节点推送到您的画布上,始终需要您在同意对话框中批准。
Apache®、Apache Spark、Spark 和 Spark 徽标是 Apache Software Foundation 在美国和/或其他国家/地区的注册商标或商标。使用这些标志并不表示获得 Apache Software Foundation 的认可。详情请见 Apache Spark。
版本与获取
查看更新日志 →- 可下载版本
- 0.2.9 Linux x64 DEB/AppImage(在 Ubuntu 22.04 上构建并安装,并在干净的 Ubuntu 24.04 容器中完成冒烟测试)、0.2.0 macOS 15+ Apple 芯片 DMG/ZIP,以及 0.2.0 Windows x64 安装程序(已在 macOS 27 和 Windows 11 上验证)。以上均未签名。不支持 Intel Mac。下载面板会显示每个文件的版本、大小和 SHA-256。
- 谁可以下载
- 请登录内部、Pro 或 Enterprise 组织的账户后下载。免费账户不包含下载权限,如需开通请联系支持团队。
- 各版本许可证
- 适用预发布软件条款和随附的第三方声明。之前已授予的许可及当前适用范围,请参阅许可声明。
- 更新前须知
- 请通过有权限的下载面板获取更新。升级前请保存并备份 .csp 会话。保留上一个安装程序以便恢复;此预览版不提供后台自动更新。
发布记录核对日期
阅读各版本的许可证与条款