CohortDAG
臨床解析をフローチャートとして描くと、決定論的なコンパイラが Spark SQL に変換して実行します。解析手順の全体を AI エージェントに作成させることもできます。
- バージョンはプラットフォームごとに表示
- Windows · macOS · Linux
- Electron · Python · Apache Spark
- リリース日は下に表示
CohortDAG をダウンロード
nexitia.ai から直接配布しています。各リンクは、ご利用の組織専用の期限付きダウンロードです。
インストールの前に:実行環境のセットアップ支援
- Windows x64(検証済みの Windows 版 0.2.0 の場合)
- Apple シリコン 搭載の macOS 15 以降(検証済みの Mac 版 0.2.0 の場合)。Intel Mac には対応していません。
- x64 の Linux。0.2.9 は Ubuntu 22.04 でビルドしてインストールし、クリーンな Ubuntu 24.04 コンテナでスモークテストを実施しました(0.2.4 は Ubuntu 22.04 で検証)。Debian と Ubuntu では apt-get とデスクトップの認証による修復支援を使えます。
- 初回の実行環境セットアップ中のインターネット接続
- 独立した解析環境のための約 2 GB の空き容量
macOS では、互換性のあるネイティブの Python 3.12 と Java 17 がインストール済みであれば、CohortDAG はそれを使います。ない場合は、許可を得たうえで、固定したバージョンのネイティブビルドを各上流プロジェクトから直接取得し、ユーザーのアプリケーションサポートフォルダーに置きます。既定の手順では Homebrew も管理者権限も不要で、シェルの設定ファイルも変更しません。
Windows では、セットアップ用の EXE を使います。バックエンドの環境がそろっていない場合は 「自動修復」 を選び、修復の記録が表示されるまで待ってから 「バックエンドを再試行」 を選びます。修復ボタンは、対応する修復手順が残っている間だけ表示されます。
Debian または Ubuntu Linux では、x64 の DEB をインストールするか、x64 の AppImage を実行します。バックエンドがそろっていない場合は 「自動修復」 を選びます。CohortDAG は pkexec を通じて apt-get を使います。デスクトップの認証サービスが管理者の承認を求めることがありますが、CohortDAG に管理者パスワードが渡ることはありません。apt-get と pkexec のないディストリビューションでは、セットアップ画面に表示される手動のコマンドを使ってください。
初回のセットアップ中はインターネット接続が必要です。セットアップ後は、ネットワークに接続しなくても解析をローカルで実行できます。Python、Temurin、Apache Spark などの解析パッケージは、それぞれの上流のライセンスのもとにあり、インストーラーには含まれていません。
このリリースの更新は手動です。このページで更新を確認し、お使いのアーキテクチャ向けの新しいファイルをダウンロードして、インストールの前に SHA-256 を確認してください。
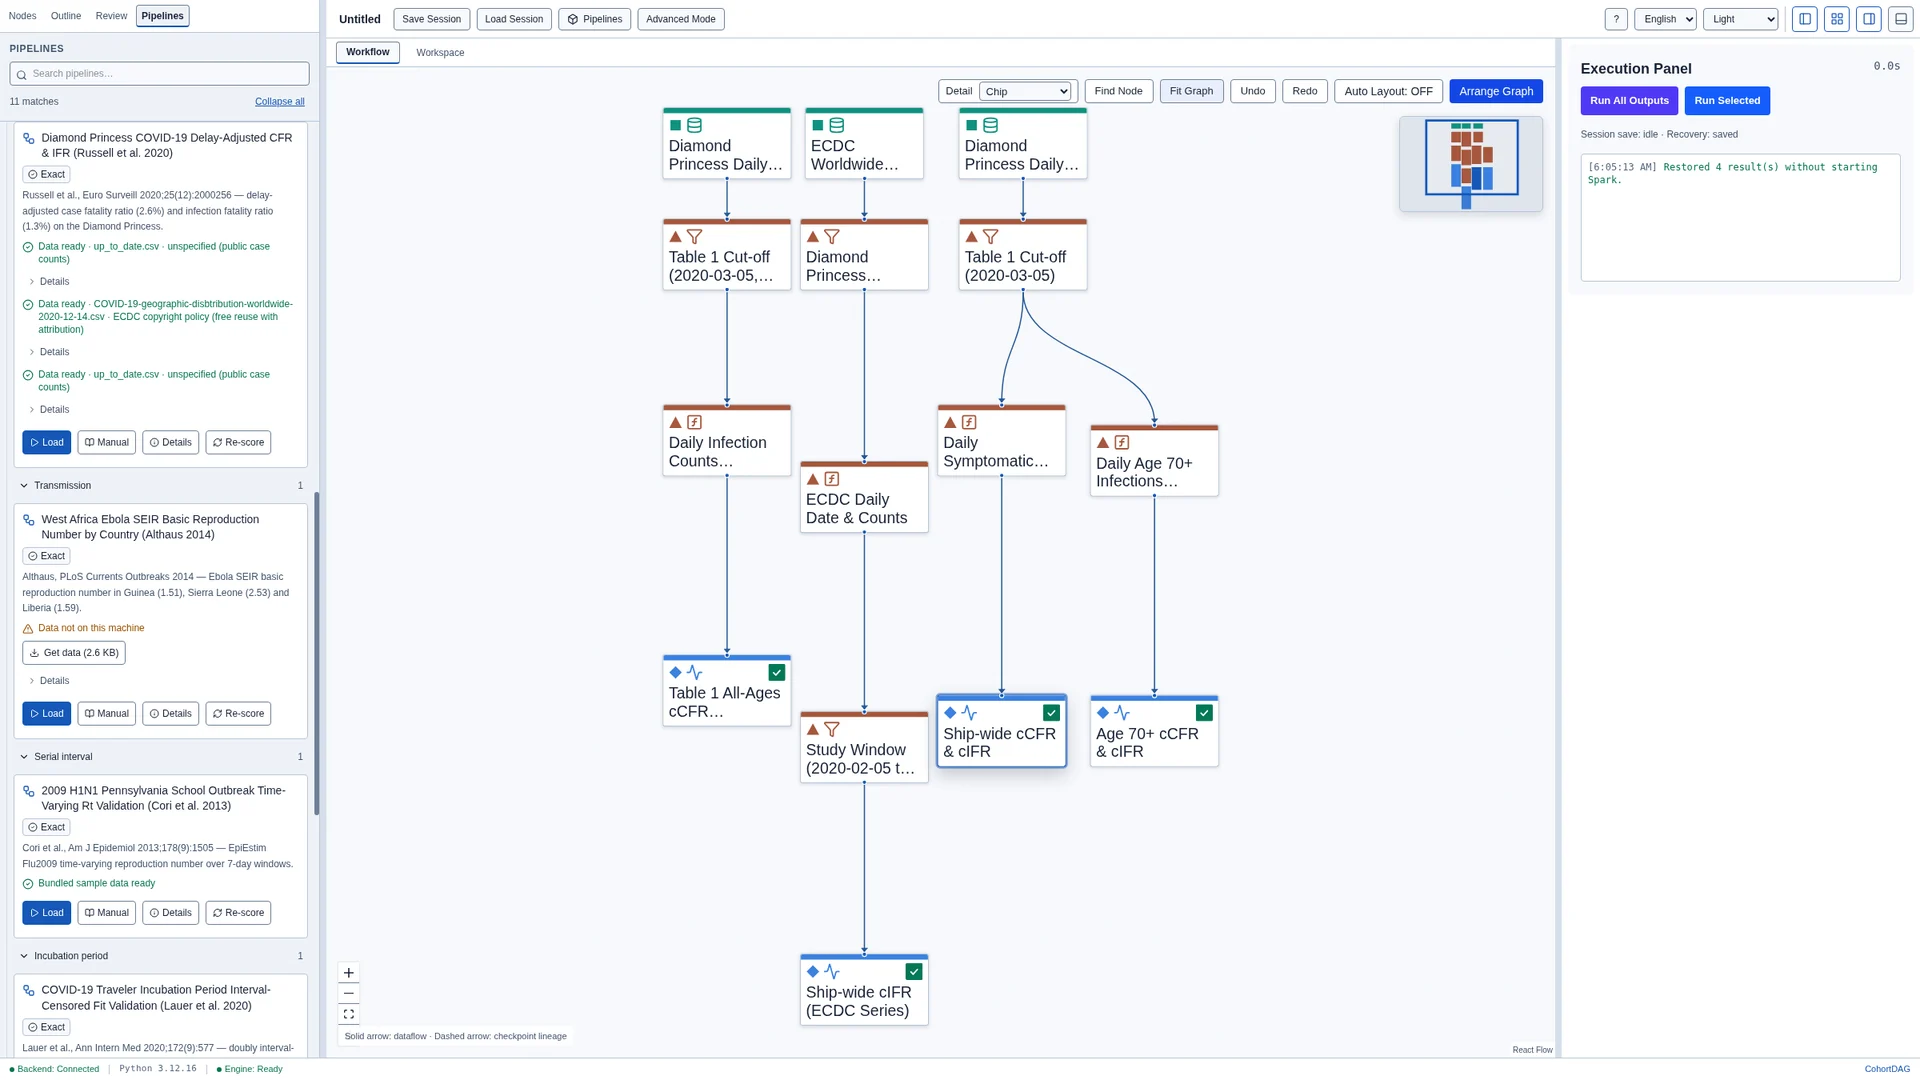
下のスクリーンショットは、公開済みの Linux パッケージで撮影した CohortDAG 0.2.3 のチュートリアル動画のフレームです。ドキュメントとチュートリアル動画には、作成元のバージョンが記載されています。
概要
Apache Spark 上で臨床ビッグデータを解析するための、デスクトップ向けビジュアルワークフローエディターです。研究者はキャンバス上でデータソース、フィルター、結合、統計のノードをつなぎます。コンパイラが Spark SQL を生成し、ハイブリッド統計エンジンが Table 1、Kaplan-Meier 曲線、Cox モデル、疫学指標を算出します。すべては持ち運べる .csp セッションに保存され、開き直しても結果はそのまま残ります。
仕組み
エージェントは、ノード、エッジ、解析設定からなる .csp のグラフを作成します。CohortDAG のコンパイラと統計エンジンは、固定されたアプリのコードでそれを実行します。アプリ自体は言語モデルを持ちません。そのため実行内容は確認でき、同じ結果を再現できます。ただし、エージェントが選んだ変数、SQL 式、前提、解釈が正しいことまでは保証しません。解析とその結果は、研究者が引き続き確認する必要があります。
flowchart LR
  A["データを取り込む<br/>CSV、Excel、SAS、SPSS"] --> B["テーブルを登録"]
  B --> C["キャンバスで解析手順を作る:<br/>データソース、フィルター、結合、ウィンドウ、<br/>コホートの除外、統計<br/>(Spark SQL をその場でプレビュー)"]
  C --> D["検証して、決定論的な<br/>Spark SQL にコンパイル"]
  D --> E["実行"]
  E --> F[("export_data のチェックポイント<br/>parquet、フィンガープリントで再利用")]
  F --> G["結果:Table 1、Kaplan-Meier、<br/>Cox、発生率とリスク比、グラフ"]
G --> H["結果を埋め込んだ<br/>持ち運べる .csp を保存"]flowchart TD
subgraph AG["AI エージェント:Claude Code、Codex、Antigravity"]
direction TB
R["ノード種別の一覧を取得<br/>(list_node_types)"] --> S["現在のセッションを読み取る(読み取り専用)<br/>(get_session_state)"]
S --> W[".csp を作成:<br/>ノード、設定、エッジ<br/>(SQL と前提を確認)"]
end
U["利用者の指示"] --> R
W --> V["検証 (validate_pipeline)"]
V --> P["決定論的な Spark SQL にコンパイル"]
P --> RUN["実行 (run_pipeline / run_statistics)"]
RUN --> CK[("チェックポイント<br/>parquet、Merkle チェーンで再利用")]
CK --> AU["参照結果との厳密な監査:<br/>verify_template.py<br/>exceptAll が双方向で 0"]
AU --> Q{"合格?"}
Q -- "はい" --> FR["検証済みの結果を固定:<br/>結果データを .csp に埋め込む"]
Q -- "いいえ / 未解決" --> ST["停止し、成果物を残し、<br/>原因を診断して再試行案を作る"]
ST --> R
FR --> HB["人に引き渡す:<br/>launch_app / push_dag(同意が必要)"]検証済みの診断と再試行の例
- 全ノードを実行して監査したところ、テストがすべて通っていても見つからなかった実際の不具合が 36 件見つかりました。たとえば、Kaplan-Meier の中央値で信頼区間の上限と下限が入れ替わっていました。これらは解析手順の検証で必須設定を確かめるチェックになりました。
- チェックポイントの再利用は Merkle チェーンで管理しています。上流のノードを編集すると下流のチェックポイントはすべて無効になるため、古い結果が使われることはありません。
- 各結果のフィンガープリントには統計エンジンのバージョンが含まれます。そのため統計のコードを修正すると、バージョンを含めなければ変化を検知できないキャッシュ済みの結果も無効になります。
- タイムアウトはバックエンドが応答しなくなったことを意味し、実際の処理に上限を設けるものではありません。Spark を使う呼び出しには長めの時間を割り当て、プレビューで遅延評価のビューを全件走査することはありません。
- 構造化されたエラーを返しながら終了コードが 0 だったため、エージェントが誤った処理を繰り返していました。現在の CLI は、エラーを返すときに 0 以外のコードで終了します。
- Windows では、単に python3 と呼ぶと Microsoft Store のスタブが起動し、Spark のワーカーがすべて停止していました。そのため、ドライバーが使うインタープリターを固定しました。
- 意図して修正せず、隠さずに記録している科学上の注意点:ある Cox の共変量では、最初の検査時の身長ではなく、辞書順で最小の身長の値を使っています。
2026-09-17 に CohortDAG 0.1.0-rc16 のソースで確認:共通のヘッドレス実行・コンパイル層、Python と Apache Spark のバックエンド、読み取り専用のエージェントブリッジ、固定した正式な監査(verify_template.py --all。非公開の臨床コホートで、ノートブックの参照結果とバイト単位で一致)。
ドキュメントとチュートリアル
- 論文を最初から最後まで再現する:Russell ら 2020 · 2:10
- 論文を再現する:Althaus 2014、西アフリカのエボラ · 1:37
- 論文を再現する:Bello-Chavolla 2020、メキシコの COVID-19 死亡リスク · 1:48
- 論文を再現する:Cori 2013、時間とともに変わる再生産数 · 1:20
- 論文を再現する:Lauer 2020、COVID-19 の潜伏期間 · 1:33
AI エージェントにインストールを任せる
エージェントがソフトウェアをダウンロードして MCP サーバーとスキルを登録し、セルフチェックを実行して結果を報告します。実際の処理は承認後にのみ実行されます。
「Claude Code でデプロイ」ボタンを押すと、指示が入力された状態で Claude Code が開きます(Enter を押すと実行されます)。Claude Code のデスクトップ用リンクハンドラーが必要です。ボタンを押しても何も起きない場合は 「セットアップ用プロンプトをコピー」 を使い、Claude Code、Codex、Antigravity、Gemini CLI など、チャット欄のあるエージェントに貼り付けてください。
インストール済みの場合:サーバーを登録
ツールがすでにインストールされているマシンで、クライアントに MCP サーバーを追加します。ソフトウェア自体はインストールしません。
cohortdag agent install --target claude-codecohortdag agent install --target codexcohortdag agent install --target antigravitycohortdag doctorエージェント向けのインストール
お使いのクライアントの手順に従い、最後にセルフチェックを実行します。
- 1.
CohortDAG を Claude Code に接続
アプリをインストールしたあとに 1 回だけ実行します。cohortdag の MCP サーバーを登録し、解析手順を作成するためのスキルをインストールします。
bashcohortdag agent install --target claude-code - 2.
エージェントに環境を確認させる
Node、Python、pyspark、JVM を診断し、足りないものがあれば具体的な対処方法を表示します。
bashcohortdag doctor - 3.
ふだんの言葉で解析を依頼
エージェントが .csp の解析手順を作成し、検証・コンパイル・実行してから、確認できるようにセッションを開きます。
prompt"Build a survival analysis comparing stroke-free survival by treatment arm in my trial table, adjusted for age, SBP and diabetes."
cohortdag agent install --target antigravity を使えば、同じく 1 つのコマンドで Google Antigravity に接続できます。上のコマンドはデスクトップアプリがインストール済みであることを前提にしています。インストーラーは下の連絡先からラボに依頼してください。
環境とセルフチェック
前提条件
- Windows x64(検証済みの Windows 版 0.2.0 の場合)
- Apple シリコン 搭載の macOS 15 以降(検証済みの Mac 版 0.2.0 の場合)。Intel Mac には対応していません。
- x64 の Linux。0.2.9 は Ubuntu 22.04 でビルドしてインストールし、クリーンな Ubuntu 24.04 コンテナでスモークテストを実施しました(0.2.4 は Ubuntu 22.04 で検証)。Debian と Ubuntu では apt-get とデスクトップの認証による修復支援を使えます。
- 初回の実行環境セットアップ中のインターネット接続
- 独立した解析環境のための約 2 GB の空き容量
環境変数
| 変数 | 用途 |
|---|---|
COHORTDAG_MASTER任意 | Spark の実行先:local[N](既定は local[*])、スタンドアロンクラスターは spark://host:port、Spark Connect は sc://host:port。 |
COHORTDAG_DATA_ROOT任意 | 元の parquet テーブルを置いたフォルダー。これらを読む解析手順を実行する場合にだけ必要です。 |
COHORTDAG_DRIVER_MEMORY任意 | ローカルモードのドライバーのヒープサイズを上書きします(既定はメモリの 25%、4〜16 GB の範囲)。 |
エージェントが最初に実行するセルフチェック
cohortdag doctor ✓ Node.js: v22.22.3 (running this CLI)
✓ Python: Python 3.12.9 (python3)
✓ Java (JVM): openjdk version "11.0.31" 2026-04-21
✓ pyspark: 3.5.5
✓ backend (server.py): …/ClinicalSparkStudio/src/python/server.py
! data root: $COHORTDAG_DATA_ROOT not set
fix: Set $COHORTDAG_DATA_ROOT to the directory holding your
source parquet tables (only needed to run pipelines that read them).
Environment OK — the CohortDAG backend can run.説明用の出力例
1 文の依頼から、臨床試験の解析一式まで
製品付属のデモでは、降圧薬の臨床試験の解析を 1 文でエージェントに依頼します。エージェントは解析手順(Table 1、群ごとの Kaplan-Meier、調整済みの Cox モデル、リスク比)を作成し、ヘッドレスで検証・実行して、すべての結果が表示された状態で開く .csp セッションを返します。デモのデータは固定シードで生成され、統計計算の結果は一意に決まるため、これらの数値は正確に再現できます。
- 調整後の治療効果
- HR 0.56
- 95% CI 0.43–0.73、Cox 比例ハザードモデル
- 生存の差
- ログランク検定 p < 0.001
- 実薬群とプラセボ群
- 血圧コントロール不良 → 脳卒中
- RR 1.74
- 95% CI 1.43–2.12
- コホート
- 患者 600 人
- 固定シードで生成した模擬試験データ
実測:製品の demo/hypertension-trial.csp セッションから取得。固定シードで生成し、実行済みの状態ですべてのインストーラーに同梱しています。
機能
ビジュアル DAG から Spark SQL へのコンパイラ
データソース、フィルター、結合、ウィンドウ、ピボット、コホートの除外など 27 種類のノードは、決定論的に Spark SQL にコンパイルされ、「詳細モード」で読めます。図とクエリーの間にブラックボックスはありません。
臨床統計エンジン
Greenwood の信頼区間とログランク検定付きの Kaplan-Meier、Cox 比例ハザードモデル、群別の Table 1、発生率、リスク比とオッズ比、SIR モデル、ベイズ比較、因果 DAG による交絡因子の分析。
AI エージェント向けの完全なインターフェース
cohortdag CLI(doctor、validate、compile、run、convert など)、18 個のツールを備えた MCP サーバー、パッケージ済みの SKILL.md。1 つのコマンドで Claude Code、Codex、Google Antigravity に接続できます。
人が確認できる設計
エージェントが返すのは持ち運べる .csp セッションで、GUI で開くとすべての結果が表示されます。エージェントは使用中のキャンバスにノードを追加することもできますが、同意ダイアログで許可した場合に限られます。
チェックポイントと信頼できるキャッシュ
エクスポートのノードは parquet のチェックポイントを書き出します。フィンガープリントのチェーンにより、上流のノードがすべて未変更の間だけそのチェックポイントが再利用されます。プレビューは Arrow IPC でストリーミングされ、テーブル全件を一括取得することはありません。
ノートブックと SQL の移行
cohortdag convert は、既存の MySQL のワークフロースクリプトや PySpark のノートブックを解析手順に変換します。等価だと証明できる形はネイティブのノードになり、証明できない部分は「カスタム SQL」のまま残るため、結果が知らないうちに変わることはありません。
画面で見る
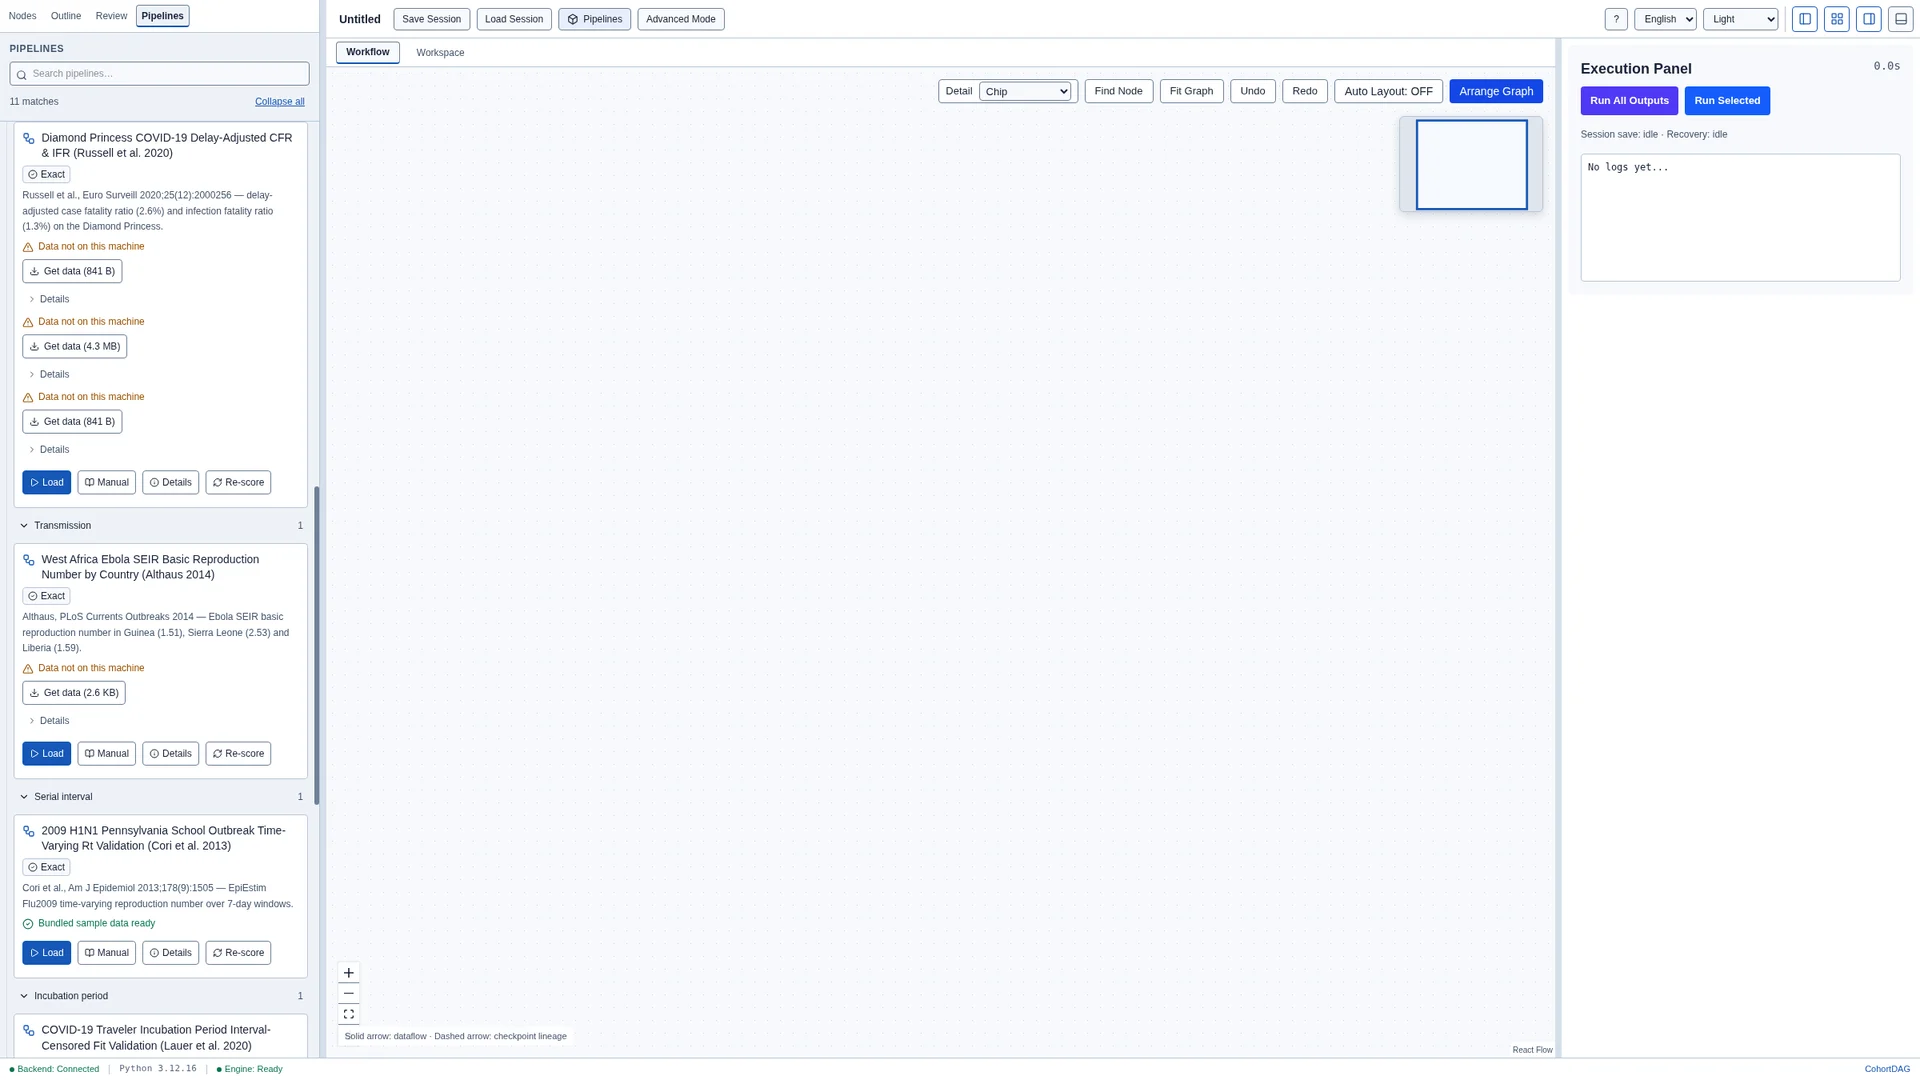
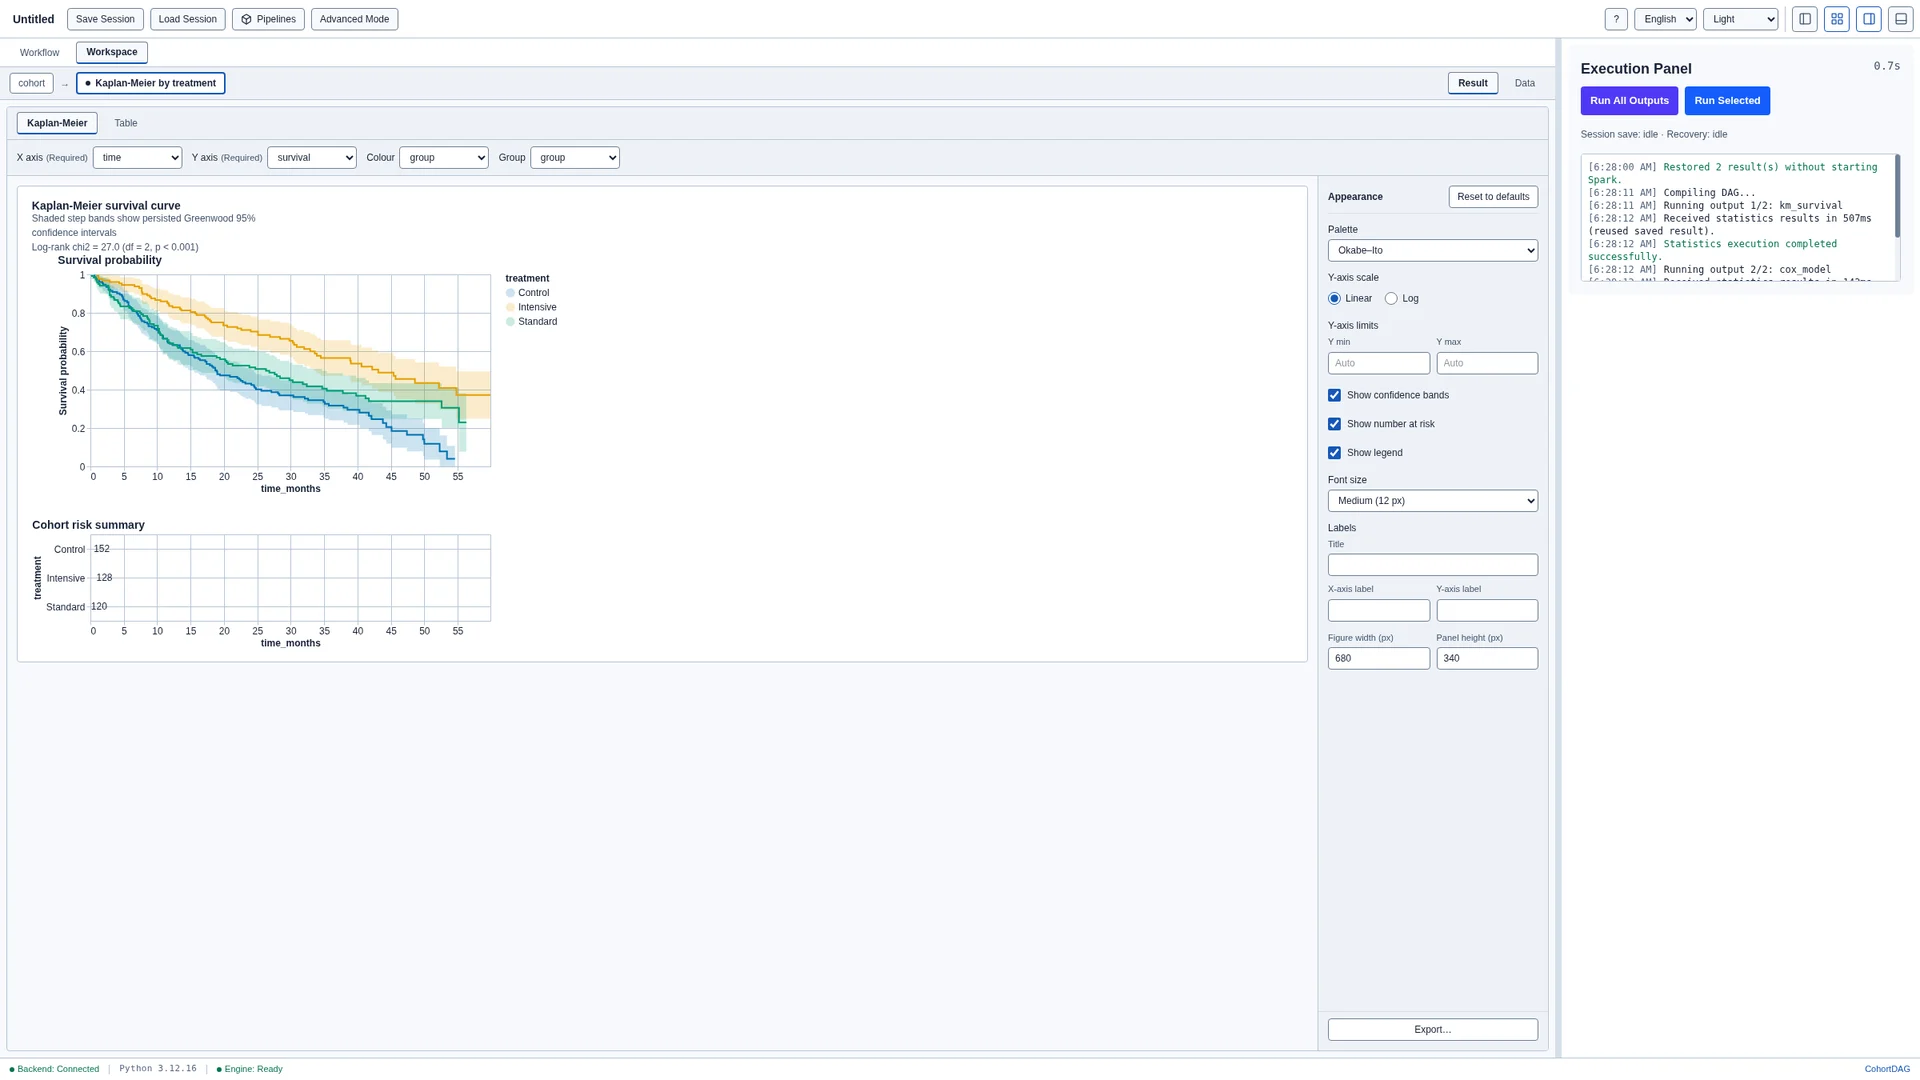
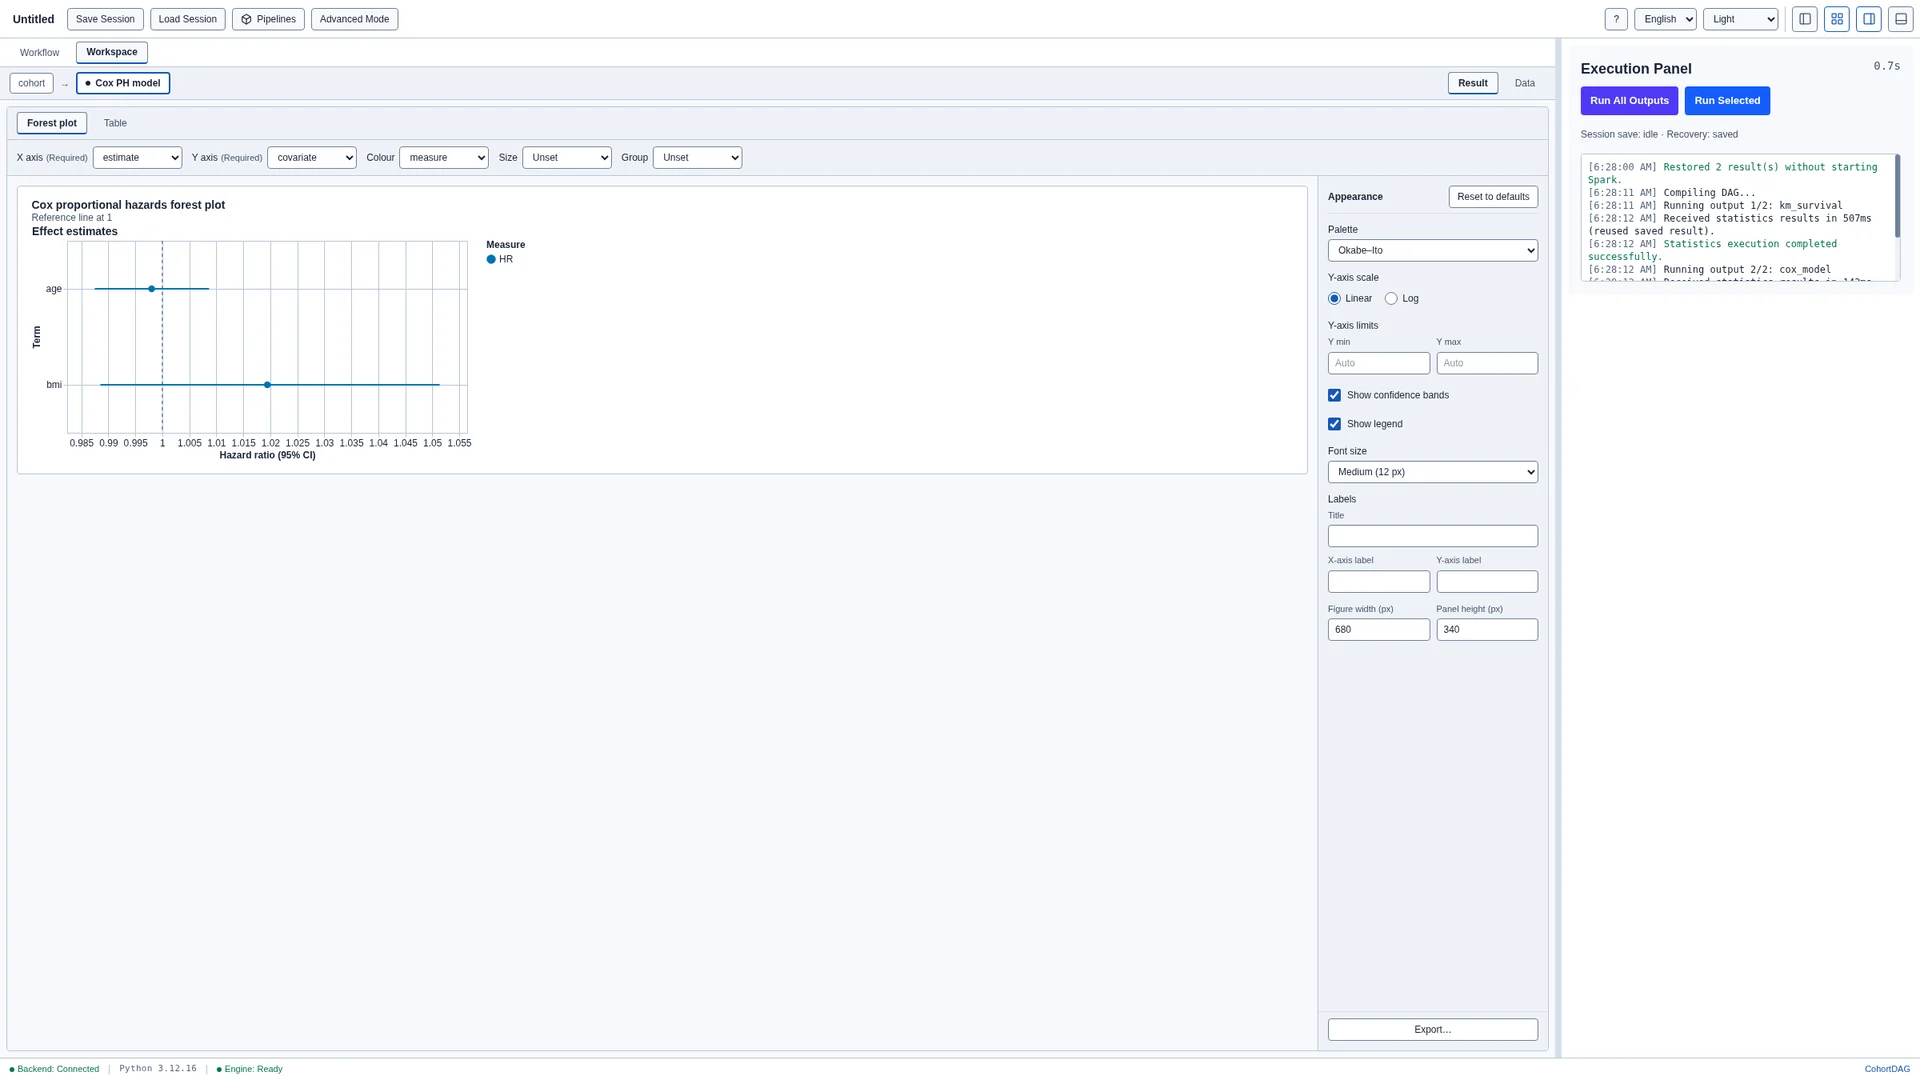
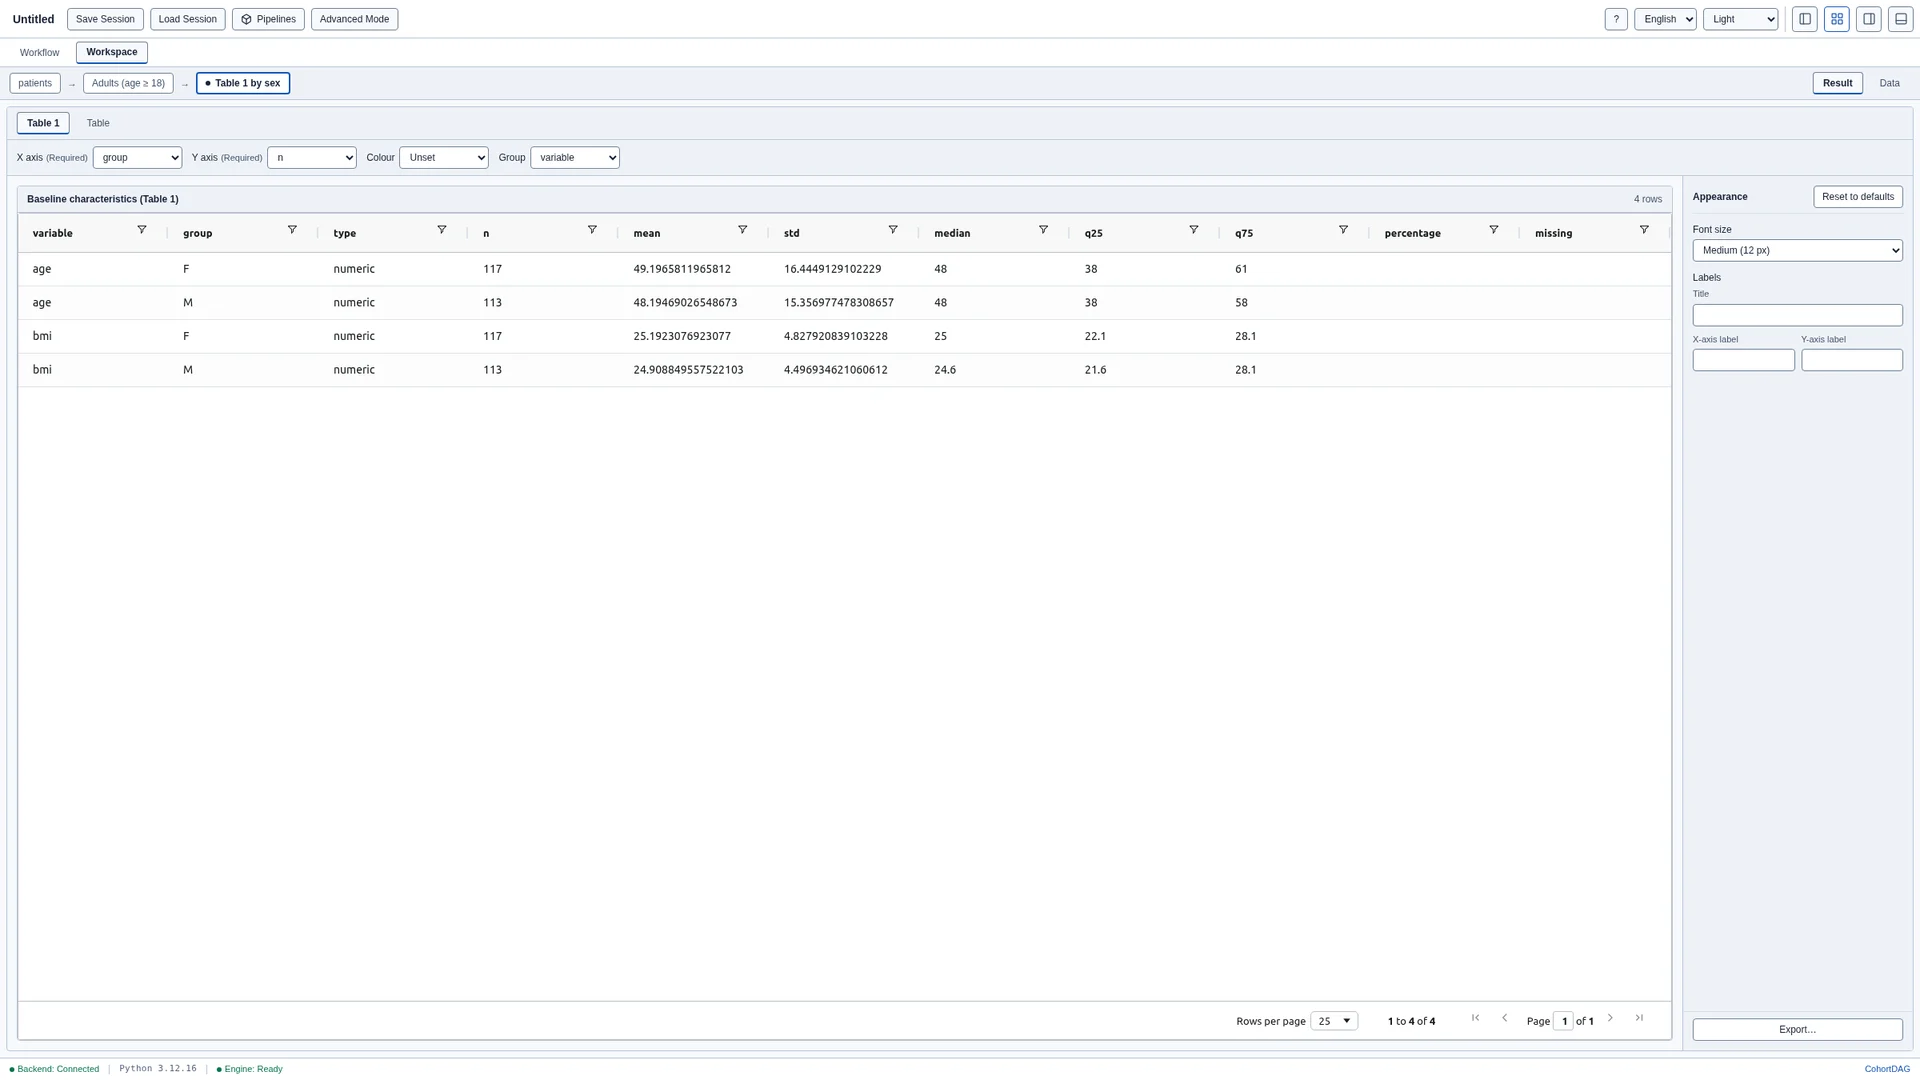
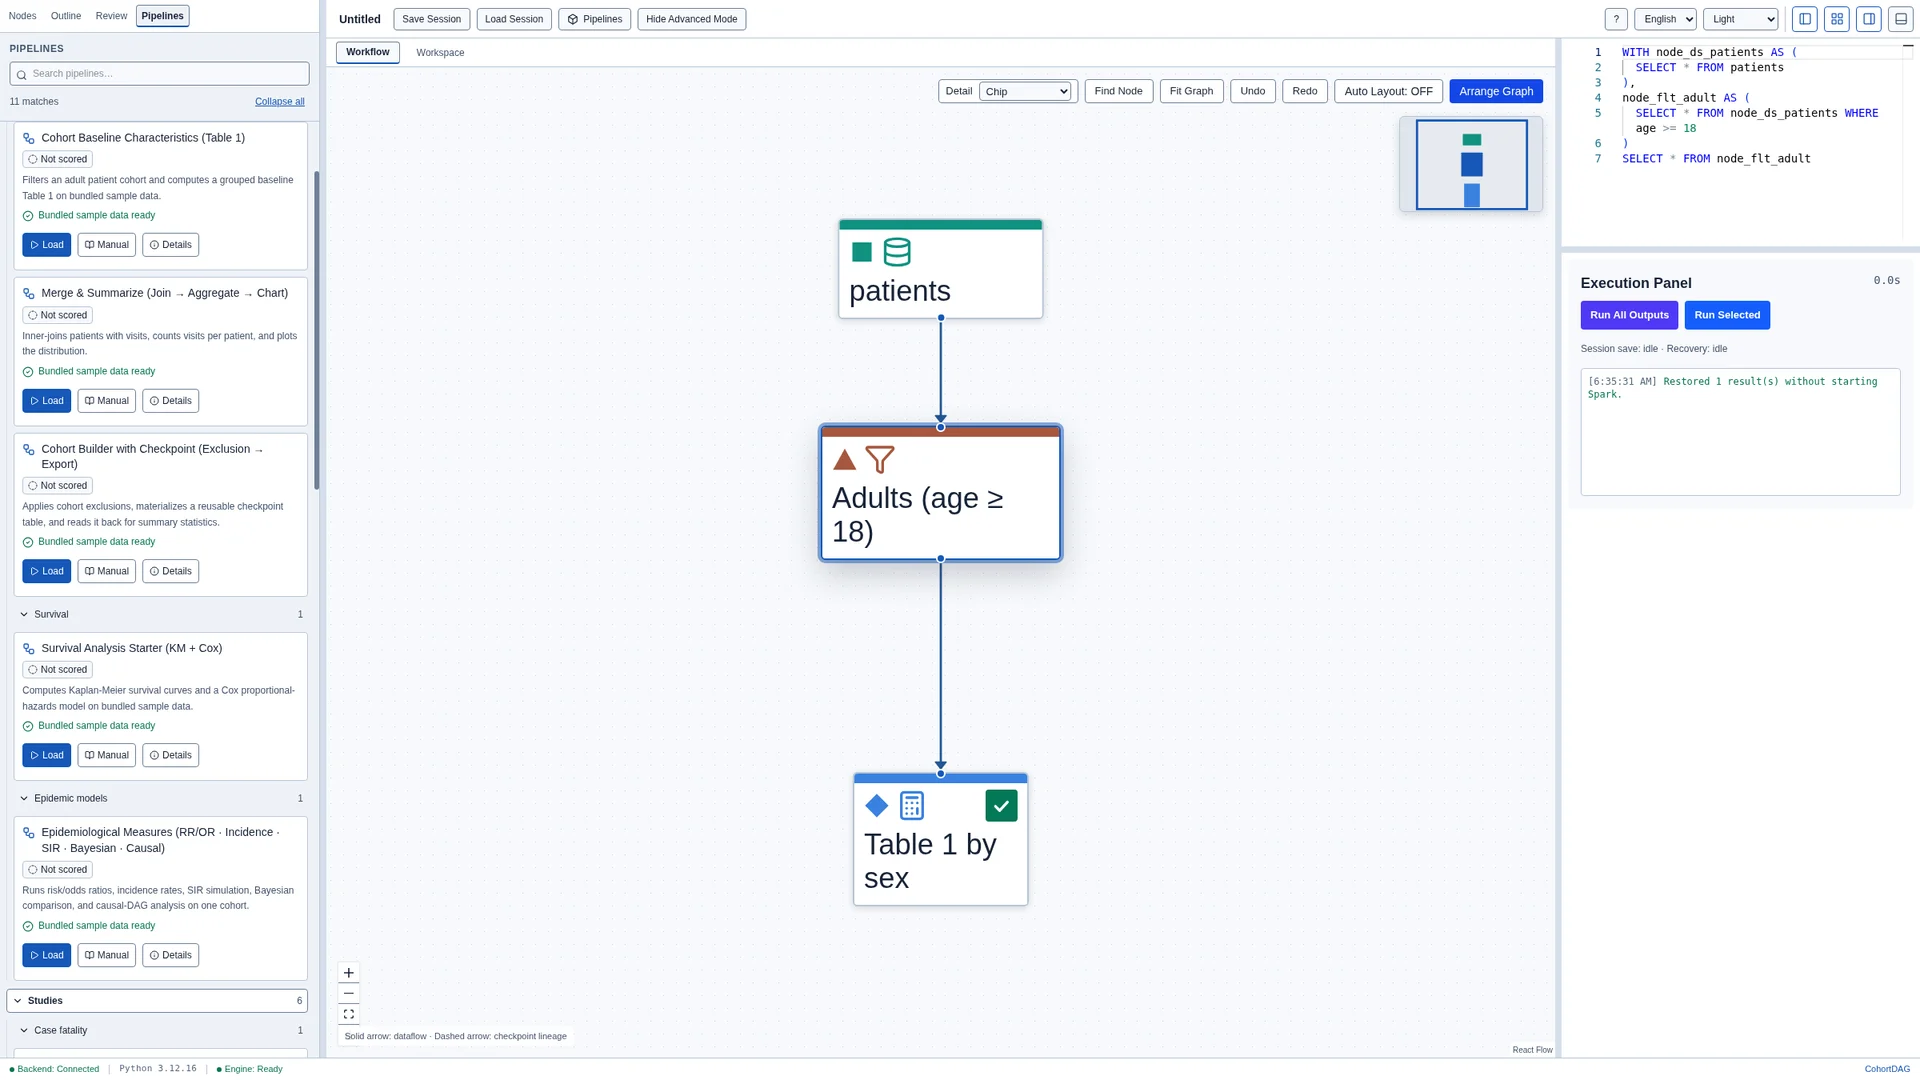
ご利用の前に
- プレリリース版です。各ダウンロードの横に表示される、プラットフォームごとのバージョンと公開日を確認してください。
- Windows 版 0.2.0 のインストーラーには Authenticode 署名がありません。Windows SmartScreen で「詳細情報」→「実行」を選ぶ前に、表示されている SHA-256 を確認してください。
- macOS 版 0.2.0 の DMG と ZIP は、署名も公証もされていない Apple シリコン 向けのプレビュー版です。SHA-256 を確認し、ビルドを信頼できる場合は「プライバシーとセキュリティ」→「このまま開く」を使ってください。
- Linux 版 0.2.9 の DEB と AppImage は、署名のない x64 向けのプレビュー版です。インストールや実行の前に、表示されている SHA-256 を確認してください。
- Java、Python、pyspark はインストーラーに含まれていません。初回のセットアップで独立したユーザー環境を作り、同意を得たうえで必要なパッケージを取得します。
- ローカルモードは 1 つの JVM で動きます。絞り込んでいない非常に大きな結合には、スキルで説明しているチェックポイントの使い方か、実際の Spark クラスターが必要です。
- エージェントが現在のセッションで参照できるのはメタデータだけです。キャンバスにノードを追加するには、必ず同意ダイアログでの承認が必要です。
Apache®、Apache Spark、Spark、および Spark のロゴは、米国およびその他の国における Apache Software Foundation の登録商標または商標です。これらの商標の使用は、Apache Software Foundation による保証を意味するものではありません。詳しくは Apache Spark をご覧ください。
リリースと入手方法
変更履歴を見る →- ダウンロードできるもの
- Linux x64 版 0.2.9 の DEB/AppImage(Ubuntu 22.04 でビルドしてインストールし、クリーンな Ubuntu 24.04 コンテナでスモークテスト済み)、macOS 15 以降の Apple シリコン 向け 0.2.0 の DMG/ZIP、Windows x64 版 0.2.0 のインストーラー(macOS 27 と Windows 11 で検証)。いずれも署名はありません。Intel Mac には対応していません。ダウンロードパネルに各ファイルのバージョン、サイズ、SHA-256 が表示されます。
- ダウンロードできる人
- ダウンロードするには、社内、Pro、Enterprise のいずれかの組織でサインインしてください。無料アカウントではダウンロードできません。利用を希望する場合はサポートにお問い合わせください。
- エディション別のライセンス
- プレリリース版ソフトウェアの規約と、同梱されているサードパーティーのライセンス表記が適用されます。従来の権利の維持と現在の適用範囲については、ライセンスの案内をご覧ください。
- 更新の前に
- 更新は、利用権限のあるアカウントのダウンロードパネルから行ってください。アップグレードの前に .csp セッションを保存してバックアップしてください。元に戻せるよう、前のインストーラーも手元に残しておいてください。このプレビュー版にはバックグラウンドでの自動更新はありません。
公開記録の確認日
エディションのライセンスと規約を読む