在此前的一篇文章中,我们提出:审计科研工作的规则(同行评议、文献综述、荟萃分析(meta-analysis)、因果推断、图表检查和基金评审)应当在工作进行之时就作为软件运行,而不是等到论文发表多年以后。一个合理的问题随之而来。在生物学、临床医学和统计学中,似乎存在成千上万条各自独立的规则:检查样本量,检查单位换算,检查多重检验校正,检查抗体是否结合其靶标,检查每个时间点是否都设置了对照组,检查某个混杂因素是否能解释两个队列之间的差异。如果每一种错误都需要一条专门手写的规则,那么任何审计科研的软件都只是由越来越多的检查清单拼凑而成的补丁,永远比下一个错误慢一步。
五十年前,数学也面临过同样的担忧,并且发现这种拼凑其实是一种错觉。当Harvey Friedman,以及后来的Stephen Simpson和许多同行,开始追问证明普通数学中的定理究竟需要哪些公理时(这一研究纲领被称为反推数学,英文为reverse mathematics,也称逆数学),当时并不能保证会得到一个整齐有序的答案[1] [2]。逻辑学家可以轻易构造出彼此之间甚至无法比较的人造公理系统[18]。然而,当他们测量了实分析、代数和组合数学中的定理之后,发现其中有数百条要么可以在一个较弱的基本系统中得到证明,要么与四个更强的系统之一等价:总共只有五类,由弱到强排列,就像一架梯子上的梯级[2] [18]:
逻辑学家把这五个系统称为大五元(the Big Five)[18]。少数著名定理(例如数对拉姆齐定理)位于这架梯子之外,而它们也正是因此才被人研究[19]。为什么在不同世纪、不同文化中提出的定理,会聚集到同样的五个盒子里?目前还没有人知道。Ludovic Patey提出过一种尚无定论的可能:这一模式反映的是数学家在选择研究哪些命题时的偏向[19]。我们把它解读为一种人择原理:如果所有可能的逻辑命题构成一个广阔的高维空间,那么人类数学家所探索的,只是其中人类心智能够把握、能够检验、并且能够传授给学生的那个小小角落。
本文从大五元的直观基础讲起(双人博弈、怪物函数、“有损压缩包”以及种种数学上的剧情反转,正是它们让反推数学成为现代逻辑中最有趣的课题之一),然后说明大五元背后的五个认知动作,如何指引nexitia.ai上我们七个科研技能的验证架构:biomedical-literature-evidence技能、孟德尔随机化(Mendelian randomization)技能、荟萃分析技能、scientific-figure-master技能、grant-write-master技能、scientific-writing技能和academic-peer-review技能。
定理为什么会变难:把量词交替看作一场双人博弈
在登上大五元这架梯子之前,先问一个更简单的问题:是什么让一个数学命题比另一个命题更难被人脑(或者AI智能体)验证?
在数理逻辑中只有两种量词:全称量词(“对所有……”“对每一个……”)和存在量词(“至少存在一个……”)。把同一种量词一再叠加,几乎不耗费任何脑力,因为相同的量词可以合并成一次抽取:
在空间中一次选出三个数,并不比选出一个数更难。麻烦是从量词开始交替的那一刻出现的(之后是,然后是,再是)。每一次交替,都把一个静态的命题变成一场双人对抗博弈:
- 每一个都是你的对手在走一步棋,极力挑出对你的论断最不利、最刁钻的情形。
- 每一个都是你这一方在应对,根据对手到目前为止走过的每一步,选出一个能化解危机的回应。
数一数,随着翻转次数的增加,大脑“过热”得有多快:
- 0次翻转():根本没有博弈;数字就摆在纸面上,照着读就行。
- 1次翻转():“无论你说出哪个数,都有一个比它更大的数。”就连小学生也能赢下这场只有一个回合的博弈:无论对手出什么,你都回答。
- 2次翻转():这就是极限的-定义,采用的是Weierstrass给出的形式,也正是大学新生在微积分课上第一次真正感到头疼的地方: 可以把它读成三步往来:第1回合(),对手提出一个误差容限;第2回合(),你针对这个算出一个安全的邻域宽度;第3回合(),对手在你的窗口内挑选任意一点,检查是否成立。两次翻转()就已经接近未经训练的直觉的边缘。
- 3次翻转():魏尔斯特拉斯怪物函数。十九世纪,Karl Weierstrass给出了一个处处连续却处处不可导的函数(在每一个尺度上都是参差的锯齿),震惊了数学界。写出“没有任何一点具有任何切线斜率”需要三次量词翻转: 看看这场四步对局是怎样展开的。第1步(对手):选定,并坚称那里的切线斜率必定是。第2步(你):考察附近的振荡频率,锁定一个误差下限,比如,并宣布无论对手放大到多近,割线斜率与的偏差至少是。第3步(对手反击):把显微镜视野拉近到小得离谱的窗口,赌曲线在局部一定会变得平滑。第4步(你将死对手):在之内,你指出一个具体的步长,在那里曲线的摆动仍然足够陡峭,足以让割线斜率偏离超过。你的制胜一步同时依赖于四个嵌套的选择。到了三次翻转,图像就不再是可靠的向导;直觉常常猜错,要靠一步一步的符号验证才能把问题定下来。
- 4次翻转():叶戈罗夫定理与概念压缩包。测度论中的叶戈罗夫定理说:如果一列可测函数在上几乎处处收敛,那么在丢掉一个测度可控制在任意小的以内的例外“坏”集之后,这列函数在其余部分上一致收敛: 这里,坏集依赖于,而阈值下标依赖于和。人的工作记忆一次大约容纳四个组块[20];按照我们自己一个并不严格的类比,到了四次量词翻转,就连经验丰富的数学家盯着草稿纸也会开始感到头晕。
数学是怎样越过四次翻转继续前进的?靠的是把概念封装起来,也就是把一条量词链的后半段打包进一个有名字的黑箱,就像一个压缩包。一旦把尾部打包成一个短语(“在之外一致收敛”),叶戈罗夫定理这头四次翻转的怪物就坍缩回一句温和规整的一次翻转命题:。两个世纪以来,数学正是靠一层层叠起这样的压缩包向上攀登的:Cauchy和Weierstrass把无穷小论证打包成极限;Poincaré、Fréchet和Hilbert把极限打包成拓扑和函数空间;Alexander Grothendieck把几何空间打包成概形和拓扑斯,并在其上搭起了一架全新的1-2-3-4阶梯。
然而,对读者来说,概念压缩是有损的:定义保留了每一个细节,但一个名字遮住了它底下的依赖关系。你可以递给同事一条简洁的单行定理,它坐落在七层嵌套的定义之上,看起来就像一个零次翻转的等式。然而,一旦审稿人试图审计这条定理,就不得不把七层定义同时解压,隐藏的量词依赖关系便像雪崩一样倾泻回来。更糟的是,正如Alfred Tarski在1930年代用他的不可定义性定理所证明的,没有任何算术公式能够为所有算术公式定义真。真可以一次针对一类受限的公式来定义,一层一层地来,但没有哪一个公式能同时检查每一层[21]。你不可能靠左脚踩右脚螺旋升天:每一项检查只覆盖一个明确的范围,不会更多,这就是我们接下来登上那架梯子时所依据的直觉。
为什么几条逃生路线总是绕回大五元
反推数学的有趣之处(几乎像一个数学鬼故事:树林里的每一条路都通回同一间小屋),在于二十世纪的数学每一次在新的基础上重建时所发生的事情。我们把它讲成三次逃脱的尝试:
- 逃脱尝试1:无穷博弈与必胜策略。逻辑学家尝试用斯科伦函数、来替换一条由交替走步构成的无穷链,这些函数记录了一位玩家如何回应此前的每一步。这样,这条链就变成了一场完美信息的无穷博弈;而一旦这场博弈有了明确的获胜集,它就只提出一个问题:两位玩家中是否有一位拥有必胜策略?然而,一个把每一段有限历史映射到下一步的策略,本身就是一个无穷对象,是种可能策略中的一个选择。当逻辑学家测量保证必胜策略存在所需的公理时,大五元早已等在终点线上:在二叉树上进行的开博弈落在[22],而在由全体自然数有限序列构成的树上,开博弈乃至既开又闭博弈都落在,获胜集是一个开集与一个闭集之交的博弈则落在[2]。
- 逃脱尝试2:Abraham Robinson的超实无穷小()。1960年代,非标准分析承诺要消除微积分中两次翻转的-之痛:它让数学家可以像对待课堂上的分数那样,直接除以真正的无穷小。当H. Jerome Keisler用这架梯子去衡量非标准算术时,他为大五元中的每一个都构造了一个非标准的对应系统,而每个对应系统都不能证明超出其所在梯级的新的标准定理;例如,他的非标准版在之上是保守的[23]。还是同样的梯级,只是披了一件更新的外衣。
- 逃脱尝试3:类型论与同伦类型论(HoTT)。计算机科学家用类型和程序取代了集合(“命题即类型,证明即程序”)。当证明论学者测量其结果时发现:带有宇宙层级但不带归纳-类型的Martin-Löf类型论,即使加上Voevodsky的泛等公理,其强度也恰好等于,具有相同的证明论序数[24]。加入-类型则会把它抬升到远高于大五元每一个梯级的位置,这说明这架梯子描述的是普通数学,而不是人们所能构造的每一个系统。
无论你给记号换上什么外衣(集合、博弈、无穷小还是类型),人类的验证和算法的验证总是绕回同样的五个梯级;按照我们自己的解读,我们把它们看作五个认知动作:
1. (执行,Execution):计算机能够一步一步算出来的东西
最底下的梯级是递归概括公理(Recursive Comprehension Axiom,),它只保证那些图灵机能够从已有集合计算出来的集合存在(概括)[2] [3]。在数学中,能处理有理数算术、矩阵代数和介值定理[2]。在科研审计中,执行对应的是有限算术、单位代数和线性代数的领域:检查是否成立,检查电子表格的单元格是否引用了它们声称使用的列,检查是否使样本协方差矩阵奇异(),或者检查样本量能支持多大的最小可检测效应()。
2. (选择与紧致性,Choice & Compactness):在分岔的迷宫中穿出一条完整的路径
第二个梯级加入了弱柯尼希引理(Weak König's Lemma)():每一棵在每个深度上都有节点的无穷二叉树,都至少包含一条从树根出发、穿过每一层的不间断路径[2] [4]。一个每次只看一层的有限算法,并不总能分辨哪一条分支会在五十步之后走进死胡同;就是紧致性原理,它把局部一步一步的相容性连接成一条完整的全局路径(并且在之上,它与海涅–博雷尔定理和哥德尔完全性定理等价)[2]。在一项实验研究中,实验设计就是一棵由选择构成的分岔树(时间点基因型mRNA/蛋白质读数分组标签)。声称存在一条连续的衰老轨迹,或者声称某种药物起到了挽救作用,就是在断言证据可以沿着这棵树的每一层一路追踪下去,没有缺口,也没有矛盾;而不是一条悄悄丢掉了6个月和12个月分支的路径,不是一条在mRNA和蛋白质之间方向相反的路径,也不是一条在图注和方法部分之间把分组标签(YY-Y, YO-Y)对调了的路径。
3. (稳定化与停机跃迁,Stabilization & The Halting Jump):收集一整个搜索族的极限
第三个梯级是算术概括公理(Arithmetical Comprehension Axiom,),它允许你构造任何用自然数上的量词定义的集合;在之上,这与概括等价[2]。在可计算性理论中,这相当于为任意一个集合提供一个预言机,用来回答相对于该集合的Alan Turing停机问题(图灵跃迁)[2] [3];在分析学中,它与波尔查诺–魏尔斯特拉斯定理等价,即每一个有界序列都会聚向一个聚点(极限点)[2]。一个脚本可以看着研究者做了一次又一次检验,但要跳出这个循环,把全部个被检验的假设构成的整个族作为一个单独的对象收集起来,就需要一条稳定化规则(这一名称是与类比而来):检查40,236个基因模型中有多少个能通过Holm全族错误率控制,检查在61种代谢物上做定和归一化是否会强行造成虚假的负协方差,或者检查在留一法交叉验证之前先挑选排名靠前的特征是否会把测试折泄漏到训练中。
4. (分层,Stratification):沿着一把标尺堆叠层级而不混淆各层
第四个梯级是算术超穷递归(Arithmetical Transfinite Recursion,),它允许沿着任意可数良序迭代概括跃迁(序数一路攀升,远远超过Gerhard Gentzen的,即普通算术的序数);它的证明论序数是,即费弗曼–许特序数,常被称为直谓性的极限[5] [25]。它的认知动作是分层:把有序的构造层级严格分开,使较低的层级无法冒充较高的层级。在一篇科研稿件中,证据处在有序的层上:
- 文档章节:
参考文献(引用的文献)引言方法(本研究实际开展的工作)结果讨论。 - 生物学层级:
计算(in silico)预研究永生化细胞系单一性别动物队列跨物种生态均值人类临床队列。
这个顺序记录的是每一层与所提出的论断相距多远,而不是它的证据有多强。当一个朴素的关键词脚本在整份PDF中搜索"male"和"female",以检查一项动物研究是否使用了两种性别时,参考文献部分中一篇提到"male"的论文标题,就可能使脚本不再对方法部分只使用雌性小鼠的情况发出警告。在检查规则之前先按章节对文档分层,就能阻止较低层的文本污染较高层的验证。
5. (自我反思,Self-Reflection):审视整个由相互竞争的解释构成的空间
第五个梯级是概括(),它加入了非直谓概括,可以构造由对所有子集的全称量化所定义的集合()[2]。它的认知动作是自我反思:检验一个论断不仅在某一条选定的路径上成立,而且在周围空间中每一个相互竞争的集合面前都站得住。在科学中,任何因果论断都是在断言:没有哪一个相互竞争的临床混杂因素(年龄、BMI、手术取材途径)、共洗脱的对映异构体(D-galactose与L-galactose)或水平多效性通路,能够同样好地解释这一观察结果。
把五个动作映射到我们的七个技能上,以及一次对抗性审计教给我们的东西
当然,一个在有限稿件上运行的Python验证脚本,并不是真的在求解停机问题,也不是真的在对的不可数多个子集进行量化[2]。确切地说,大五元的五个动作(执行、选择、稳定化、分层和自我反思)揭示了第一代验证脚本为什么会漏掉这么多科研错误:我们的基线脚本几乎每一个都停留在第1梯级()的句法表层,只检查某个数字是否出现在来源池中,或者某个URL是否能解析,而没有检查树的完整性、假设族的多重性、章节分层或相互竞争的混杂因素。
下面说明这五个动作如何映射到nexitia.ai上七个技能中的每一个,以及当我们把基线脚本和大五元验证套件一起放到六个真实科研代码仓库上,接受两轮基准测试和一次独立的对抗性代码审计时,我们发现了什么:
- biomedical-literature-evidence技能:
- 已有的公开记录:记录PubMed/PMC检索式,把研究与相互重叠的队列文章区分开,把导入的RIS/CSL-JSON引文在核对之前一律保持为未核实状态(在其验证记录中为3项中的3项),并允许文献综述台账得出证据不足的结论。
- 大五元映射:执行()解析物理单位,使颗粒计数(
particles/g、MPs/g、filaments/individual)绝不会被当作热裂解GC/MS质量浓度(ug/g)合并在一起;分层()在缺少换算系数时拒绝悄悄按进行兜底替换;自我反思()则在综合之前标记出已撤稿的来源。
- 孟德尔随机化技能:
- 已有的公开记录:在存档的163行关联数据中保留157行用于估计,并与Walker等人2019年研究中全部19个核心比较单元格一致(复现报告),同时标记出一处正文与表4之间的不一致。
- 大五元映射:执行()核对标准误是否为有限值,并核对统计量以及针对结局尺度的比值比变换;选择()强制执行确定性的估计方法路由(时用Wald比值,时用IVW,时用IVW + 加权中位数 + MR-Egger);稳定化()同时在完整的计划暴露族()和核心族()上重新计算Benjamini–Hochberg错误发现率值(在我们的基准测试中,针对有限值、路由与多重性的
54 of 54项检查全部得到核实);分层/自我反思(–)则把未执行的Steiger方向性检验、稀释和多变量条件分析明确标记为unavailable,而不是让报告暗示它们已经通过。
- 荟萃分析技能:
- 已有的公开记录:在28篇Cochrane系统评价中,复现了1,061项合并分析中的1,060项,以及11,351个可核对的定量条目中的10,797个(95%)(性能报告)。
- 大五元映射:执行()在进行定义域比较之前拒绝
NaN/±Inf输入(这是我们在ma_validate.py中发现并修补的一个缺陷),提取.xlsx工作表XML(xl/worksheets/sheet*.xml)时把缓存值与公式字符串严格分开,并在一张40,236行的跨物种基因表的全部35,130个可检验行上核对signed_z == local_beta / local_se(其余5,106行缺少数值,被记录为排除,而不是通过);稳定化()检查存储的Holm多重性通过计数(0 of 40,236)是否与汇总台账一致。
- scientific-figure-master技能:
- 已有的公开记录:在20条真实图注的61个评分字段中解析出61个(技能页面),并在重新计算的值为时拒绝画出显著性星号。
- 大五元映射:执行与选择(–)直接检查提交的Word文件内嵌的Office Open XML图表缓存(
word/charts/chart*.xml),并把图中绘出的离群点完整集合与图注进行比较。在我们对一份代谢组学补充材料的对抗性审计中,这个通用的图表缓存解析器在不需要OCR、也不需要人工审稿意见的情况下,发现了一处值得注意的双重矛盾:在Fig. S2(chart1.xml)中,图注声称样本OA-5、OA-7和OA-10超过了临界阈值(1.6225),但保存的图表缓存显示OA-10位于0.9108,远低于这条线;在Fig. S3(chart2.xml)中,图注点名OA-1和OA-8高于临界阈值(2.2026),而图表数据中实际超过阈值的是NON-OA2和OA-1。
- grant-write-master技能:
- scientific-writing技能:
- 已有的公开记录:对照源文件筛查所报告的检验统计量,并把编辑备注挡在用于发表的文件之外(发布说明)。
- 大五元映射:执行()把正文中关于差异表达的论断(
563 DEGs: 209 up-regulated and 354 down-regulated)直接绑定到补充CSV表中计算出的计数上,并为audit_numbers.py升级了一个零依赖的.xlsxXML读取器,它检查所有工作表和共享字符串,同时不让单元格坐标(U2、1000)污染数值证据池;选择()按分析物、对比和时间点把mRNA读数与蛋白质读数配对,使不显著的蛋白质数据被报告为尚无定论,而不是已被证实的挽救效应。
- academic-peer-review技能:
- 已有的公开记录:依据60份公开评审中的1,035条审稿意见进行了校准;在针对一份湿实验投稿的盲测中,捕捉到49个逐条审稿要点中的6个,并要求做出9处从v1到v2的修改中的5处(技能页面、基准测试、PeerJ 20995盲测评审)。
- 大五元映射:我们把三项结构性升级直接移植回了
screen.py:一个零依赖的.docxXML读取器,一个保守的页边行号规范化处理器(要求出现持续的连续序列之后才删除看似页边行号的数字,因此换行处的孤立数字会被保留),以及章节分层,它把动物性别筛查限定在Methods(或References之前的正文)中,并把单一性别的范围与缺失的性别报告分开标记,防止References中的文献标题掩盖单一性别的实验。
这些检查能够发现它们在设计时所针对的那些具体错误。至于如何把这种结构转化为AI智能体仍在工作时更好的决策,则是下一节要讨论的问题。
AI智能体需要什么才能检查自己的工作
设想一个正在处理商品换货的智能体。它可以查到订单,却仍然漏掉决定这件事的那个问题:顾客想要换的商品是否符合政策中的条件?上文的五个梯级是为审计一份已经完成的文档而建立的。把它们用到这一次换货上,读起来会是这样:计算订单的日期和金额合计(执行);沿着政策中适用于这类商品的那条分支走下去(选择);把订单上的每一件商品和此前的每一次退货放在一起看(稳定化);把顾客说的话与系统记录的内容分开(分层);并追问政策中是否有某条例外会改变答案(自我反思)。在这里,我们想问的是:同样的结构是否也能在智能体仍在工作的时候帮到它,以及我们自己的研究之外的证据说了什么。
这些证据在一点上是清楚的。只是让模型重新考虑它的答案,可能会严重失败:在一项测试中,GPT-3.5在没有任何新信息可依据的情况下被要求自我修正之后,在CommonsenseQA上的正确率从75.8%降到了38.1%[7]。当智能体可以求助于自身之外的东西时,例如搜索引擎、代码解释器或一个会返回判定结果的测试,自我修正就会更加可靠[8] [9];专门训练模型修正自己则是另一条路[26]。外部检查之所以有用,是因为它带来了模型原本没有的证据。
同样的证据也提醒我们,不要以为结构越多就一定越好。我们下文使用的基准测试SOPBench的作者,向四个模型提供了一份明确的检查清单,列出每个流程所要求的核查项;其中两个模型的通过率下降了,而且其中一个模型的不安全操作从21例上升到74例[6]。即使他们把每一条约束的真实判定结果都直接交给智能体,仍有相当比例的案例失败,在四个模型上为12%到38%,因为最后到底是执行还是拒绝的选择依然很难[6]。在编程智能体中,由模型撰写的代码仓库指令文件使推理成本上升了20%以上,却没有提高成功率[10]。指令并不是免费的:每增加一条规则,智能体就要多阅读、多权衡一段文字。
审查一个操作的三种方式
通用反思(generic reflection)要求智能体重新考虑自己的工作,并把需要检查什么留给模型自己决定。扁平验证(flat verification)给智能体一份明确的检查清单,列出需要审查的要求。Big5c是Big-5编译器(Big-5 compiler)的简称,它用上文描述的五个梯级来组织审查。对于一个拟执行的操作,智能体检查它已经确立了哪些事实,这些事实支持哪些选择,以及哪些前提条件仍未落实。一旦发现缺口,它就要求更正,并再次检查结果。在换货的例子中,这意味着把政策与订单中的那件具体商品联系起来。
这项试点研究我们使用了一个基准测试,即SOPBench,它测试智能体能否在遵守约束其操作的规则的同时完成顾客的请求。它的作者提供了覆盖70个流程的830个经过验证的案例,并附有代码,用来检查最终状态、每一个步骤,以及所要求的核查是否发生在操作之前[6]。
我们在同样的覆盖20个流程的185个案例上测试了两个模型。这些案例来自网上购物(49)、医疗(40)、银行(27)、机动车服务(27)、酒店(25)、大学(13)和图书馆(4)。下表给出被正确处理的案例所占的比例(包括正确的拒绝),以及每个案例平均使用的token数。
| 审查方法 | GPT-5.6 Luna成功率 | Gemini 3.8 Flash low成功率 | GPT每案例token数 | Gemini每案例token数 |
|---|---|---|---|---|
| 通用反思 | 63.8% (118/185) | 63.8% (118/185) | 58,178 | 105,821 |
| 扁平验证 | 64.9% (120/185) | 59.5% (110/185) | 57,198 | 104,921 |
| Big5c | 87.6% (162/185) | 88.1% (163/185) | 73,902 | 116,664 |
token平均值在每个模型内部对三种方法使用相同的案例。有一个Gemini案例缺少通用反思的token计数,因此Gemini的成本比较使用184个案例。
在GPT-5.6 Luna上,Big5c的成功率比通用反思提高了23.8个百分点,比扁平验证提高了22.7个百分点。与通用反思相比,每多成功一个案例大约多花费66,100个token;与扁平验证相比,则大约多花费73,600个。在Gemini 3.8 Flash low上,提升幅度分别为24.3个和28.6个百分点,每多成功一个案例分别大约多花费45,300个和41,600个token。
这些成本的算法是:把所有具有完整token记录的案例上多使用的token数,除以同一组案例上成功案例的净增加数。
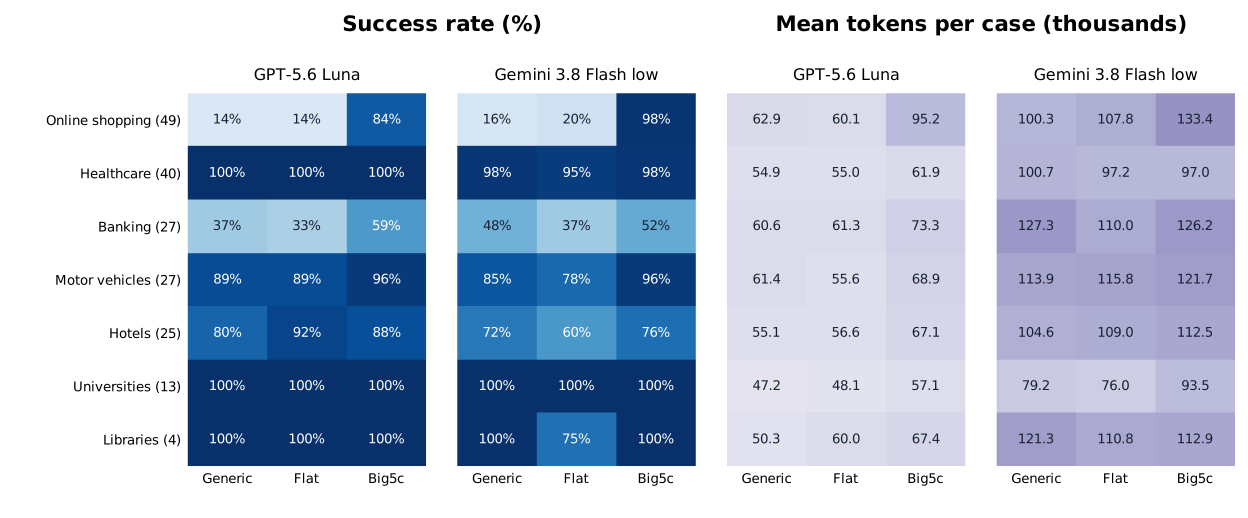
每一行是一个服务领域,括号内为案例数。横向阅读每一行,可以比较三种审查方法。成功率使用全部案例。token平均值使用每个模型内三种方法都有完整记录的案例。
这项试点研究告诉了我们什么
给智能体一份检查清单,在两个模型上产生了不同的效果。与通用反思相比,扁平验证在GPT上多成功了两例,在Gemini上则少了八例。Big5c在两个模型上都优于这两种方法。一个说得通的解释是:检查清单可以告诉智能体去核实资格条件,而修复步骤则让它在证据缺失时有事可做。这项试点研究测量的是整个工作流,因此五个梯级各自的贡献仍是一个有待回答的问题。
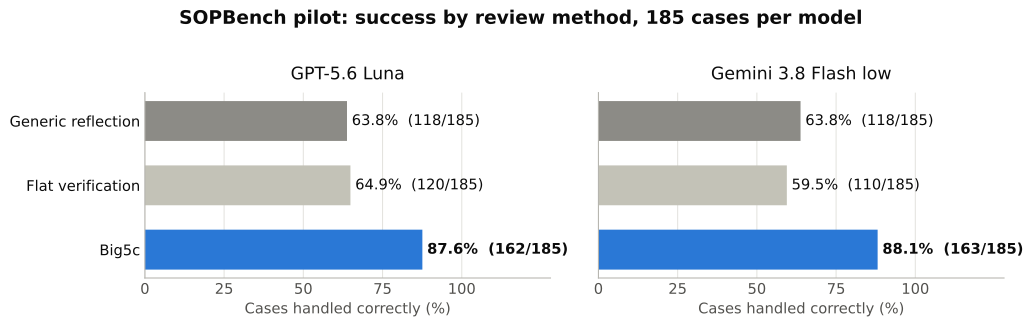
每一根柱表示同样的185个案例中,一种审查方法正确处理的案例所占的比例;括号内为案例数。
即使在结果保持不变的案例上,额外的审查也消耗了token。对于要选择在哪里使用它的研究者来说,相关的问题是:多正确处理一个案例值多少。这个判断取决于具体的流程。网上购物贡献了49个案例,图书馆贡献了四个,因此总体比例更多地反映了这一特定的请求组合,而不是任何单一的服务。
结构化的审查在哪里节省了token?Gemini在医疗领域的运行给出了最清楚的例子。Big5c和通用反思各自通过了40个案例中的39个,但Big5c每个案例少用了大约3,760个token(3.7%)。运行轨迹记录显示,Big5c有150次工具调用,通用反思有159次。较短的调用序列可以节省token,因为智能体在工作时需要阅读的工具结果更少。这是对此现象的一种合理解释。与扁平验证相比,节省的幅度每个案例只有大约170个token(0.2%),同时多成功了一例。
工具调用只解释了这一模式的一部分。在四个图书馆案例上,Gemini无论使用Big5c还是通用反思都通过了全部四个,并且都进行了15次调用,但Big5c少用了6.9%的token。在调用次数相同的情况下,智能体阅读和生成的文本量也可能不同。在银行领域,Gemini的Big5c运行成本略低于通用反思,高于扁平验证。对于GPT,Big5c在每一个领域平均使用的token都比另外两种方法多。这些差异为完整的研究提出了一个问题。什么时候,因抓住一个缺失的前提条件而省下的工作量,会超过检查它所付出的成本?
第二项规模更小的试点研究指向了其中一个答案。我们把六个合成的科研工作流各运行了两次,一次配有能正常工作的辅助脚本,一次配有存在缺陷的辅助脚本,这样每个模型有12个任务。Big5c和通用反思都在全部12个任务上给出了正确的最终答案,并修复了全部六个有缺陷的辅助脚本,但在这12个任务上,Big5c在GPT上少用了34%的token,在Gemini上少用了23%。节省来自那些辅助脚本本来就能正常工作的工作流:当一项检查可以被执行并且通过时,智能体就可以完全跳过评判环节。
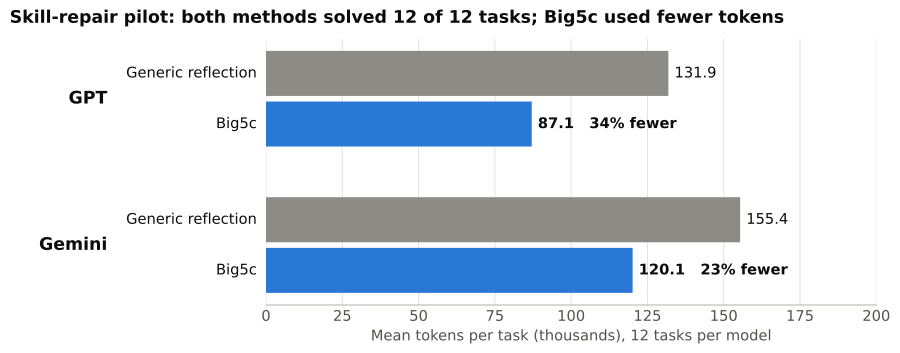
对每个模型的12个任务计算每个任务的平均token数,单位为千。两种方法在全部12个任务上都给出了正确答案。
像管理人一样管理AI智能体
这项试点研究指向了一个比任何单个数字都更让我们感兴趣的想法:各类组织用来让人的工作变得可靠的那些方法,也许能以类似的方式让AI智能体的工作变得可靠。其他人也已经以同样的想法为基础构建了系统。MetaGPT把一家软件公司的标准操作程序和岗位角色编码进一个由AI智能体组成的团队[27]。一个更近的系统把它的智能体安排为规划者、执行者和评审者,并划定严格的角色边界,其理由是AI智能体“就像我们雇用过的所有人一样”,仍然会出错[28]。
人类的质量管理也为解读我们的表格提供了一种方式。像通用反思那样要求智能体重新考虑自己的工作,相当于叮嘱一个人要更加小心。单独一份检查清单帮助了一个模型,却损害了另一个模型。外科领域同样发现,采用检查清单并不会在每个地方带来同样的改善。当八家医院把WHO手术安全核查表作为一个项目引入,同时开展人员培训,并在每台手术前后进行团队简报会时,术后死亡率从项目开始前3,733名患者中的1.5%降到了项目开始后3,955名患者中的0.8%[29]。当安大略省着手要求医院公开报告检查清单的使用情况时,该省101家医院采用了检查清单,其中大多数配有教育项目,但没有被要求进行正式的团队培训,校正后的死亡风险从0.71%变为0.65%,这一变化并不显著;作者还指出,除WHO的研究之外,那些效果很大的研究要么把检查清单与大量的团队培训结合在了一起,要么使用了覆盖整个诊疗过程的更全面的检查清单[30]。这两项研究都是前后比较,而不是随机试验,而且都没有分离出究竟是什么造成了差别,正如我们的试点研究也没有把修复步骤单独分离出来。它们合在一起,提出了我们在AI智能体上所关心的问题:围绕检查清单的哪些做法,能把它的检查变成更好的决策?Big5c是正在接受检验的一个答案,它是一份与修复步骤打包在一起的检查清单,一旦某项检查未通过,修复步骤就随之启动。
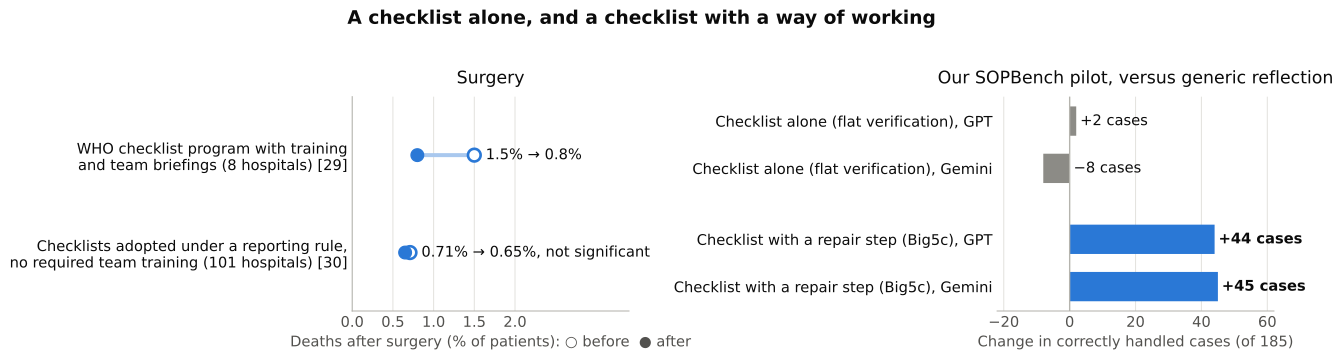
左:两项研究中引入检查清单前后的术后死亡率,两项研究的人群不同;安大略省的比率经过了校正[29] [30]。右:在我们的试点研究中,与通用反思相比,正确处理的案例数的变化,每个模型共185个案例。
所有管理工具中最古老的一种,就是成文的流程。航空业在几十年前就解决了这个问题的一个版本。ASD-STE100,即简化技术英语(Simplified Technical English),对词汇和句子结构加以限制,使维修技术人员(其中许多人的母语并非英语)能够毫无歧义地读懂一条指令[11]。ISO 24495-1为简明语言(plain language)规定了四项原则:读者能够找到他们需要的内容,能够理解它,能够使用它,并且内容与他们相关[12]。对于人类读者,简化英语使复杂的流程显著更容易理解[13]。
现在有许多人把这些标准用到AI上,而且大多是朝着一个方向:他们要求模型用简化技术英语来写作,让人更容易读懂它的输出。已有公开可用的工具在帮助人们应用这一标准;其中一个工具报告说,在八项写作任务和十二个模型上,它使测得的违规平均减少了95.5%[17]。Andrej Karpathy在2026年10月初推荐了这种做法[31]。直接点名要求使用这一标准,也可能要付出代价。在一位开发者针对四段代码所做的小型测试中,当被要求使用“Simple Technical English”时,Claude的解释丢失了47个被核对事实中的4个;当被要求使用ASD-STE100时,则丢失了47个中的22个[32]。
另一个方向,也就是为必须遵循流程的AI智能体来撰写流程,有着更强的证据。把工作流交给智能体这件事本身就很重要:在FlowBench上,GPT-4o完成的会话所占的比例,从没有工作流时的35.1%上升到有工作流时的41.7%到43.2%之间,无论工作流是写成文本、代码还是流程图,涉及51个场景[14]。在两个ToolBench测试集上,把冗长的工具文档改写成带有参数指引和示例的简明指令,使文档缩短到原来长度的三分之一以下,并使由GPT-4评判的ChatGPT回答成功分数从15.0%提高到52.8%[35]。对流程进行重构同样有帮助。在一组经过筛选的125个SOPBench银行案例上,把流程中机器可读的约束编译成带有明确核查步骤的结构化伪代码,与官方的文字说明相比,在六个模型上使成功率最多提高了16.0个百分点(提升最大的一个从70.4%提高到86.4%),而且没有使其中任何一个模型的成功率下降[33]。一个把自然语言工作流转换成可执行工作流的编译器,为每一个步骤写明输入、输出、检查和控制流,在来自11个工作流的488个案例上,使三个模型的任务成功率平均从56%提高到84%,而把同样的工作流改写成一份更清晰的文本文档则达到63%[34]。Big5c在审查上走的是同一条路:它把一个流程的要求编译成五个梯级上的检查,并为未通过的检查加上一个修复步骤。
然而,对人有帮助的东西并不总是对AI智能体有帮助,对一个模型有帮助的东西也可能损害另一个模型。在上面那项SOPBench研究中,一个只向智能体显示流程当前步骤的运行时系统,帮助了两个较强的模型,却使GPT-4o-mini的成功率从使用完整编译流程时的75.2%降到了48.8%[33]。措辞会影响遵从程度:当编程智能体在一组86个编程任务上收到用四种方式表述的同一条规定时,两个Claude模型中能力较强的那个,平均遵从率在直接表述下为78.0%,在条件式表述(“if …, then …”)下为64.2%[15];这是一处值得留意的张力,因为简化技术英语要求把读者必须先知道的条件放在句子的开头[11]。为人而写的简化并不会自动帮助模型:当分类等基准任务的输入文本被自动简化时,语言模型在英语上的表现最多下降了20个点[16]。
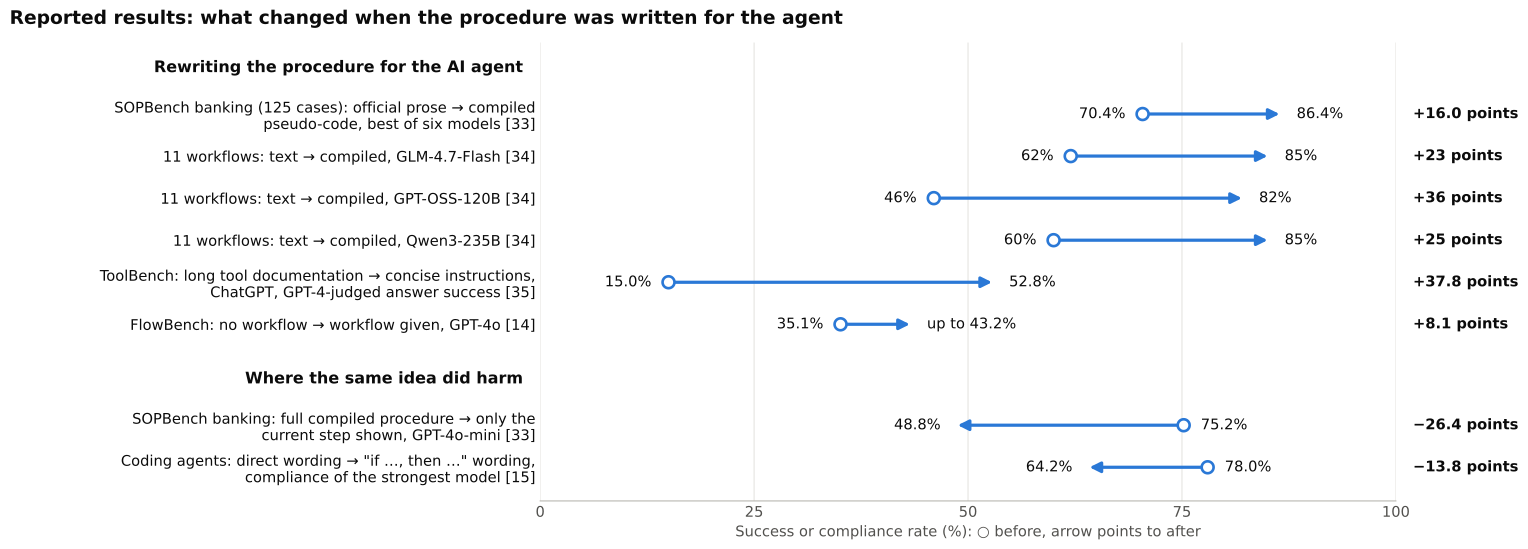
每一行是一项已报告的结果:圆圈是改变之前的比率,箭头指向改变之后的比率。这些研究使用的任务和度量各不相同,因此各行应当逐行单独阅读。
因此,我们预期这套管理体系可以迁移到AI智能体上(成文的流程、带有修复手段的检查,以及分开的角色),而那些为人类读者制定的措辞规则则必须在智能体上重新检验。我们没有找到任何对照研究,检验明确按照ASD-STE100或ISO 24495-1改写的智能体流程是否能帮助智能体完成更多任务。
我们将在arXiv上以学术论文的形式报告完整的Big5c研究,并在GitHub上发布Big5c引擎。
参考文献
- Friedman H (1975). Some systems of second order arithmetic and their use. Proceedings of the International Congress of Mathematicians (Vancouver, 1974), Vol. 1, pp. 235–242. Canadian Mathematical Congress. 提出了反推数学这一研究纲领,表明分析中的普通定理在一个弱基础理论之上,与二阶算术中特定的集合存在公理等价。
- Simpson SG (2009). Subsystems of Second Order Arithmetic, 2nd ed. Perspectives in Logic, Cambridge University Press. doi:10.1017/CBO9780511581007. 定义了二阶算术和五个主要子系统(、、、和),并确立了它们与可计算数学、海涅–博雷尔紧致性、波尔查诺–魏尔斯特拉斯收敛性、直到的序数层级以及非直谓集合概括之间的关系。
- Turing AM (1936). On computable numbers, with an application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, Series 2, 42(1): 230–265. doi:10.1112/plms/s2-42.1.230. 用带有有限控制器和无界纸带的机器定义了可计算序列,并证明了停机/判定问题的不可解性,正是它把可计算的检查()与算术概括()区分开来。
- König D (1927). Über eine Schlussweise aus dem Endlichen ins Unendliche. Acta Litterarum ac Scientiarum Regiae Universitatis Hungaricae Francisco-Josephinae, Sectio Scientiarum Mathematicarum 3: 121–130. 证明了柯尼希无穷引理,即每一棵无穷的、有限分支的树都有一条无穷路径;该引理限制在二叉树上的形式构成了的公理。
- Gentzen G (1936). Die Widerspruchsfreiheit der reinen Zahlentheorie. Mathematische Annalen 112: 493–565. doi:10.1007/BF01565428. 通过直到序数的超穷归纳法确立了一阶算术的一致性,是证明论中序数层级分析以及的基础。
- Li Z, Huang S, Wang J, Zhang N, Antoniades A, Hua W, Zhu K, Zeng S, Wang C, Wang WY, Yan X (2026). SOPBench: Evaluating language agents at following standard operating procedures and constraints. Proceedings of EMNLP 2026, pp. 21561–21616. https://aclanthology.org/2026.emnlp-main.936/. 七个客户服务领域中覆盖70个流程的830个经过验证的案例,按最终状态、每一个操作以及所要求核查的先后顺序评分;在其消融实验中,一份列出所要求核查项的明确检查清单使四个模型中两个的通过率下降,而提供真实的约束判定结果之后仍有12–38%的案例失败。
- Huang J, Chen X, Mishra S, Zheng HS, Yu AW, Song X, Zhou D (2024). Large language models cannot self-correct reasoning yet. ICLR 2024. arXiv:2310.01798. 在没有外部反馈的情况下,提示模型自我修正降低了准确率,例如GPT-3.5在CommonsenseQA上从75.8%降到38.1%。
- Kamoi R, Zhang Y, Zhang N, Han J, Zhang R (2024). When can LLMs actually correct their own mistakes? A critical survey of self-correction of LLMs. Transactions of the Association for Computational Linguistics 12: 1417–1440. doi:10.1162/tacl_a_00713. 自我修正主要在具有可靠外部反馈的任务中取得成功。
- Gou Z, Shao Z, Gong Y, Shen Y, Yang Y, Duan N, Chen W (2024). CRITIC: Large language models can self-correct with tool-interactive critiquing. ICLR 2024. arXiv:2305.11738. 以工具输出为依据的批评改进了答案;去掉这些工具之后,在问答和降低毒性这两类任务上大部分提升都消失了,但在数学程序合成上并非如此。
- Gloaguen T, Mündler-Sasahara N, Müller MN, Raychev V, Vechev M (2026). Evaluating AGENTS.md: are repository-level context files helpful for coding agents? Preprint. arXiv:2602.11988. 由模型撰写的上下文文件没有提高任务成功率,并使推理成本上升了20%以上;由开发者撰写的文件略有帮助,成本最多增加19%。
- ASD Simplified Technical English Maintenance Group (2025). ASD-STE100 Simplified Technical English, Issue 9. Aerospace, Security and Defence Industries Association of Europe. https://www.asd-ste100.org/. 一套用于技术文档的受控词汇和写作规则,最初是为飞机维修而制定的。
- International Organization for Standardization (2023). ISO 24495-1:2023 Plain language — Part 1: Governing principles and guidelines. https://www.iso.org/standard/78907.html. 四项原则(相关、可找到、可理解、可使用),以读者如何使用文档来判断是否成功。
- Shubert SK, Spyridakis JH, Holmback HK, Coney MB (1995). The comprehensibility of Simplified English in procedures. Journal of Technical Writing and Communication 25(4): 347–369. doi:10.2190/WG69-D74B-4DLL-2WBK. 对于人类读者,简化英语显著提高了较复杂流程的可理解性。
- Xiao R, Ma W, Wang K, Wu Y, Zhao J, Wang H, Huang F, Li Y (2024). FlowBench: Revisiting and benchmarking workflow-guided planning for LLM-based agents. Findings of EMNLP 2024, pp. 10883–10900. doi:10.18653/v1/2024.findings-emnlp.638. 在51个场景中,GPT-4o的会话成功率在没有工作流知识时为35.1%,在以文本、代码或流程图形式提供工作流知识时为41.7–43.2%。
- Tsuchida R, Fan Y, Shimari K, Kula RG, Matsumoto K (2026). Do coding agents follow AGENTS.md? The effect of policy wording on instruction compliance. Preprint. arXiv:2611.04367. 在一组86个编程任务上,同一条规定采用四种表述;对于两个Claude模型中能力较强的那个,直接表述的平均遵从率为78.0%,条件式表述为64.2%。
- Anschütz M, Damaratskaya A, Lee CJ, Schmalz A, Mosca E, Groh G (2025). (Dis)improved?! How simplified language affects large language model performance across languages. Proceedings of the GEM² Workshop, pp. 847–861. https://aclanthology.org/2025.gem-1.70/. 自动简化的任务文本大多降低了模型表现,在英语上最多下降20个点。
- abryfs (2026). agent-ste. GitHub repository, commit 7a2b81f (11 August 2026). https://github.com/abryfs/agent-ste. 作者自行报告的基准测试:在八项写作任务上的十二个模型中,测得的STE违规平均减少95.5%;没有测量下游的任务执行情况。
- Simpson SG (2010). The Gödel hierarchy and reverse mathematics. In Feferman S, Parsons C, Simpson SG (eds.), Kurt Gödel: Essays for his Centennial. Lecture Notes in Logic 33, Cambridge University Press, pp. 109–127. doi:10.1017/CBO9780511750762.008. 报告了核心数学中的数百条定理落入这五个类别,以及人造的理论可以互不可比,而自然的理论则排成一列。
- Patey L (2016). The reverse mathematics of Ramsey-type theorems. arXiv:1601.04428. 研究了大五元之外的定理,例如数对拉姆齐定理,并追问(§2.3)大五元模式是否反映了数学家所研究的命题中的偏向。
- Cowan N (2001). The magical number 4 in short-term memory: a reconsideration of mental storage capacity. Behavioral and Brain Sciences 24(1): 87–114. doi:10.1017/S0140525X01003922. 估计短时记忆的容量约为四个组块。
- Hájek P, Pudlák P (1993). Metamathematics of First-Order Arithmetic. Perspectives in Mathematical Logic, Springer. 表明具有给定量词复杂度的公式的真,可以在同样的复杂度上被定义,而塔斯基定理排除了适用于所有公式的单一真定义。
- Nemoto T, Ould MedSalem M, Tanaka K (2007). Infinite games in the Cantor space and subsystems of second order arithmetic. Mathematical Logic Quarterly 53(3): 226–236. doi:10.1002/malq.200610041. 二叉树(康托尔空间)上开博弈的决定性在RCA₀之上与WKL₀等价。
- Keisler HJ (2006). Nonstandard arithmetic and reverse mathematics. Bulletin of Symbolic Logic 12(1): 100–125. doi:10.2178/bsl/1140640945. 为大五元中的每一个给出了一个非标准的对应系统,它在相应的标准系统之上是保守的。
- Rathjen M (2017). Proof theory of constructive systems: inductive types and univalence. In Feferman on Foundations, Springer, pp. 385–419. doi:10.1007/978-3-319-63334-3_14; arXiv:1610.02191. 带有宇宙但不带W-类型的Martin-Löf类型论,无论是否加入泛等公理,都具有ATR₀的强度(序数Γ₀);带有W-类型时,它达到强得多的集合论。
- Eastaugh B (2024). Reverse mathematics. Stanford Encyclopedia of Philosophy, Metaphysics Research Lab, Stanford University. https://plato.stanford.edu/entries/reverse-mathematics/. 对大五元、它们的特征定理和证明论序数(ACA₀为ε₀,ATR₀为Γ₀)的综述。
- Kumar A, Zhuang V, Agarwal R, Su Y, Co-Reyes JD, Singh A, Baumli K, Iqbal S, Bishop C, Roelofs R, Zhang LM, McKinney K, Shrivastava D, Paduraru C, Tucker G, Precup D, Behbahani F, Faust A (2024). Training language models to self-correct via reinforcement learning. ICLR 2025. arXiv:2409.12917. 训练模型在两次尝试中改进自己的答案,测试时不需要外部反馈。
- Hong S, Zhuge M, Chen J, Zheng X, Cheng Y, Zhang C, Wang J, Wang Z, Yau SKS, Lin Z, Zhou L, Ran C, Xiao L, Wu C, Schmidhuber J (2023). MetaGPT: meta programming for a multi-agent collaborative framework. ICLR 2024. arXiv:2308.00352. 把人类软件团队的标准操作程序和角色编码成提示词序列,供一个由智能体组成的团队使用。
- Vijayaraghavan G, Jayachandran P, Murthy A, Govindan S, Subramanian V (2026). If you want coherence, orchestrate a team of rivals: multi-agent models of organizational intelligence. Preprint. arXiv:2601.14351. 描述了一个生产系统,它复用了由规划者、执行者和评审者构成、角色边界严格的企业组织结构。
- Haynes AB, Weiser TG, Berry WR, Lipsitz SR, Breizat AH, Dellinger EP, Herbosa T, Joseph S, Kibatala PL, Lapitan MC, Merry AF, Moorthy K, Reznick RK, Taylor B, Gawande AA; Safe Surgery Saves Lives Study Group (2009). A surgical safety checklist to reduce morbidity and mortality in a global population. New England Journal of Medicine 360(5): 491–499. doi:10.1056/NEJMsa0810119. 在八家医院中,核查表项目开始前有3,733名患者,开始后有3,955名患者:死亡率从1.5%降到0.8%,并发症发生率从11.0%降到7.0%。该项目包含培训和团队简报会;作者认为其机制是多因素的,并指出前后对照设计是一项局限。
- Urbach DR, Govindarajan A, Saskin R, Wilton AS, Baxter NN (2014). Introduction of surgical safety checklists in Ontario, Canada. New England Journal of Medicine 370(11): 1029–1038. doi:10.1056/NEJMsa1308261. 在101家医院中,校正后的死亡率在采用前为0.71%,采用后为0.65%(P = 0.13),并发症发生率分别为3.86%和3.82%(P = 0.29)。该省要求公开报告核查表的使用情况;没有要求进行正式的团队培训。
- Southern MG (2026). OpenAI founding member: make LLMs write like an aircraft manual. Search Engine Journal, 2 October 2026. https://www.searchenginejournal.com/karpathy-llm-aircraft-manual-writing/591813/. 报道了Andrej Karpathy的一则帖子,他建议让模型用ASD-STE100,或者做到其80%的程度,来解释事情,让人更容易读懂模型的输出。
- Ghinda L (2026). Explain to me in Simple Technical English. All About Coding, 14 August 2026. https://allaboutcoding.ghinda.com/explain-to-me-in-simple-technical-english. 一位开发者针对四段代码所做的测试,作者自己称其并不严谨:相对于没有风格指令时保留的47个事实,Claude在宽松的指令下丢失了4个,在完整的ASD-STE100下丢失了22个。
- Yu C, Yin L, Fan Q, Yu Y, Zhong RR, Li M (2026). Compile, then page: executable SOP programs and a capability-gated runtime for procedural LLM agents. Preprint. arXiv:2607.11346. 在一组经过筛选的125个SOPBench银行案例和六个模型上,由流程中机器可读的约束编译而成、并加入了核查步骤的伪代码,与官方的文字说明相比使成功率提高了0到16.0个百分点;只显示当前步骤帮助了最强的模型,却损害了最弱的两个模型。
- Xu X, Guo H, Shen G, Cheng S, Zhang X (2026). Natural-language workflows are not software yet: artifact-driven compilation for reliable agent execution. Preprint. arXiv:2608.21341. 把工作流编译成每个步骤都声明其读取和写入的产物之后,三个执行模型上的平均任务解决率从62%、46%和60%提高到85%、82%和85%(488个实例,11个工作流);更清晰的文本改写则达到66%、46%和76%。该编译器还加入了检查、明确的控制流、优化和验证,因此这一提升属于这一整套做法。
- Yuan S, Song K, Chen J, Tan X, Shen Y, Ren K, Li D, Yang D (2024). EasyTool: enhancing LLM-based agents with concise tool instruction. NAACL 2025. arXiv:2401.06201. 把工具文档改写成带有参数指引和示例的简明指令,使其在ToolBench上从2,530个token缩短到748个token,并使由GPT-4评判、在两个测试集上取平均的ChatGPT回答成功分数从15.0%提高到52.8%。
我们的记录:
- Biomedical Literature Evidence 1.0.0-public.1 验证记录:19个unittest方法通过;3条RIS和CSL-JSON记录中有3条保持为未核实状态;合成的“已完成但证据不足”台账检查(
completed: true, support_ready: false)。 - 孟德尔随机化(Mendelian randomization) 1.0.0-public.2 复现报告:Walker等人2019年研究v2,案例2(存档的163行中保留157行,19个核心单元格中有19个一致);在经过审计的大五元基准测试中,针对有限值、路由、SE、比值比和Benjamini–Hochberg族的检查54项中有54项得到核实(内部基准测试记录,尚无公开记录)。
- 荟萃分析(Meta-analysis) 1.0.0 性能报告:28篇开放获取的Cochrane系统评价,1,061项合并分析中的1,060项以及11,351个可核对的定量条目中的10,797个得到复现(95%);
ma_validate.py已修补为拒绝NaN/±Inf,并在32个stdlib单元测试、35,130个可检验的signed_z行(另有5,106行因缺失值而被排除)和存储的Holm计数上得到核实(内部基准测试记录,尚无公开记录)。 - Scientific Figure Master 1.1.2 技能页面:20条真实图注的61个评分字段中有61个正确;通用的OOXML
word/charts/chart1.xml和chart2.xml验证器抓住了Fig. S2(OA-10 = 0.9108 < 1.6225)和Fig. S3(NON-OA2与OA-1对比OA-1与OA-8)两处图注与图表之间的离群点矛盾(内部基准测试记录,尚无公开记录)。 - Grant Writing Master 7.0.0-public.1 验证记录和事实保留记录:阴性的预实验结果和非因果性的措辞在多轮修订和多种语言之间得到保留;SHA-256软件包来源以及字符数/字节数测量得到核实(内部基准测试记录,尚无公开记录)。
- Scientific Writing 1.1.0 发布说明:完整的稿件修订对比,并附有单独的编辑决定记录;
audit_numbers.py升级后具备基于stdlib的.xlsxXML数值与公式分离,以及明确的563 = 209 + 354DEG正文到CSV的绑定(内部基准测试记录,尚无公开记录)。 - Academic Peer Review 1.0.2 技能页面、基准测试和PeerJ 20995盲测评审:依据60份公开评审中的1,035条意见进行了校准;
screen.py升级后具备基于stdlib的.docx提取、针对持续单调序列的页边行号删除,以及按Methods分层的动物性别筛查(内部基准测试记录,尚无公开记录)。 - Big5c SOPBench试点研究(内部记录;完整研究将在arXiv上发表):七个SOPBench领域中覆盖20个流程的185个案例,在GPT-5.6 Luna和Gemini 3.8 Flash low上,就正确处理的案例和每案例token数比较通用反思、扁平验证和Big5c(Gemini有184个案例具有完整的token记录)。
- Big5c技能修复试点研究(内部记录;完整研究将在arXiv上发表):六个由Python支撑的合成科研工作流,每个都分别配以能正常工作的辅助脚本和有缺陷的辅助脚本各运行一次(每个模型12个任务),在GPT和Gemini上进行;Big5c和通用反思各自完成了12个任务中的12个,并修复了6个有缺陷的辅助脚本中的6个,在这12个任务上Big5c在GPT上少用了34.0%的token,在Gemini上少用了22.7%。节省来自配有能正常工作的辅助脚本的那六次运行:检查通过时,就会跳过评判环节。