以前の論考で私たちは、研究を監査するための規則(査読、文献の統合、メタアナリシス(meta-analysis)、因果推論、図のチェック、研究費申請の審査)は、出版から何年も経ってからではなく、作業が行われている最中にソフトウェアとして実行されるべきだと論じました。すると、すぐにもっともな疑問が浮かびます。生物学、臨床医学、統計学を見渡すと、別々の規則が何千もあるように見えます。サンプルサイズをチェックする、単位換算をチェックする、多重検定の補正をチェックする、抗体が標的に結合するかをチェックする、すべての時点で対照群が置かれたかをチェックする、2つのコホートの差が交絡因子で説明されるかどうかをチェックする、といった具合です。もし誤りの一つひとつに手書きの専用の規則が必要なのだとしたら、科学を監査するソフトウェアはどれも、増え続けるチェックリストの継ぎはぎにすぎず、つねに次の誤りの一歩後ろを追いかけることになります。
数学は50年前に同じ懸念に直面し、その継ぎはぎが錯覚であることを発見しました。Harvey Friedman、のちにStephen Simpsonと多くの同僚たちが、通常の数学の定理を証明するのに実際にはどの公理が必要なのかを問い始めたとき(逆数学と呼ばれるプログラムです)、整った答えが得られる保証は何もありませんでした [1] [2]。論理学者は、互いに比較することさえできない人工的な公理系を簡単に作ることができます [18]。しかし、実解析、代数学、組合せ論の定理を測ってみると、そのうち数百の定理が、弱い基礎体系で証明できるか、より強い4つの体系のどれかと同値であることがわかりました。つまり、はしごの段のように弱いものから強いものへと並ぶ、わずか5つのクラスです [2] [18]:
論理学者はこの5つの体系を大五元(だいごげん、Big Five)と呼びます [18]。対に関するラムゼーの定理のように、いくつかの有名な定理はこのはしごの外にあり、まさにその理由で研究されています [19]。異なる世紀、異なる文化のなかで生み出された定理が、なぜ同じ5つの箱に集まるのでしょうか。その答えはまだ誰にもわかっていません。まだ決着のついていない可能性の一つとして、Ludovic Pateyは、このパターンは数学者がどの命題を研究対象に選ぶかという偏りを反映しているのではないかと提起しています [19]。私たちはこれを一種の人間原理として読んでいます。ありうるすべての論理的命題が広大な高次元の空間をなしているとすれば、人間の数学者が探検しているのは、人間の頭が保持し、チェックし、学生に伝えることのできる、ごく小さな一角だけなのです。
この論考はまず、大五元の直観的な基礎から始めます。二人ゲーム、怪物関数、「非可逆圧縮のzipファイル」、そして数学的などんでん返しをたどりますが、これらがあるからこそ、逆数学は現代の論理学のなかでもとりわけ面白い分野の一つになっています。そのうえで、大五元の背後にある5つの認知的な一手が、nexitia.aiにある私たちの7つの研究スキルの検証アーキテクチャをどのように導いているかを示します。7つとは、biomedical-literature-evidenceスキル、メンデルランダム化(Mendelian randomization)スキル、メタアナリシス(meta-analysis)スキル、scientific-figure-masterスキル、grant-write-masterスキル、scientific-writingスキル、academic-peer-reviewスキルです。
定理が難しくなる理由:二人ゲームとしての量化子の交代
大五元のはしごを登る前に、もっと単純な問いを立ててみましょう。ある数学的な言明が、別の言明よりも人間の脳にとって(あるいはAIエージェントにとって)検証しにくいのは、なぜなのでしょうか。
数理論理学には量化子が2つしかありません。全称量化子 (「すべての…について」「任意の…について」)と存在量化子 (「…が少なくとも1つ存在する」)です。同じ量化子を何度重ねても、頭の負担はほとんど増えません。同じ量化子は一度の選択にまとめられるからです:
空間のなかで3つの数 を一度に選ぶことは、1つの数を選ぶことより難しくはありません。厄介になるのは、量化子が交代する瞬間からです( の次に 、その次に 、さらに )。交代のたびに、静的な言明は二人の対戦ゲームに変わります:
- はどれも、相手が指す一手です。相手は極端なところまで行って、あなたの主張にとって最悪の、もっとも扱いにくい場合を選びます。
- はどれも、あなたの側がその手に応じる一手です。相手がそれまでに指したすべての手を踏まえて、窮地を切り抜ける応手を選びます。
反転の回数が増えるにつれて、人間の脳がどれほど速く熱を帯びていくかを数えてみましょう:
- 反転0回(): ゲームはまったくありません。紙の上に並んだ数をそのまま読むだけです。
- 反転1回(): 「あなたがどんな数を挙げても、それより大きい数がある。」 この1ラウンドのゲームなら小学生でも勝てます。相手がどんな を出しても、 と答えればよいのです。
- 反転2回(): これはWeierstrassが与えた形の、極限の - 定義です。大学1年生が微積分で最初に本格的に頭を抱える、まさにその箇所です: これを3手のラリーとして読んでみましょう。第1ラウンド()では、相手が誤差の許容幅 を要求します。第2ラウンド()では、あなたがその に合わせて安全な近傍の幅 を計算します。第3ラウンド()では、相手があなたの の窓の内側から任意の点 を選び、 が成り立つかどうかを確かめます。反転2回()ですでに、訓練を受けていない直観の限界近くにあります。
- 反転3回():ワイエルシュトラスの怪物関数。 19世紀にKarl Weierstrassは、至るところ連続でありながら至るところ微分不可能な関数 、つまりどの尺度で見てもぎざぎざの鋸歯であるような関数を示して、数学者たちに衝撃を与えました。「どの点 にも接線の傾き は存在しない」と書くには、量化子の交代が3回必要です: 4手の対局がどう進むかを見てみましょう。第1手(相手): を選び、そこでの接線の傾きは のはずだと言い張ります。第2手(あなた): の近くでの振動の周波数を調べ、誤差の下限をたとえば と固定して、相手がどれほど拡大しても割線の傾きは から少なくとも は外れると宣言します。第3手(相手の反撃): 途方もなく小さな顕微鏡の窓 まで拡大し、局所的には曲線は滑らかになるはずだと賭けます。第4手(あなたのチェックメイト): の内側で、あなたは特定の刻み幅 を指し示します。そこでは曲線がまだ十分に急に波打っていて、割線の傾きを から より大きくずらします。あなたの決め手 は、入れ子になった4つの選択 に同時に依存しています。反転3回になると、図はもはや信頼できる道しるべではなくなります。直観はしばしば読み違え、問いに決着をつけるのは一歩ずつの記号的な検証です。
- 反転4回():エゴロフの定理と概念のzipファイル。 測度論のエゴロフの定理は、可測関数の列 が のほとんど至るところの点で収束するなら、測度をいくらでも小さい 未満に抑えた例外的な「悪い」集合 を取り除いたあと、残りの部分ではその列が一様収束する、と述べます: ここで、悪い集合 は に依存し、それ以降の項を考えるための番号 は と に依存します。人間のワーキングメモリが一度に保持できるのは、およそ4つのチャンクです [20]。私たち自身のゆるやかな類推で言えば、量化子の交代4回は、経験を積んだ数学者でさえ計算用紙を見つめながら頭がくらくらし始めるところです。
では、数学は反転4回を超えて、どうやって前に進み続けたのでしょうか。概念をカプセル化することによってです。つまり、量化子の連鎖の後ろ半分を、zipファイルのように、名前のついたブラックボックスに詰め込むのです。 末尾の を「 の外で一様収束する」という一つの句にまとめてしまえば、エゴロフの反転4回の怪物は、行儀のよい反転1回の文に縮みます:。2世紀にわたって、数学はこうしたzipファイルを積み重ねることで登ってきました。CauchyとWeierstrassは無限小の議論を極限に詰め込み、Poincaré、Fréchet、Hilbertは極限を位相と関数空間に詰め込み、Alexander Grothendieckは幾何学的な空間をスキームとトポスに詰め込んで、その上に新しい1-2-3-4のはしごを築きました。
しかし、概念の圧縮は読み手にとっては非可逆です。定義はあらゆる細部を保っていますが、名前はその下にある依存関係を隠してしまいます。7つの入れ子になった定義の上に載った、すっきりした1行の定理 を同僚に手渡すことはできますし、それは反転0回の等式のように見えます。ところが、査読者がその定理を監査しようとした瞬間、7つの層すべてを一度に解凍しなければならず、隠れていた量化子の依存関係が雪崩のように押し寄せてきます。さらに悪いことに、Alfred Tarskiが1930年代に定義不可能性定理で証明したように、算術のどんな論理式も、算術のすべての論理式に対する真理を定義することはできません。真理は、制限された論理式のクラス1つずつについて、水準ごとに定義することはできますが、1つの論理式ですべての水準を一度にチェックすることはできません [21]。左足で自分の右足を踏んで、らせんを描いて空へ昇っていくことはできません。どのチェックも明示された範囲だけを対象とし、それ以上は対象としません。これが、以下のはしごに私たちが持ち込む直観です。
逃げ道がどれも大五元に戻ってくる理由
逆数学が面白いのは(森のなかのどの道をたどっても同じ小屋に戻ってしまう、数学版の怪談のようですが)、20世紀の数学が新しい基礎の上に建て直されるたびに起きたことです。私たちはそれを3つの脱出の試みとして語ります:
- 脱出の試み1:無限ゲームと必勝戦略。 論理学者は、交代する手の無限の連鎖 を、スコーレム関数 , で置き換えようとしました。スコーレム関数は、一方のプレイヤーがそれまでのすべての手にどう応じるかを記録するものです。これによって連鎖は完全情報の無限ゲームになり、ゲームに勝利集合が定められれば、問いはただ一つになります。二人のプレイヤーのどちらかが必勝戦略 を持つか、という問いです。しかし、有限の履歴のそれぞれに次の一手を対応させる戦略 は、それ自体が無限の対象であり、 通りのありうる戦略のなかの1つの選択です。必勝戦略の存在を保証するのに必要な公理を論理学者が測ってみると、ゴールで待っていたのは大五元でした。二分木の上で行われる開ゲームは に行き着き [22]、自然数の有限列全体の木の上では、開ゲーム、さらには開かつ閉(clopen)なゲームでさえ に行き着き、勝利集合が開集合と閉集合の共通部分であるゲームは に行き着きます [2]。
- 脱出の試み2:Abraham Robinsonの超実数の無限小()。 1960年代に超準解析は、数学者が実際の無限小 で、学校で習う分数と同じように割り算できるようにすることで、微積分の反転2回の - の頭痛をなくすと約束しました。H. Jerome Keislerが超準算術をこのはしごに照らして測ったとき、彼は大五元のそれぞれに対応する超準版を構成しました。そして、どの超準版も、自分の段を超える新しい標準的な定理を証明しません。たとえば、彼の超準版の は 上で保存的です [23]。新しい衣装をまとっていても、中身は同じ段なのです。
- 脱出の試み3:型理論とホモトピー型理論(HoTT)。 計算機科学者は、集合を型とプログラムで置き換えました(「命題は型、証明はプログラム」)。証明論の研究者がその結果を測ってみると、宇宙の階層を持つが帰納的な 型を持たないMartin-Löf型理論は、Voevodskyの一価性公理を加えた場合でさえ、ちょうど の強さを持ち、証明論的順序数も同じ であることがわかりました [24]。 型を加えると、大五元のどの段よりもはるかに上まで強くなります。これは、このはしごが記述しているのは通常の数学であって、構築しうるあらゆる体系ではないことを示しています。
集合、ゲーム、無限小、型と、記法をどのように着せ替えても、人間による検証もアルゴリズムによる検証も、同じ5つの段に戻ってきます。私たちはこの5つの段を、私たち自身の解釈として、5つの認知的な一手として読んでいます:
1. (実行):コンピュータが一歩ずつ計算できるもの
土台の段である再帰的内包公理()が保証するのは、すでに手元にある集合からチューリング機械が計算できる集合だけです( 内包)[2] [3]。数学では、 は有理数の算術、行列代数、中間値の定理を扱います [2]。科学の監査では、実行は有限の算術、単位の代数、線形代数の領域です。 が成り立つか、スプレッドシートのセルが、使うと称している列を参照しているか、 のために標本共分散行列が特異になっていないか()、あるいはサンプルサイズ がどれだけの最小検出可能効果量()を支えられるか、をチェックします。
2. (選択とコンパクト性):枝分かれする迷路に完全な道を一本通す
2番目の段は弱ケーニヒの補題()を加えます。すべての深さに頂点を持つ無限二分木は、根からすべての階層を通る途切れのない道を少なくとも1本含む、という補題です [2] [4]。一度に1つの階層しか見ない有限のアルゴリズムは、どの枝が50歩先で行き止まりになるかをいつも見分けられるわけではありません。 は、局所的な一歩ごとの整合性を完全な大域的な道へと橋渡しするコンパクト性の原理です( 上で、ハイネ=ボレルの定理およびゲーデルの完全性定理と同値です)[2]。実験研究では、研究デザインは選択が枝分かれしていく木です(時点 遺伝子型 mRNA/タンパク質の測定値 群ラベル)。連続した加齢の軌跡や薬剤によるレスキューを主張することは、その木のすべての階層を通して、欠落も矛盾もなく証拠をたどれると主張することです。6か月と12か月の枝を黙って落とした道でも、mRNAとタンパク質のあいだで方向が逆転する道でも、図の凡例とMethodsのあいだで群ラベル (YY-Y, YO-Y) が入れ替わる道でもありません。
3. (安定化と停止問題のジャンプ):探索の族全体の極限を集める
3番目の段である算術的内包公理()は、自然数の上を動く量化子を使って定義されるどんな集合でも作れるようにします。 上では、これは 内包と同値です [2]。計算可能性理論では、これは任意の集合に対して、その集合に相対化したAlan Turingの停止問題のオラクル(チューリングジャンプ )を与えることにあたります [2] [3]。解析学では、すべての有界数列は集積点を持つというボルツァーノ=ワイエルシュトラスの定理と同値です [2]。 のスクリプトは、研究者が検定を次々に実行するのを見ていることはできますが、ループの外に出て、検定された 個の仮説の族全体 を1つの対象として集めるには、 になぞらえて名づけた安定化の規則が必要です。たとえば、40,236個の遺伝子モデルのうちいくつがホルム法によるファミリーワイズエラー率の制御を生き残るか、61種の代謝物にわたる定和正規化が見かけ上の負の共分散を強制していないか、一つ抜き交差検証の前に上位の特徴量を選択したことでテスト用のフォールドが訓練に漏れていないか、をチェックします。
4. (階層化):水準を混ぜずに、ものさしに沿って階層を積み上げる
4番目の段である算術的超限再帰()は、任意の可算な整列順序 に沿って内包のジャンプを反復することを許します(順序数は、通常の算術の順序数であるGerhard Gentzenの をはるかに超えて登っていきます)。その証明論的順序数は 、すなわち、しばしば可述性の限界と呼ばれるフェファーマン=シュッテ順序数です [5] [25]。その認知的な一手は階層化です。順序づけられた構成の水準を厳密に分けておき、低い水準が高い水準になりすますことができないようにします。科学論文の原稿では、証拠は順序づけられた層の上にあります:
- 文書のセクション:
参考文献(引用文献)序論方法(この研究で実際に実行した内容)結果考察。 - 生物学的な水準:
in silicoの予備研究不死化細胞株単一の性別の動物コホート種間の生態学的平均値ヒトの臨床コホート。
この順序が記録しているのは、それぞれの水準が、なされている主張からどれだけ離れているかであって、その証拠がどれだけ強いかではありません。素朴なキーワードスクリプトが、動物実験が両性を使ったかどうかをチェックするためにPDF全体から "male" と "female" を検索すると、References のセクションにある論文タイトルが "male" に言及していると、雌のマウスしか使っていない Methods のセクションに対する警告が出なくなってしまうことがあります。規則をチェックする前に文書をセクションごとに階層化しておけば、低い層のテキストが高い層の検証を汚すのを防げます。
5. (自己省察):競合する説明の空間全体を見渡す
5番目の段である 内包()は、非可述的な内包を加えます。すべての部分集合にわたる全称量化()によって定義される集合を作るのです [2]。その認知的な一手は自己省察です。ある主張が、選ばれた1本の道だけでなく、周囲の空間にある競合する集合 のすべてに対して生き残るかどうかを試します。科学では、どんな因果的な主張も、競合する臨床的な交絡因子(年齢、BMI、手術での採取経路)、共溶出する鏡像異性体(D-galactose 対 L-galactose)、あるいは水平多面発現の経路のどれも、その観察を同じくらいうまく説明することはない、と主張しています。
5つの手を私たちの7つのスキルに対応づける、そして敵対的な監査が教えてくれたこと
もちろん、有限の原稿の上で動くPythonの検証スクリプトが、文字どおり停止問題を解いたり、 の非可算個の部分集合にわたって量化したりするわけではありません [2]。そうではなく、大五元の5つの手(実行、選択、安定化、階層化、自己省察)は、第一世代の検証スクリプトがなぜこれほど多くの科学的な誤りを見逃すのかを明らかにします。私たちのベースラインのスクリプトのほとんどすべては、第1段()の構文的な表面にとどまっていて、ある数値がソースのプールに現れるか、URLが解決できるかはチェックしても、木の完全性、仮説の族の多重性、セクションの階層化、競合する交絡因子はチェックしていません。
以下に、この5つの手がnexitia.aiの7つのスキルのそれぞれにどう対応するか、そして、私たちのベースラインのスクリプトと大五元の検証スイートの両方を、6つの実際の研究リポジトリにわたる2巡にわたって評価するベンチマークと独立した敵対的なコード監査にかけたときに何が見つかったかを示します:
- biomedical-literature-evidenceスキル:
- 既存の公開記録: PubMed/PMCの検索クエリを記録し、重複するコホートの論文から研究を区別し、取り込んだRIS/CSL-JSONの引用をチェックされるまで未確認として保持し(検証記録では3件中3件)、レビューの台帳が「証拠が不十分である」と結論することを許します。
- 大五元との対応: 実行()は物理単位を解析するので、粒子数(
particles/g、MPs/g、filaments/individual)が熱分解GC/MSの質量濃度(ug/g)であるかのように統合されることは決してありません。階層化()は、換算係数が欠けているときに黙って で代用することを拒みます。そして自己省察()は、統合の前に撤回された文献に印をつけます。
- メンデルランダム化(Mendelian randomization)スキル:
- 既存の公開記録: Walker et al. 2019について、アーカイブされた関連の行163行のうち157行を推定用に保持し、主要な比較結果を示すセル19個すべてと一致し(再現レポート)、本文とTable 4の食い違いに印をつけています。
- 大五元との対応: 実行()は、有限の標準誤差、 統計量、アウトカムの尺度に応じたオッズ比の変換を検証します。選択()は、推定量の決定論的な振り分けを強制します( ならWald比、 ならIVW、 ならIVW+加重中央値+MR-Egger)。安定化()は、計画された曝露の族全体()と中核の族()の両方について、Benjamini–Hochbergの偽発見率の 値を同時に再計算します(私たちのベンチマークでは、有限値・振り分け・多重性のチェック
54 of 54を確認)。そして階層化/自己省察(–)は、実行されていないSteigerの方向性、 の希釈、多変量の条件づけを、レポートがそれらに合格したかのようにほのめかすことを許さず、明示的にunavailableと記します。
- メタアナリシス(meta-analysis)スキル:
- 既存の公開記録: 28件のコクランレビューにわたって、統合解析1,061件のうち1,060件、チェック可能な定量的項目11,351件のうち10,797件(95%)を再現しています(性能レポート)。
- 大五元との対応: 実行()は、定義域との比較の前に
NaN/±Infの入力を拒否し(私たちがma_validate.pyで見つけて修正したバグです)、.xlsxのワークシートXML(xl/worksheets/sheet*.xml)を、キャッシュされた値と数式の文字列を厳密に分けたまま抽出し、40,236行の種横断的な遺伝子表のうち検証可能な35,130行すべてについてsigned_z == local_beta / local_seを検証します(残りの5,106行は値を欠いており、合格ではなく除外として記録されます)。安定化()は、保存されているホルム法の多重性の合格数(0 of 40,236)が要約の台帳と一致することをチェックします。
- scientific-figure-masterスキル:
- 既存の公開記録: 20件の実際のキャプションにわたって、採点対象のキャプション項目61個のうち61個を解析し(スキルページ)、再計算した 値が のときには有意性の星印を描くことを拒みます。
- 大五元との対応: 実行と選択(–)は、投稿されたWordファイルの内部に埋め込まれたOffice Open XMLのグラフキャッシュ(
word/charts/chart*.xml)を直接調べ、プロットされた外れ値の完全な集合を図のキャプションと比較します。あるメタボロミクスの補足資料に対する私たちの敵対的な監査では、この汎用のグラフキャッシュ解析器が、OCRも人間の査読者のメモも必要とせずに、注目すべき二重の矛盾を見つけ出しました。Fig. S2(chart1.xml)では、キャプションはサンプルOA-5、OA-7、OA-10が臨界値(1.6225)を超えたと主張していましたが、保存されたグラフキャッシュではOA-10は0.9108にあり、線よりかなり下でした。Fig. S3(chart2.xml)では、キャプションは臨界値(2.2026)を超えるものとしてOA-1とOA-8を挙げていましたが、グラフのデータで実際にその臨界値を超えていたのはNON-OA2とOA-1でした。
- grant-write-masterスキル:
- 既存の公開記録: 有意でなかったパイロット試験の結果()と非因果的な言い回しを、改訂や言語をまたいで保持します(検証記録、事実保持の記録)。
- 大五元との対応: 実行()は、明示されていない申請ポータルの上限を勝手に作り出すことなく、文字数、UTF-8のバイト数、東アジア文字の表示幅を計測し、SHA-256を用いてパッケージの来歴を
PROVENANCE.jsonと照合し、検証します。選択と自己省察(–)は、仮説のDAGを構造化して、不死化細胞株がin vivoの主張を支える唯一の枝として残されることが決してないようにし、並行するフェローシップと研究プロジェクトの助成金がそれぞれ別の範囲を保つようにします。
- scientific-writingスキル:
- 既存の公開記録: 報告された検定統計量をソースファイルと照らしてスクリーニングし、編集上のメモを出版用のファイルに入れないようにします(リリースノート)。
- 大五元との対応: 実行()は、本文中の発現変動の主張(
563 DEGs: 209 up-regulated and 354 down-regulated)を、補足のCSV表で計算された件数に直接結びつけます。またaudit_numbers.pyを、依存ライブラリなしの.xlsxXMLリーダーで強化し、セルの座標(U2、1000)が数値の証拠プールを汚すことなく、すべてのワークシートと共有文字列を調べられるようにします。選択()は、mRNAとタンパク質の測定値を分析対象、対比、時点ごとに対にするので、有意でないタンパク質のデータは、確認されたレスキューとしてではなく、結論が出ていないものとして報告されます。
- academic-peer-reviewスキル:
- 既存の公開記録: 60件の公開査読にわたる1,035件の査読者コメントに照らして較正されています。盲検のウェットラボ投稿原稿では、行単位の査読者の指摘49件のうち6件を捉え、v1からv2への変更9件のうち5件を要求しました(スキルページ、ベンチマーク、PeerJ 20995の盲検査読)。
- 大五元との対応: 私たちは3つの構造的な強化を
screen.pyに直接バックポートしました。依存ライブラリなしの.docxXMLリーダー、保守的な余白の行番号の正規化(余白の番号らしきものを取り除く前に、途切れなく連続した並びがあることを要求するので、行の折り返しにある孤立した数は保持されます)、そして のセクション階層化です。このセクション階層化は、動物の性別のスクリーニングをMethods(またはReferencesより前の本文)に限定し、単一の性別のみという範囲を、性別の報告の欠落とは別に印づけるので、Referencesにある文献のタイトルが単一の性別の実験を覆い隠すのを防ぎます。
これらのチェックは、それぞれが想定して作られた特定の誤りを捉えます。AIエージェントがまだ作業している最中に、この構造をどうやってよりよい判断へと変えるかが、次の節で取り上げる問いです。
AIエージェントが自分の作業をチェックするために必要なもの
商品の交換を処理しているエージェントを考えてみましょう。エージェントは注文を調べることはできても、その件を決める問いを見落とすことがあります。顧客が交換したい商品は、ポリシーにある条件を満たしているのか、という問いです。上の5つの段は、完成した文書を監査するために作られたものです。これをその1件の交換に当てはめると、次のように読めます。注文の日付と合計を計算する(実行)。この種類の商品に適用されるポリシーの枝をたどる(選択)。その注文にあるすべての商品と過去の返品をまとめて見る(安定化)。顧客が言っていることと、システムが記録していることを分けておく(階層化)。そして、ポリシーのなかのどれかの例外が答えを変えないかを問う(自己省察)。ここで私たちは、同じ構造が、まだ作業している最中のエージェントの助けになるのか、そして私たち自身の研究の外にある証拠が何を語っているのかを問いました。
その証拠は、一つの点についてははっきりしています。答えを考え直すようにモデルにただ求めるだけでは、ひどい失敗に終わることがあります。ある検証では、GPT-3.5は自己修正を求められたあと、頼りになる新しい情報が何もないまま、CommonsenseQAでの正答率が75.8%から38.1%に下がりました [7]。自己修正は、エージェントが検索エンジン、コードインタープリター、判定を返すテストなど、自分自身の外にあるものを参照できるときに、より信頼できるものになります [8] [9]。モデルを自己修正のために特別に訓練することも、もう一つの道です [26]。外部のチェックが役に立つのは、モデルがまだ持っていない証拠を持ち込むからです。
同じ証拠は、構造が多いほどつねによいと決めてかかることにも警告を発しています。以下で私たちが使うベンチマークであるSOPBenchの著者たちは、それぞれの手順が必要とする検証を明示したチェックリストを4つのモデルに与えました。すると、そのうち2つのモデルで合格率が下がり、1つのモデルでは安全でない行動が21件から74件に増えました [6]。すべての制約について正しい判定をエージェントに手渡した場合でさえ、かなりの割合のケースがなお失敗し、その割合は4つのモデルで12%から38%でした。行動するか拒否するかという最後の選択が、依然として難しかったからです [6]。コーディングエージェントでは、モデルが書いたリポジトリの指示ファイルは、成功率を上げることなく、推論コストを20%を超えて増加させました [10]。指示はタダではありません。規則を1つ加えるたびに、エージェントが読んで重みを判断しなければならないテキストが増えるのです。
行動をレビューする3つの方法
汎用リフレクション(generic reflection)は、エージェントに自分の作業を考え直すよう求め、何をチェックする必要があるかの判断はモデルに任せます。フラット検証(flat verification)は、レビューすべき要件を明示したチェックリストをエージェントに与えます。Big5cはBig-5 compilerの略で、上で述べた5つの段を使ってレビューを組み立てます。提案された行動について、エージェントは、どの事実を確立したか、それらの事実がどの選択を支えるか、どの前提条件が未解決のまま残っているかをチェックします。欠落を見つけると、修正を求め、その結果をもう一度チェックします。交換の例で言えば、それはポリシーを注文のなかのその特定の商品に結びつけることを意味します。
このパイロット試験では、ベンチマークを1つ使いました。SOPBenchです。これは、エージェントが、自分の行動を律する規則に従いながら顧客の依頼を完了できるかどうかをテストします。その著者たちは、70の手順をカバーする830件の検証済みのケースを、最終状態、各ステップ、そして必要な検証が行動より前に行われたかどうかをチェックするコードとともに提供しています [6]。
私たちは両方のモデルを、同じ20の手順をカバーする185件のケースでテストしました。ケースの内訳は、オンラインショッピング(49)、医療(40)、銀行(27)、自動車関連の行政サービス(27)、ホテル(25)、大学(13)、図書館(4)です。表は、正しい拒否を含めて正しく処理されたケースの割合と、1ケースあたりに使われた平均トークン数を示しています。
| レビュー手法 | GPT-5.6 Lunaの成功率 | Gemini 3.8 Flash lowの成功率 | GPTの1ケースあたりトークン数 | Geminiの1ケースあたりトークン数 |
|---|---|---|---|---|
| 汎用リフレクション | 63.8% (118/185) | 63.8% (118/185) | 58,178 | 105,821 |
| フラット検証 | 64.9% (120/185) | 59.5% (110/185) | 57,198 | 104,921 |
| Big5c | 87.6% (162/185) | 88.1% (163/185) | 73,902 | 116,664 |
トークン数の平均は、それぞれのモデルのなかで、3つの手法すべてについて同じケースを使っています。Geminiの1件のケースでは汎用リフレクションのトークン数が欠けていたため、Geminiのコスト比較には184件のケースが残りました。
GPT-5.6 Lunaでは、Big5cは成功率を汎用リフレクションより23.8パーセントポイント、フラット検証より22.7ポイント改善しました。成功したケースが1件増えるごとのコストは、汎用リフレクションと比べて約66,100トークンの追加、フラット検証と比べて約73,600でした。Gemini 3.8 Flash lowでは、改善幅はそれぞれ24.3と28.6パーセントポイントで、成功が1件増えるごとに、それぞれ約45,300と41,600トークンの追加でした。
これらのコストは、トークンの記録がそろっているすべてのケースで使われた追加のトークン数を、同じ集合での成功ケースの純増数で割ったものです。
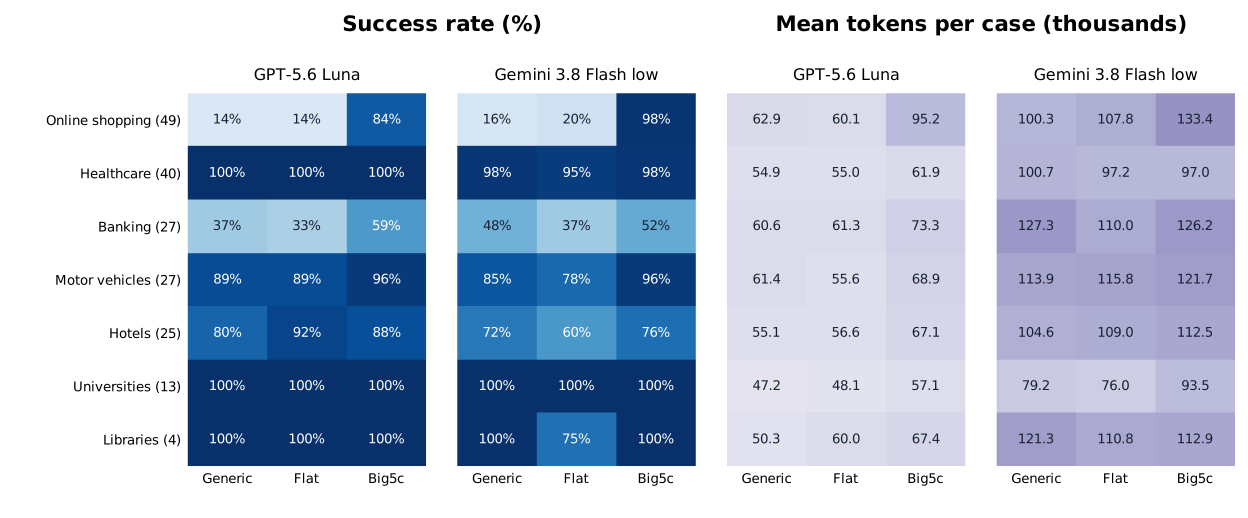
行はサービスのドメインを示し、括弧内はケース数です。各行を横に読むと、3つのレビュー手法を比較できます。成功率にはすべてのケースを使っています。トークン数の平均には、それぞれのモデルのなかで3つの手法すべての記録がそろっているケースを使っています。
パイロット試験が教えてくれること
エージェントにチェックリストを与えることは、2つのモデルで異なる効果をもたらしました。汎用リフレクションと比べて、フラット検証はGPTでは成功が2件多く、Geminiでは8件少なくなりました。Big5cは、両方のモデルで、どちらの手法よりもよい結果でした。一つのもっともらしい説明は、チェックリストはエージェントに適格性を検証するよう伝えることはできるが、修復ステップは、証拠が欠けているときにエージェントがすべきことを与える、というものです。パイロット試験はワークフロー全体を測定したので、5つの段のそれぞれの寄与は未解決の問いとして残っています。
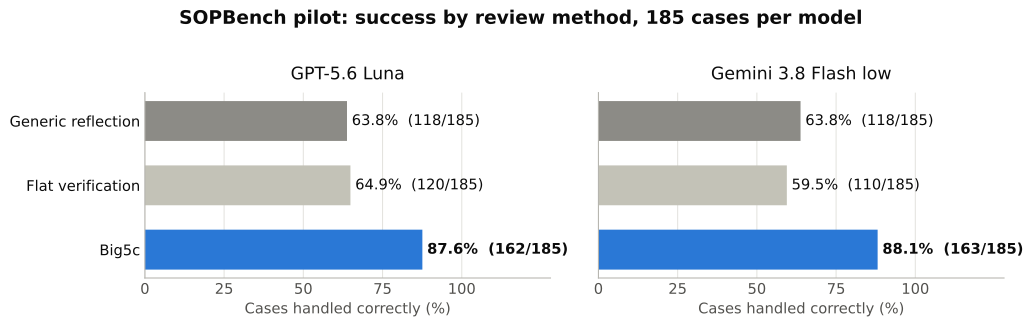
それぞれの棒は、同じ185件のケースのうち、1つのレビュー手法が正しく処理した割合です。件数は括弧内に示しています。
追加のレビューは、結果が変わらなかったケースでもトークンを使いました。どこにこれを使うかを選ぶ研究者にとって大事な問いは、正しく処理されるケースが1件増えることにどれだけの価値があるかです。その判断は手順によって変わるでしょう。オンラインショッピングは49件、図書館は4件のケースを占めていたので、全体の割合が教えてくれるのは、個々のサービスについてよりも、この特定の依頼の組み合わせについてです。
構造化されたレビューは、どこでトークンを節約したのでしょうか。Geminiの医療ドメインでの実行が、もっともはっきりした例です。Big5cと汎用リフレクションはどちらも40件中39件のケースに合格しましたが、Big5cのほうが1ケースあたり約3,760トークン少なく済みました(3.7%)。トレースには、Big5cでは150回、汎用リフレクションでは159回のツール呼び出しが記録されています。呼び出しの並びが短ければ、エージェントが作業しながら読むツールの結果が少なくなるので、トークンを節約できます。ここではそれが一つのもっともらしい説明です。フラット検証と比べると、節約は1ケースあたり約170トークン(0.2%)にとどまり、成功は1件多くなりました。
ツール呼び出しで説明できるのは、このパターンの一部だけです。図書館の4件のケースでは、Geminiは4件すべてに合格し、Big5cでも汎用リフレクションでも15回の呼び出しを行いましたが、それでもBig5cのほうがトークンが6.9%少なくなりました。エージェントが読んだり生成したりするテキストの量は、同じ呼び出し回数のなかでも変わりうるのです。銀行では、GeminiのBig5cでの実行は、汎用リフレクションよりわずかにコストが低く、フラット検証よりは高くなりました。GPTでは、Big5cはどのドメインでも、ほかの2つのどちらよりも平均して多くのトークンを使いました。これらの違いから、本研究で検討すべき一つの問いが浮かび上がります。欠けている前提条件を捉えることで省ける作業が、それをチェックするコストを上回るのは、どのようなときでしょうか。
2つ目の、より小さなパイロット試験が、一つの答えを指し示しています。私たちは6つの人工的に構成した研究ワークフローを2回ずつ実行しました。1回は正しく動くヘルパースクリプトで、もう1回は欠陥のあるヘルパースクリプトで実行したので、1つのモデルにつき12個のタスクになります。Big5cと汎用リフレクションはどちらも、12個のタスクすべてで正しい最終的な答えを出し、6つの欠陥のあるヘルパーすべてを修復しましたが、12個のタスク全体で見ると、Big5cが使ったトークンはGPTで34%少なく、Geminiで23%少なくなりました。この節約は、ヘルパーがもともと正しく動いていたワークフローから生まれました。チェックが実行可能で、それに合格すれば、エージェントは批評をまるごと省略できるのです。
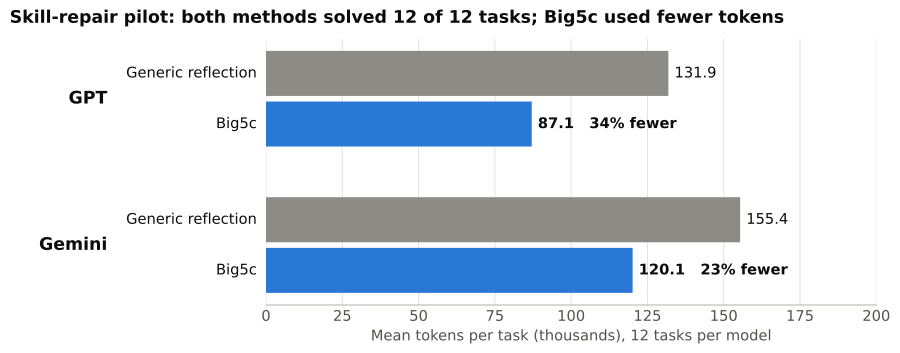
1つのモデルにつき12個のタスクにわたる、1タスクあたりの平均トークン数(千単位)。どちらの手法も12個すべてで正しい答えを出しました。
人をマネジメントするようにAIエージェントをマネジメントする
このパイロット試験は、どの個別の数値よりも私たちの興味を引く一つの考えを指し示しています。組織が人間の仕事を信頼できるものにするために使っている方法は、同じようなやり方で、AIエージェントの仕事も信頼できるものにするかもしれない、という考えです。同じ考えの上にシステムを築いた人たちがほかにもいます。MetaGPTは、ソフトウェア会社の標準作業手順(SOP)と職務上の役割を、AIエージェントのチームに組み込んでいます [27]。より最近のあるシステムは、エージェントを、役割の境界を厳密に定めたプランナー、実行者、批評者として配置しています。その理由は、AIエージェントは「私たちがこれまでに雇ってきたすべての人間とまったく同じように」誤りうる存在であり続ける、というものです [28]。
人間の品質マネジメントは、私たちの表を読む一つの方法も与えてくれます。汎用リフレクションがするように、エージェントに自分の作業を考え直すよう求めることは、人に「もっと注意しなさい」と言うのと同じです。チェックリストだけでは、一方のモデルにはプラスに働き、もう一方のモデルにはマイナスに働きました。外科もまた、チェックリストを採用してもどこでも同じ改善が得られるわけではないことを見いだしています。8つの病院が、スタッフの研修と、各手術の前後のチームブリーフィングを伴うプログラムとして、WHOの手術安全チェックリストを導入したとき、術後の死亡は、プログラム前の3,733人の患者の1.5%から、プログラム後の3,955人の患者の0.8%に下がりました [29]。オンタリオ州の101の病院が、州がチェックリストの使用状況の公表を義務づける方向に動くなかでチェックリストを採用したときには、そのほとんどが教育プログラムを伴っていましたが、正式なチーム研修は義務づけられておらず、調整後の死亡リスクは0.71%から0.65%になりました。この変化は有意ではなく、著者たちは、WHOの研究を別にすれば、大きな効果を示した研究は、チェックリストを大がかりなチーム研修と組み合わせていたか、診療の全過程を対象とするより包括的なチェックリストを使っていたと指摘しています [30]。どちらもランダム化試験ではなく前後比較であり、どちらも何が違いを生んだのかを切り分けていません。私たちのパイロット試験が修復ステップを切り分けなかったのと同じです。2つの研究を合わせると、私たちがAIエージェントについて関心を持っている問いが浮かび上がります。チェックリストの周りのどのような実践が、そのチェックをよりよい判断に変えるのでしょうか。Big5cは、検証中の一つの答えです。それは、チェックが不合格になったあとに続く修復ステップと一体にしたチェックリストです。
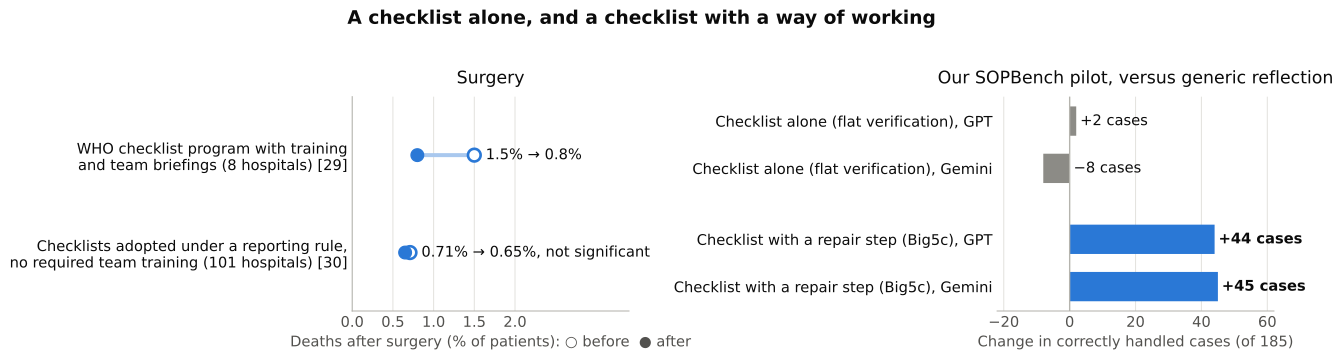
左:2つの研究における、チェックリストが導入される前後の術後死亡。2つの研究は異なる集団を追跡しており、オンタリオ州の割合は調整後の値です [29] [30]。右:私たちのパイロット試験で、汎用リフレクションと比べたときの、正しく処理されたケース数の変化。1つのモデルにつき185件中。
あらゆるマネジメントの道具のなかでもっとも古いのは、文書化された手順です。航空業界は、この問題の一つの形を何十年も前に解決しました。ASD-STE100、すなわちSimplified Technical Englishは、語彙と文の構造を制限して、整備士(その多くは英語を母語としない読み手です)が1つの指示をあいまいさなく読めるようにします [11]。ISO 24495-1は、プレインランゲージ(plain language)の4つの原則を定めています。読み手が必要なものを見つけられること、それを理解できること、それを使えること、そして内容が読み手に関連していることです [12]。人間の読み手については、Simplified Englishは複雑な手順を有意に理解しやすくしました [13]。
現在では多くの人がこれらの規格をAIに適用していますが、そのほとんどは一方向です。人がモデルの出力をより読みやすくなるように、モデルにSimplified Technical Englishで書くよう求めるのです。この規格の適用を助けるオープンなツールもすでにあります。その一つは、8つの執筆タスクと12のモデルにわたって、計測された違反を平均95.5%減らしたと報告しています [17]。Andrej Karpathyは2026年10月上旬にこのやり方を勧めました [31]。規格を名指しで求めることには、代償が伴うこともあります。ある開発者が4つのコード片で行った小さな検証では、Claudeの説明は、「Simple Technical English」を求められたときにはチェック対象の事実47個のうち4個を、ASD-STE100を求められたときには47個のうち22個を失いました [32]。
もう一つの方向、つまり手順に従わなければならないAIエージェントのために手順を書くことには、より強い証拠があります。そもそもエージェントにワークフローを与えること自体に効果があります。FlowBenchでは、GPT-4oが完了したセッションの割合は、ワークフローなしの35.1%から、ワークフローありでは41.7%から43.2%のあいだに上がりました。テキスト、コード、フローチャートのどれで書かれていても同様で、51のシナリオにわたる結果です [14]。2つのToolBenchテストセットでは、長いツールのドキュメントを、パラメータの手引きと例を備えた簡潔な指示に書き直すことで、その長さは3分の1未満になり、GPT-4が判定するChatGPTの回答成功スコアは15.0%から52.8%に上がりました [35]。手順を再構造化することも助けになります。選別された125件のSOPBenchの銀行ケースの集合では、手順の機械可読な制約を、明示的な検証ステップを備えた構造化された擬似コードにコンパイルすることで、6つのモデルにわたって、公式の文章版と比べて成功率が最大16.0パーセントポイント改善し(最大の改善では70.4%から86.4%)、どのモデルでも成功率は下がりませんでした [33]。自然言語のワークフローを、各ステップに明示的な入力、出力、チェック、制御フローを備えた実行可能なワークフローに変換するコンパイラは、11のワークフローからの488件のケースで、3つのモデルの平均でタスクの成功率を56%から84%に引き上げました。一方、同じワークフローをより明確なテキスト文書として書き直した場合は63%でした [34]。Big5cは、レビューについて同じ道をたどります。手順が要求することを5つの段の上のチェックにコンパイルし、不合格になったチェックのための修復ステップを加えるのです。
しかし、人の助けになるものがAIエージェントの助けになるとは限りませんし、あるモデルの助けになるものが別のモデルには害になることもあります。上のSOPBenchの研究では、手順の現在のステップだけをエージェントに見せるランタイムは、2つの強いモデルには助けになりましたが、GPT-4o-miniの成功率を、コンパイルされた手順全体を見せた場合の75.2%から48.8%に下げました [33]。言い回しは従順さを左右します。コーディングエージェントが、86個のコーディングタスクの集合で、4通りに言い換えられた1つのポリシーを受け取ったとき、2つのClaudeモデルのうち能力の高いほうの平均の遵守率は、直接的な言い回しでは78.0%、条件つきの言い回し(「もし…なら、…」)では64.2%でした [15]。これは注視すべき緊張関係です。Simplified Technical Englishは、読み手が先に知っておかなければならない条件を文の初めに置くからです [11]。人のために書かれた平易化が、自動的にモデルの助けになるわけでもありません。分類などのベンチマークタスクの入力テキストを自動的に平易化すると、言語モデルの性能は英語で最大20ポイント下がりました [16]。
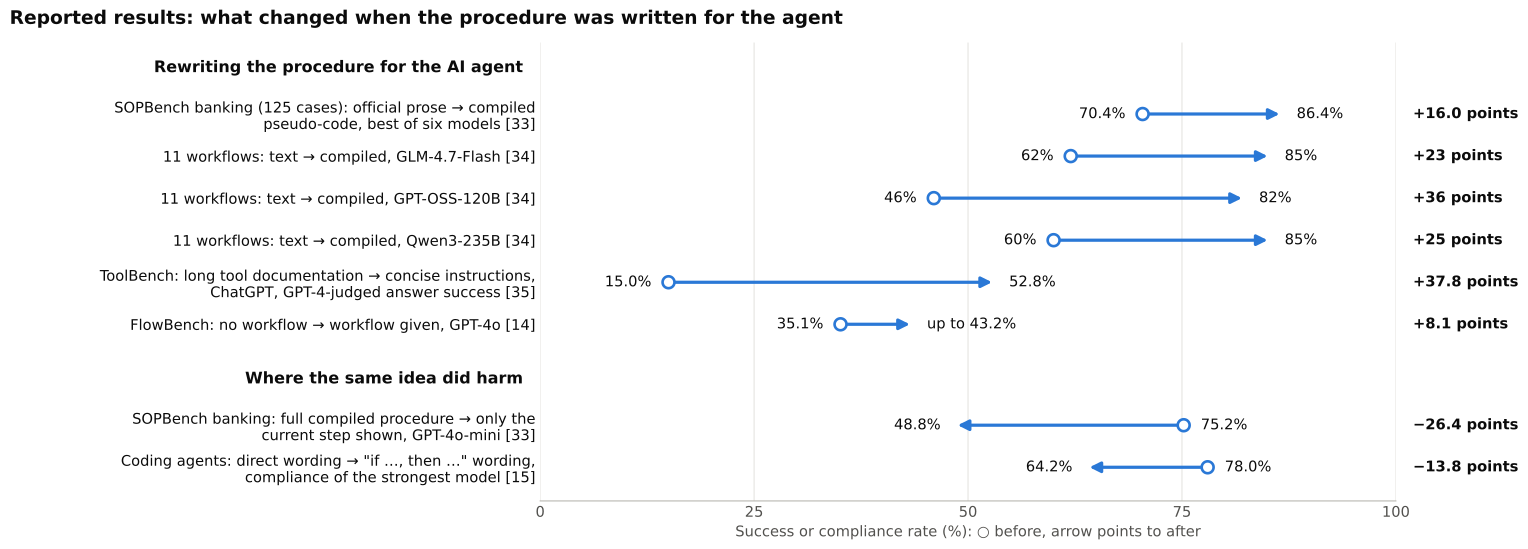
各行は報告された1つの結果です。丸は変更前の割合で、矢印は変更後の割合を指しています。研究によってタスクも指標も異なるので、行は1つずつ読んでください。
ですから私たちは、マネジメントの仕組み(文書化された手順、修復の手段を伴うチェック、分離された役割)はAIエージェントにも引き継がれると予想しています。一方で、人間の読み手のために書かれた言い回しの規則は、エージェントでもう一度テストしなければなりません。ASD-STE100またはISO 24495-1に明示的に合わせて書き直したエージェント向けの手順が、エージェントがより多くのタスクを完了する助けになるかどうかを検証した対照研究は、見つかりませんでした。
私たちは、Big5cの研究の全体を学術論文としてarXivで報告し、Big5cのエンジンをGitHubで公開します。
参考文献
- Friedman H (1975). Some systems of second order arithmetic and their use. Proceedings of the International Congress of Mathematicians (Vancouver, 1974), Vol. 1, pp. 235–242. Canadian Mathematical Congress. 逆数学のプログラムを導入し、解析学の通常の定理が、弱い基礎理論の上で、二階算術の特定の集合存在公理と同値であることを示しています。
- Simpson SG (2009). Subsystems of Second Order Arithmetic, 2nd ed. Perspectives in Logic, Cambridge University Press. doi:10.1017/CBO9780511581007. 二階算術 と5つの主要な部分体系(、、、、)を定義し、それらと、計算可能な数学、ハイネ=ボレルのコンパクト性、ボルツァーノ=ワイエルシュトラスの収束、 までの順序数の階層、非可述的な集合の内包との関係を確立しています。
- Turing AM (1936). On computable numbers, with an application to the Entscheidungsproblem. Proceedings of the London Mathematical Society, Series 2, 42(1): 230–265. doi:10.1112/plms/s2-42.1.230. 有限の制御部と長さに限りのないテープを持つ機械によって計算可能な列を定義し、計算可能なチェック()を算術的内包()から分ける停止問題/決定問題が解けないことを証明しています。
- König D (1927). Über eine Schlussweise aus dem Endlichen ins Unendliche. Acta Litterarum ac Scientiarum Regiae Universitatis Hungaricae Francisco-Josephinae, Sectio Scientiarum Mathematicarum 3: 121–130. ケーニヒの無限補題、すなわち有限分岐の無限木はすべて無限の道を持つことを証明しています。これを二分木に制限したものが の公理です。
- Gentzen G (1936). Die Widerspruchsfreiheit der reinen Zahlentheorie. Mathematische Annalen 112: 493–565. doi:10.1007/BF01565428. 順序数 までの超限帰納法によって一階算術の無矛盾性を確立しています。これは、証明論と における順序数の階層の分析の基礎です。
- Li Z, Huang S, Wang J, Zhang N, Antoniades A, Hua W, Zhu K, Zeng S, Wang C, Wang WY, Yan X (2026). SOPBench: Evaluating language agents at following standard operating procedures and constraints. Proceedings of EMNLP 2026, pp. 21561–21616. https://aclanthology.org/2026.emnlp-main.936/. 7つのカスタマーサービスのドメインにある70の手順にわたる830件の検証済みのケースで、最終状態、各行動、必要な検証の順序を採点します。そのアブレーションでは、必要な検証を明示したチェックリストが4つのモデルのうち2つで合格率を下げ、真の制約判定を与えてもなお12–38%のケースが失敗しました。
- Huang J, Chen X, Mishra S, Zheng HS, Yu AW, Song X, Zhou D (2024). Large language models cannot self-correct reasoning yet. ICLR 2024. arXiv:2310.01798. 外部からのフィードバックなしに自己修正するようモデルに促すと、正答率が下がりました。たとえばGPT-3.5はCommonsenseQAで75.8%から38.1%に下がりました。
- Kamoi R, Zhang Y, Zhang N, Han J, Zhang R (2024). When can LLMs actually correct their own mistakes? A critical survey of self-correction of LLMs. Transactions of the Association for Computational Linguistics 12: 1417–1440. doi:10.1162/tacl_a_00713. 自己修正が成功するのは、主に、信頼できる外部フィードバックのあるタスクです。
- Gou Z, Shao Z, Gong Y, Shen Y, Yang Y, Duan N, Chen W (2024). CRITIC: Large language models can self-correct with tool-interactive critiquing. ICLR 2024. arXiv:2305.11738. ツールの出力に根ざした批評は答えを改善しました。ツールがなければ、質問応答と有害性の低減では改善のほとんどが消えましたが、数学のプログラム合成ではそうなりませんでした。
- Gloaguen T, Mündler-Sasahara N, Müller MN, Raychev V, Vechev M (2026). Evaluating AGENTS.md: are repository-level context files helpful for coding agents? Preprint. arXiv:2602.11988. モデルが書いたコンテキストファイルはタスクの成功率を改善せず、推論コストを20%を超えて増加させました。開発者が書いたファイルはわずかに助けになりましたが、コストは最大19%増えました。
- ASD Simplified Technical English Maintenance Group (2025). ASD-STE100 Simplified Technical English, Issue 9. Aerospace, Security and Defence Industries Association of Europe. https://www.asd-ste100.org/. 技術文書のための制限語彙と執筆規則の集まりで、最初は航空機の整備のために開発されました。
- International Organization for Standardization (2023). ISO 24495-1:2023 Plain language — Part 1: Governing principles and guidelines. https://www.iso.org/standard/78907.html. 4つの原則(関連性がある、見つけやすい、理解しやすい、使いやすい)を定め、成功は読み手がその文書をどう使うかによって判断されます。
- Shubert SK, Spyridakis JH, Holmback HK, Coney MB (1995). The comprehensibility of Simplified English in procedures. Journal of Technical Writing and Communication 25(4): 347–369. doi:10.2190/WG69-D74B-4DLL-2WBK. Simplified Englishは、人間の読み手にとって、より複雑な手順の理解しやすさを有意に改善しました。
- Xiao R, Ma W, Wang K, Wu Y, Zhao J, Wang H, Huang F, Li Y (2024). FlowBench: Revisiting and benchmarking workflow-guided planning for LLM-based agents. Findings of EMNLP 2024, pp. 10883–10900. doi:10.18653/v1/2024.findings-emnlp.638. 51のシナリオにわたって、GPT-4oのセッション成功率は、ワークフローの知識なしで35.1%、テキスト、コード、フローチャートのいずれかとしてそれを与えた場合で41.7–43.2%でした。
- Tsuchida R, Fan Y, Shimari K, Kula RG, Matsumoto K (2026). Do coding agents follow AGENTS.md? The effect of policy wording on instruction compliance. Preprint. arXiv:2611.04367. 86個のコーディングタスクの集合で、1つのポリシーを4通りの言い回しで与えました。2つのClaudeモデルのうち能力の高いほうでは、平均の遵守率は直接的な言い回しで78.0%、条件つきの言い回しで64.2%でした。
- Anschütz M, Damaratskaya A, Lee CJ, Schmalz A, Mosca E, Groh G (2025). (Dis)improved?! How simplified language affects large language model performance across languages. Proceedings of the GEM² Workshop, pp. 847–861. https://aclanthology.org/2025.gem-1.70/. 自動的に平易化されたタスクのテキストは、ほとんどの場合にモデルの性能を下げ、英語では最大20ポイント下がりました。
- abryfs (2026). agent-ste. GitHub repository, commit 7a2b81f (11 August 2026). https://github.com/abryfs/agent-ste. 作者自身の報告によるベンチマーク:計測されたSTE違反の減少は、8つの執筆タスクでの12のモデルにわたって平均95.5%でした。下流のタスクの実行は測定されていません。
- Simpson SG (2010). The Gödel hierarchy and reverse mathematics. In Feferman S, Parsons C, Simpson SG (eds.), Kurt Gödel: Essays for his Centennial. Lecture Notes in Logic 33, Cambridge University Press, pp. 109–127. doi:10.1017/CBO9780511750762.008. 中核的な数学の数百の定理が5つのクラスに収まること、そして人工的な理論は比較不可能になりうるのに対して自然な理論は一列に並ぶことを報告しています。
- Patey L (2016). The reverse mathematics of Ramsey-type theorems. arXiv:1601.04428. 対に関するラムゼーの定理のような、大五元の外にある定理を研究し、大五元のパターンは数学者が研究する命題の偏りを反映しているのかどうかを問うています(§2.3)。
- Cowan N (2001). The magical number 4 in short-term memory: a reconsideration of mental storage capacity. Behavioral and Brain Sciences 24(1): 87–114. doi:10.1017/S0140525X01003922. 短期記憶の容量を約4つのチャンクと推定しています。
- Hájek P, Pudlák P (1993). Metamathematics of First-Order Arithmetic. Perspectives in Mathematical Logic, Springer. 与えられた量化子の複雑さを持つ論理式に対する真理は、その同じ複雑さで定義可能であること、一方でタルスキの定理はすべての論理式に対する単一の真理定義を排除することを示しています。
- Nemoto T, Ould MedSalem M, Tanaka K (2007). Infinite games in the Cantor space and subsystems of second order arithmetic. Mathematical Logic Quarterly 53(3): 226–236. doi:10.1002/malq.200610041. 二分木(カントール空間)上の開ゲームの決定性は、RCA₀上でWKL₀と同値です。
- Keisler HJ (2006). Nonstandard arithmetic and reverse mathematics. Bulletin of Symbolic Logic 12(1): 100–125. doi:10.2178/bsl/1140640945. 大五元のそれぞれの体系について、対応する標準的な体系の上で保存的な超準版を与えています。
- Rathjen M (2017). Proof theory of constructive systems: inductive types and univalence. In Feferman on Foundations, Springer, pp. 385–419. doi:10.1007/978-3-319-63334-3_14; arXiv:1610.02191. 宇宙を持つがW型を持たないMartin-Löf型理論は、一価性の有無にかかわらず、ATR₀の強さ(順序数Γ₀)を持ちます。W型があれば、はるかに強い集合論に達します。
- Eastaugh B (2024). Reverse mathematics. Stanford Encyclopedia of Philosophy, Metaphysics Research Lab, Stanford University. https://plato.stanford.edu/entries/reverse-mathematics/. 大五元、その特徴的な定理、証明論的順序数(ACA₀はε₀、ATR₀はΓ₀)の概説です。
- Kumar A, Zhuang V, Agarwal R, Su Y, Co-Reyes JD, Singh A, Baumli K, Iqbal S, Bishop C, Roelofs R, Zhang LM, McKinney K, Shrivastava D, Paduraru C, Tucker G, Precup D, Behbahani F, Faust A (2024). Training language models to self-correct via reinforcement learning. ICLR 2025. arXiv:2409.12917. テスト時に外部からのフィードバックなしで、2回の試行をかけて自分の答えを改善するようモデルを訓練します。
- Hong S, Zhuge M, Chen J, Zheng X, Cheng Y, Zhang C, Wang J, Wang Z, Yau SKS, Lin Z, Zhou L, Ran C, Xiao L, Wu C, Schmidhuber J (2023). MetaGPT: meta programming for a multi-agent collaborative framework. ICLR 2024. arXiv:2308.00352. 人間のソフトウェアチームの標準作業手順と役割を、エージェントのチームのためのプロンプトの列に組み込みます。
- Vijayaraghavan G, Jayachandran P, Murthy A, Govindan S, Subramanian V (2026). If you want coherence, orchestrate a team of rivals: multi-agent models of organizational intelligence. Preprint. arXiv:2601.14351. 役割の境界を厳密に定めたプランナー、実行者、批評者という企業の組織構造を再利用した、本番稼働のシステムを記述しています。
- Haynes AB, Weiser TG, Berry WR, Lipsitz SR, Breizat AH, Dellinger EP, Herbosa T, Joseph S, Kibatala PL, Lapitan MC, Merry AF, Moorthy K, Reznick RK, Taylor B, Gawande AA; Safe Surgery Saves Lives Study Group (2009). A surgical safety checklist to reduce morbidity and mortality in a global population. New England Journal of Medicine 360(5): 491–499. doi:10.1056/NEJMsa0810119. 8つの病院で、チェックリストのプログラムの前に3,733人、後に3,955人の患者を対象とし、死亡は1.5%から0.8%に、合併症は11.0%から7.0%に下がりました。このプログラムには研修とチームブリーフィングが含まれていました。著者たちはその機序を多因子的と呼び、前後比較のデザインを限界として挙げています。
- Urbach DR, Govindarajan A, Saskin R, Wilton AS, Baxter NN (2014). Introduction of surgical safety checklists in Ontario, Canada. New England Journal of Medicine 370(11): 1029–1038. doi:10.1056/NEJMsa1308261. 101の病院で、調整後の死亡率は採用前が0.71%、採用後が0.65%(P = 0.13)、合併症は3.86%と3.82%(P = 0.29)でした。州はチェックリストの使用状況の公表を義務づけましたが、正式なチーム研修は義務づけられていませんでした。
- Southern MG (2026). OpenAI founding member: make LLMs write like an aircraft manual. Search Engine Journal, 2 October 2026. https://www.searchenginejournal.com/karpathy-llm-aircraft-manual-writing/591813/. 人がモデルの出力をより読みやすくなるように、モデルにASD-STE100に従って、あるいはその規則に80%まで沿う形で説明させることを勧めるAndrej Karpathyの投稿を報じています。
- Ghinda L (2026). Explain to me in Simple Technical English. All About Coding, 14 August 2026. https://allaboutcoding.ghinda.com/explain-to-me-in-simple-technical-english. ある開発者が4つのコード片で行った検証で、作者自身が厳密ではないと述べています。文体の指示なしで保持された47個の事実に対して、Claudeはゆるい指示では4個、完全なASD-STE100では22個を失いました。
- Yu C, Yin L, Fan Q, Yu Y, Zhong RR, Li M (2026). Compile, then page: executable SOP programs and a capability-gated runtime for procedural LLM agents. Preprint. arXiv:2607.11346. 選別された125件のSOPBenchの銀行ケースの集合と6つのモデルで、手順の機械可読な制約からコンパイルされ、検証ステップが加えられた擬似コードは、公式の文章版と比べて成功率を0から16.0ポイント引き上げました。現在のステップだけを見せることは、もっとも強いモデル群には助けになり、もっとも弱い2つのモデルには害になりました。
- Xu X, Guo H, Shen G, Cheng S, Zhang X (2026). Natural-language workflows are not software yet: artifact-driven compilation for reliable agent execution. Preprint. arXiv:2608.21341. 各ステップが読み書きする成果物を宣言するようにワークフローをコンパイルすると、3つの実行モデルで、タスク解決率の平均が62%、46%、60%から85%、82%、85%に上がりました(488件のインスタンス、11のワークフロー)。より明確なテキストへの書き直しでは66%、46%、76%でした。このコンパイラはチェック、明示的な制御フロー、最適化、検証も加えるので、この改善はそのパッケージ全体によるものです。
- Yuan S, Song K, Chen J, Tan X, Shen Y, Ren K, Li D, Yang D (2024). EasyTool: enhancing LLM-based agents with concise tool instruction. NAACL 2025. arXiv:2401.06201. ツールのドキュメントを、パラメータの手引きと例を備えた簡潔な指示に書き直すことで、ToolBenchでその長さは2,530トークンから748トークンになり、GPT-4が判定し2つのテストセットで平均したChatGPTの回答成功スコアは15.0%から52.8%に上がりました。
私たちの記録:
- Biomedical Literature Evidence 1.0.0-public.1 検証記録:19個のunittestメソッドが合格。RISとCSL-JSONのレコード3件中3件を未確認として保持。合成の「完了したが証拠不十分」の台帳チェック(
completed: true, support_ready: false)。 - Mendelian randomization 1.0.0-public.2 再現レポート:Walker et al. 2019 v2、ケース2(アーカイブされた163行のうち157行を保持、主要な結果セル19個中19個が一致)。監査済みの大五元のベンチマークで、有限値・振り分け・SE・オッズ比・Benjamini–Hochberg法の仮説族のチェック54件中54件を確認(社内ベンチマークの記録、公開記録はまだありません)。
- Meta-analysis 1.0.0 性能レポート:オープンアクセスのコクランレビュー28件、統合解析1,061件のうち1,060件、チェック可能な定量的項目11,351件のうち10,797件を再現(95%)。
ma_validate.pyはNaN/±Infを拒否するよう修正され、標準ライブラリを用いた32個の単体テストに加え、検証可能なsigned_zの35,130行(5,106行は欠測値により除外)と保存されたホルム法の件数で確認(社内ベンチマークの記録、公開記録はまだありません)。 - Scientific Figure Master 1.1.2 スキルページ:20件の実際のキャプションにわたって、採点対象のキャプション項目61個中61個が正解。汎用のOOXML
word/charts/chart1.xmlとchart2.xmlの検証器が、Fig. S2(OA-10 = 0.9108 < 1.6225)とFig. S3(NON-OA2とOA-1対OA-1とOA-8)の両方で、キャプションとグラフのあいだの外れ値の矛盾を捉えました(社内ベンチマークの記録、公開記録はまだありません)。 - Grant Writing Master 7.0.0-public.1 検証記録と事実保持の記録:有意でなかったパイロット試験の結果と非因果的な言い回しを、改訂や言語をまたいで保持。SHA-256を用いたパッケージの来歴確認と、文字数・バイト数の計測を確認(社内ベンチマークの記録、公開記録はまだありません)。
- Scientific Writing 1.1.0 リリースノート:原稿の改訂の完全な比較と、別建ての編集上の判断の記録。
audit_numbers.pyは、標準ライブラリによる.xlsxXMLの値と数式の分離と、明示的な563 = 209 + 354のDEGの本文からCSVへの結びつけで強化(社内ベンチマークの記録、公開記録はまだありません)。 - Academic Peer Review 1.0.2 スキルページ、ベンチマーク、PeerJ 20995の盲検査読:60件の公開査読からの1,035件のコメントに照らして較正。
screen.pyは、標準ライブラリによる.docxの抽出、途切れなく単調に続く余白番号の除去、Methodsで層別化した動物の性別のスクリーニングで強化(社内ベンチマークの記録、公開記録はまだありません)。 - Big5cのSOPBenchパイロット試験(社内記録。研究の全体はarXivで公開されます):7つのSOPBenchドメインにある20の手順にわたる185件のケースで、GPT-5.6 LunaとGemini 3.8 Flash lowを使い、汎用リフレクション、フラット検証、Big5cを、正しく処理されたケース数と1ケースあたりのトークン数で比較(Geminiではトークンの記録がそろっているケースは184件)。
- Big5cのスキル修復パイロット試験(社内記録。研究の全体はarXivで公開されます):Pythonを使う6つの人工的に構成した研究ワークフローを、それぞれ正しく動くヘルパースクリプトと欠陥のあるヘルパースクリプトで実行し(1つのモデルにつき12個のタスク)、GPTとGeminiで検証。Big5cと汎用リフレクションはどちらも12個中12個のタスクを完了し、6つ中6つの欠陥のあるヘルパーを修復しました。12個のタスク全体で、Big5cが使ったトークンはGPTで34.0%少なく、Geminiで22.7%少なくなりました。この節約は、正しく動くヘルパーを使った6回の実行から生まれました。そこでは、合格したチェックによって批評が省略されます。