学术搜索引擎返回的是一份论文清单,阅读则留给科学家去做。在第五篇文章中,我们描述了一种不同的对象:一个被编译成动态数据库的研究领域。每篇论文都经过审计,成为一个证据胶囊(Evidence Capsule),其中保留着它的论断所依赖的条件;大五元梯子的同样五个动作,则在更高一个层级上,对同一课题的全部胶囊再次执行。本文要讲的,是科学家可以向它问些什么。
我们的目标是一个面向AI时代的学术搜索引擎。科学家提出一个问题。系统用一份具有论文形式的东西来回答:问题本身、它所用到的胶囊和开放数据集、它运行的分析、结果,以及限制这一结果的因素。这个答案会被记录下来。其他科学家阅读它、质疑它、为它排序,而下一个问题就从一份更丰富的记录出发。我们预期这样的系统能让没有任何一篇论文单独说出的想法浮现出来,并且是以人能够跟得上的形式做到这一点。
要做到这一步,需要三条设计规则,每一条都把第四篇文章中那架梯子上的一个动作,用到系统自己的输出上。一个答案必须把一族已声明的、站得住脚的分析作为一个对象来报告。答案必须与证据放在不同的架子上。顶端的梯级则必须按它本来的用途来使用,也就是作为一种排除解释的方法,这样它交给科学家的,就是记录中至今没有任何解释能说明的那一部分,连同能够解决这个问题的那项实验。下文描述的都是我们正在构建的设计。
没有人放在一起读过的知识
1986年,芝加哥大学的信息科学家Don Swanson注意到,有两批医学文献从未相遇。二十五篇文章提供的证据表明,膳食鱼油能降低血液黏度、抑制血小板聚集,并使红细胞更易变形。三十四篇关于雷诺综合征的文章提供的证据则表明,至少在一部分患者身上,正是这几项血液因素出现了异常。这两组文献没有一篇共同的文章,也没有一位共同的作者,彼此也不互相引用[1]。于是,“鱼油也许对雷诺综合征患者有帮助”这个想法,就分成两半摆在公开发表的文献里,却没有一位读者同时握有这两半。
在Swanson发表这一论证两年之后,一项纳入32名患者的随机安慰剂对照试验报告,鱼油推迟了诱发性发作的出现[1]。完整报告的摘要给出了在原发性雷诺综合征中的获益:服用鱼油的11名患者中有5名已无法再被诱发出发作,而服用橄榄油的9名患者中有1名;摘要还报告,在继发性雷诺综合征中没有获益[2]。Swanson自己总结出了一般性的教训:科学以专业化来应对自身的增长,并且往往忽视各种联系[1]。
如今,软件能够跨越大得多的鸿沟,考察彼此分隔的文献。Tshitoyan及其同事用大约330万篇(3.3 million)材料科学论文的摘要训练了词向量,并按照各种材料与“thermoelectric”(热电)一词的相似度为它们排序。当他们只用2009年之前发表的摘要重建模型时,模型排在前五位的候选材料中,有三种后来被报告为热电材料,或者被提出可能是热电材料[3]。这样的排序能够引导注意力,却要由科学家自己去重建理由:为什么一种候选材料值得在实验台上花几个月。Swanson自己的方法则具有相反的特点。他说这种方法既不是配方,也不是算法,因为它的每一步都依赖于检索者本人的知识[1]。我们所描述的引擎,旨在保留他那样的推理依据,同时以软件能够处理的规模开展工作。
规则一:答案是一整族分析,放在一起展示
这个引擎有一个诱人的版本:把它手头所有的统计学、生物信息学和数据科学方法都用到一个问题上,然后把凡是显著的结果都写出来。这样的版本会是一台制造错误发现的机器。Ioannidis用一个简单的模型说明了原因。在达到统计学显著性的发现中,为真者所占的比例会在三种情况下降低:被检验的假设中本来为真的越少,设计和分析中的偏倚越大,检验同一个问题的团队越多;他还论证说,灵活的设计和分析会加大这种偏倚[4]。在组学数据中,选择会迅速成倍增加:归一化方法、协变量、批次校正,还有检验本身。在没有真实效应、阈值为5%的模拟中,从十个互不相关的结局中报告最好的一个,得到约40%的假阳性;在十二条剔除离群值的规则中挑选,得到将近30%[5]。这些模拟所刻画的,是一个动手尝试几种变体的人。而一个引擎可以尝试几千种。
梯子的第三个梯级,即稳定化,是这样一条规则:一整族检验必须作为一个对象来处理。把它用到引擎自己的工作上,就改变了“答案”是什么。答案不是最好的那个结果。它是结果在一族已声明的、站得住脚的分析上的分布,按每一项分析所估计的量分组并放在一起展示,在有正当理由的地方再加上一个联合检验。这一族分析的范围随答案一同记录。统计学家已经为此起好了名字。在多元宇宙分析(multiverse analysis)中,每一种站得住脚的数据处理方式都要运行一遍,并报告全部结果。在它的第一次演示中,一项p = 0.012的已发表结果变成了120项分析,其中7项显著[6]。规范曲线(specification curve)把所有合理设定下的估计值画出来,并把它们与在打乱重排的数据上运行同样分析的结果相对照,进行联合检验。在它的一个例子中,1,728种设定里有37种显著,但联合检验给出p = 0.85。在另一个例子中,90种里有85种显著,联合p低于0.002[7]。
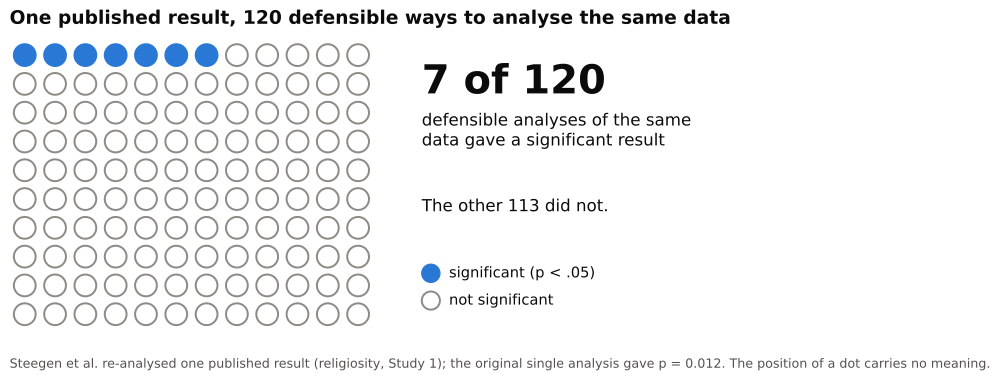
实心圆表示p < .05时显著,空心圆表示不显著。来源:参考文献[6]。
因此,引擎给出的一个答案可能是这样的:在规则允许的分析路径中,大多数给出方向相同的效应,而每一条没有给出这种效应的路径,都是没有对细胞组成进行调整的路径。科学家从这句话里学到的,比从一个p值里学到的更多,而这是一种论文很少有篇幅容纳的结果。
规则二:答案与证据放在不同的架子上
第二个诱惑,是把每个答案都当作又一篇论文归档回数据库,让文献集合通过不断吸收自身的产出来扩充。麻烦在于,这样一来证据就会开始引用它自己。在第五篇文章中,我们见过这件事的人类版本:围绕一个论断,在指向检验过它的那些论文的214次引用中,94%指向了支持它的那四篇论文,一个假说就这样仅仅通过引用变成了事实[8]。一个把自己的答案算作证据的系统,会以机器的速度做同样的事。
机器学习中有一个相关的结果。当一个语言模型一代接一代地在上一代生成的文本上微调时,它最先丢掉的是原始数据尾部的罕见情形。而在每一轮中保留十分之一的原始数据,就只留下轻微的退化[9]。这一发现讲的是模型的训练,而不是数据库,我们把它当作一个类比意义上的警示。罕见而别扭的观察结果,往往正是一项发现的起点,而一份靠自己的总结为食的记录,会把这样的观察结果抹平。这个结果是保存原始观察结果的一个理由。我们的数据库则另加了一条关于来源的规则:派生答案始终可以与它所用的证据区分开来。
第四个梯级,即分层,让不同层级的证据保持分开,在这里它给了数据库两层架子。第一层放的是观察结果:经过审计的论文和数据的胶囊。第二层放的是派生成果:引擎的答案,每一个都绑定到它所用的那些胶囊的版本上。派生答案可以被阅读、引用、质疑、排序,也可以与其他答案重新组合。它可以通过自己记录在案的依赖关系为另一项分析提供信息,但永远不算作额外的独立证据。一个答案要移到第一层架子上,只有一条路:有人去检验它,而那项实验或新研究的结果作为一个胶囊进入数据库,像其他任何胶囊一样接受审计。所以,这个系统确实随着每一次使用而增长,但它的证据只有在向世界求证时才会增长。
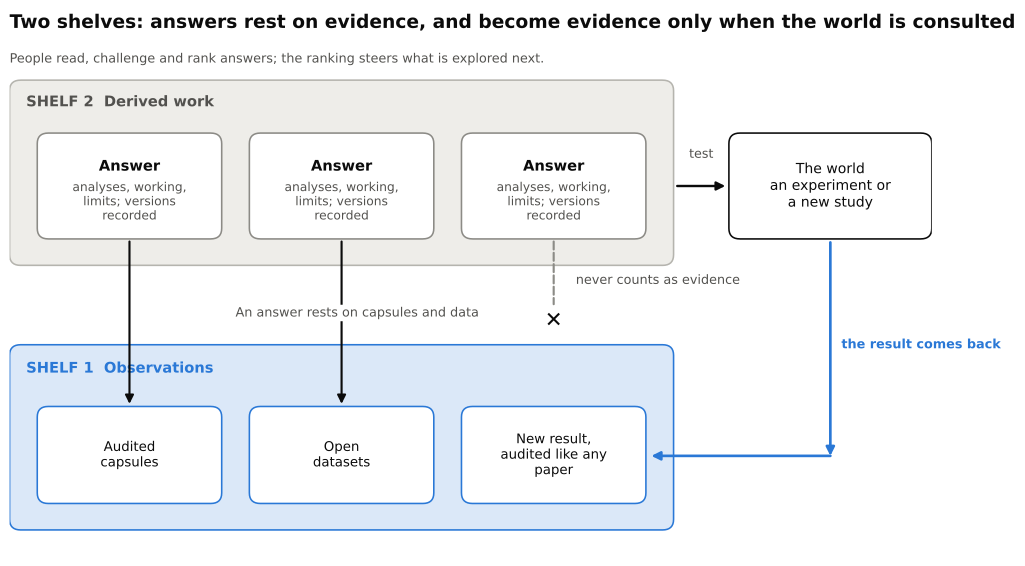
答案放在上层架子上,并引用下层架子。答案只有通过检验才成为证据,检验的结果作为经过审计的胶囊回到下层架子。
规则三:第五个梯级做的是排除,剩下来的就是发现
在第四篇文章中,我们把梯子的顶端梯级解读为一个我们称作自我反思的动作。在数学中,这个系统允许非直谓概括:它用一个条件来构成一个集合,而这个条件的量词遍历某一类的全部集合,其中也包括这个新集合本身。和在那篇文章里一样,我们的解读是一个类比。在科学中,一个因果论断必须在同一观察结果的各种相互竞争的解释面前站得住,所以检验它就意味着审视由竞争者构成的整个空间,而不是只沿着一条路径走。
这个梯级并不发明解释。它去掉的是与记录相矛盾的那些解释。对于每一个候选解释,一个编译而成的课题都保存着支持它的胶囊、与它相矛盾的胶囊,以及每个胶囊是在什么条件下支持它或与它相矛盾的:物种、性别、暴露时间窗、检测方法、多重性,以及研究设计及其典型偏倚。审视这个空间,是在一张图上进行的计算,而这张图是任何单独一篇论文都不包含的。
设想有一个效应,它在规则一的各项分析中都成立,在相互独立的队列中也成立。引擎拿它与文献提供的每一种解释逐一核对:一条已知的通路,一种批次伪影,一个有些研究调整过而另一些研究没有调整的混杂因素,一个经由第二条途径起作用的遗传变异。每一个不成立的解释,都标上与它相矛盾的胶囊。可能出现三种结局。可能只有一个解释存活下来,这时引擎就组装出了一个没有任何论文说出过的假说。可能有几个解释存活下来,这时引擎就展示它们的预测在哪里不同。也可能一个都没有存活下来。这种情况首先会让引擎回头去检查效应本身、数据提取,以及各项研究共有的假设,因为矛盾更多时候是一个错误,而不是一项发现。如果效应依然成立,引擎就定位到了一件有价值的东西:一个稳健的、记录中没有任何东西能解释的效应。在剩下的解释预测出不同结果的地方,引擎提出能够把它们区分开的实验;在它们的预测并无不同的地方,引擎指出缺少的是哪一项测量。这份解释清单是文献所提供的那一份,没有人能知道它是否完整,所以引擎交出来的是一项提议。这就是把第五篇文章中的三角互证当作一次搜索来运行。
这种方法有名字,也有历史。1964年,John Platt把它称为强推理(strong inference):设计出若干备选假说,设计出一项判决性实验,使它的各种可能结果尽可能地排除其中的一个或多个假说,把实验做到能得出干净的结果,然后对剩下的假说重复这一程序。他把这种方法追溯到Francis Bacon和T. C. Chamberlin的多重假说法,并且凭借例证和论证,把分子生物学和高能物理学的进展速度归功于它[10]。他检验任何一项工作的办法是一个问题:你的实验否证了哪一个假说?引擎则把这个问题一次提给一整个领域的文献。
这在一种有限的意义上是新的,而我们认为,这种有限的意义正是有用的那一种。这项发现是一个边界精确的空白,而通向它的每一步,都是一项人可以打开来看的检查。这里也是引擎把工作交出去的地方。因果层级定理说明了原因:除了例外情形,已经观察到的东西本身并不能确定一项干预会产生什么结果,而要从观察结果计算出一个效应,就需要额外的因果假设[11]。引擎随每个答案一并陈述这些假设,并标出在哪里一项实验能够解决这些假设留下的悬而未决之处。
人的判断引导搜索
引擎会越用越好,因为使用中带着判断。科学家提出哪些问题,打开哪些答案,质疑哪些答案,又把哪些答案排在前面,这些都是信号,显示这个领域的注意力在哪里,又不在哪里。这样的信号有助于引导注意力。在一项针对1,790万篇(17.9 million)论文的研究中,参考文献列表以常规组合为主、同时带有一小部分不寻常组合的论文,成为高被引论文的可能性接近两倍,而高被引是影响力的一种度量[12]。Sourati和Evans把这一点构建成了一个发现模型。他们在文献的文本之外,加入了一份“谁写过什么”的记录,于是该模型预测后来发现的精确率,在能源材料上约为纯文本方法的两倍,在药物重定位上则高出43%。它还可以被调节,去看科学家们没有在看的地方,而它在那里提出的候选对象是在理论上评估的,没有做实验[13]。人的评分能够引导一个生成器,这方面的直接证据是新近才有的。当110位课题组负责人为一个系统给他们每人生成的想法评分时,在这4,451条评分中,有36.7%是他们在兴趣一项上打出的最低分。按照到当时为止收集到的评分为新想法排序,使前五位中有趣想法所占的比例大致翻了一番,达到49%[14]。在另一项关于语言研究的研究中,盲法评审者认为模型的研究想法比人类研究者的更新颖,尽管该模型产生的互不相同的想法很少:4,000个中大约有200个不重复[15]。兴趣、影响力和新颖性并不等于正确性,而评分记录正是为此而设的。
所以引擎有两种模式,由科学家在二者之间选择。一种跟随领域,把常规的东西与少许不寻常的东西组合起来。另一种则寻找目前没有人具备条件去尝试的组合。在这两种模式中,都是人的排序决定接下来探索什么,而第二层架子就是记录这种探索的地方。
展示推导过程
第一节中的那个排序到来时没有附带推导,这正是它的弱点。引擎则以完整的推导过程来呈现答案:它所依托的胶囊、每个胶囊贡献的条件,以及每一步是在哪个梯级上迈出的。科学家在Nexitia画布上打开这些内容,而检查由他们自己来做。一项推导过程无法让人跟上的提议,根本不会作为提议到达科学家手中。
已发表的工作说明了这一步为什么重要,因为在每一个案例中,都得先有人理解了,结果才算数。在纽结理论和表示论中,一个机器学习模型把数学家引向了一种规律,数学家在这两个领域各证明了一条定理;表示论中还有一个进一步的猜想至今未决[16]。一位批评者认为,传统统计方法很可能也会找到纽结方面的那个结果,但找不到另一个[17]。这一批评本身就是有益的一课:价值在于引导注意力,而证明仍然留在人的手里。Schut及其同事从国际象棋程序AlphaZero中提取出概念,并通过例题把它们教给四位特级大师。在出自同样概念、此前未见过的题目上,四人解出的题都比之前多:一人在十二道题中多解出五道,另一人只多解出一道。作者称之为概念验证[18]。在生物学中,Google的Co-Scientist提出了可以重定位用于对抗急性髓系白血病的药物。在作者自己的细胞培养实验中,专家选出的五个候选药物里有三个降低了白血病细胞系的活力,而系统独自选出的三个里有一个明显有活性。作者称这一验证是初步的[19]。
我们已经把人的这一步构建在设计之中,而不是把它交给运气。一位科学家如果能够打开一项提议,对其中某个胶囊的解读提出异议,并看到提议随之改变,那么他所做的就是审稿人所做的那种检查,而且推导过程就摆在眼前。
记分
一项提议凭借让一个事关重大的问题变得可检验而赢得一席之地,而它的价值在检验结果回来时显现。由于数据库带有版本和时间戳,每一项提议都可以在其结局出现之前记入日志,同时记下它所依托的胶囊版本、模型和检索设置。记入日志的每一个概率,都指明一个结局、一个研究总体和一个时间范围。此后,结局会作为普通记录进入同一个数据库:一项带有结果的新研究、一次重复研究、一次更正、一次撤稿。随着时间推移,这份日志就成了一份评分记录。它显示校准情况,也就是说,在被赋予百分之七十概率的提议中,大约有百分之七十成真。它还把这些预测与仅凭基础率所能得到的评分相比较。对于这样的记录,预测者们有一个精确的标准。如果预测者平均而言通过报告自己真实相信的东西就能得到最好的成绩,那么这条评分规则就是适当的(proper),而Brier评分和对数评分在这个意义上是严格适当的。同一项工作还提出了我们所采纳的目标,即在预测已校准的前提下,使预测尽可能锐利[20]。一份永远只重复基础率的记录是校准的,却告诉不了科学家多少东西。
科学中的预测是可以度量的,而已发表的尝试既表明它行得通,也表明它目前还多么有限。在一项研究中,由研究者组成的预测市场正确判断了41项心理学重复研究中的29项,而“一律预测失败”的规则会判对25项[21]。在后来的一组21项社会科学实验中,市场的信念对这些发现的排序与重复研究的结果大体一致,秩相关为0.84[22]。一个只读取了96篇心理学论文文本的模型,把其中68%正确分类,而一律预测失败则为61%[23]。而在已经进入临床试验的药物项目中,靶点对该疾病具有人类遗传学证据支持的项目,从Ⅰ期走到上市的可能性是没有这种支持的项目的2.6倍[24],此前较早的一项估计则约为两倍[25]。这些研究把结局与证据的特征联系了起来。胶囊数据库在构造上就记录这样的特征,并在结局到来时把结局也记录下来。Swanson早已区分了评分必须分开的两种情形:在发现存在之前作出的预测,以及针对一份已经刊出的报告所作的回溯预测(retrodiction)[1]。
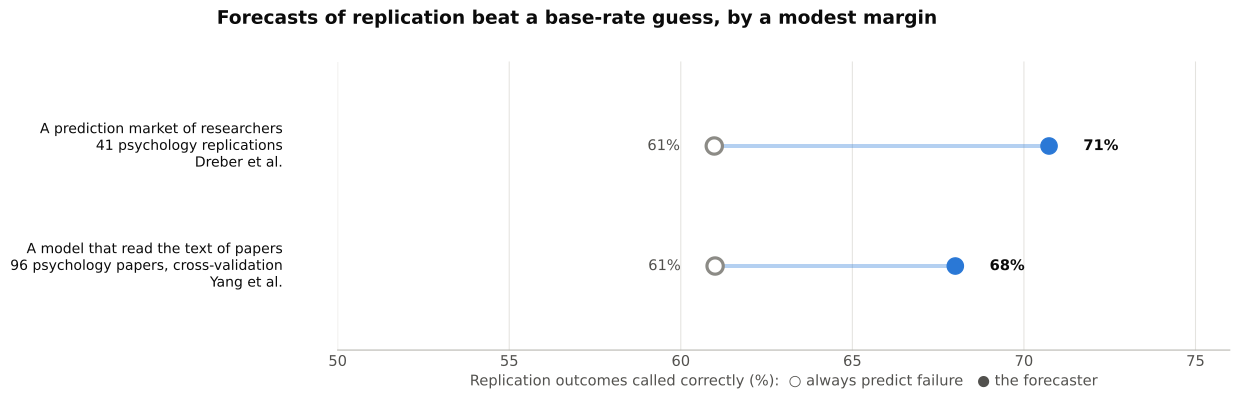
实心点是预测者,空心点是总是预测失败的规则。两项研究使用不同的论文,所以两行之间不作比较。来源:参考文献[21]和[23]。
一份随着每项新研究而更新的记录,还必须控制自己喊出“发现”的频率。有一种已发表的方法针对随机试验做到了这一点。在其假设之下,它控制的是这样一个概率:在不存在效应时,不断累积的证据(以e值表示)在任何时刻越过发现阈值,而无论分析更新得多么频繁[26]。一个同时追踪许多问题的引擎,在此之上还需要一条多重性规则,这又回到了第三个梯级。
有三件事可能出错,而设计对每一件都作了回应。标签可能有偏倚,因为只有一部分论断会被检验、重复或撤稿。因此,评分只使用在结局出现之前作出的提议,并且描述的是在被检验过的提议当中的表现。它报告有多少提议被检验过,以及它们是怎样被选中的,使读者能看到这种选择。后来的知识可能泄漏进一项预测,撤稿状态就是如此。每一项预测都记录它的证据截止时间,而回顾性的评估要单独检查其中是否有后来才到达的信息。此外,作者一旦知道哪些检查能提高评分,就可能迎合这些检查来写作。在有原始文件的地方,胶囊检查使用这些文件并重新计算统计量;从文本中提取的论断始终保留与其来源的链接,而缺失的输入则一直标记为缺失。评分附着于论断,而绝不附着于个人。
留给科学家的是什么
提议所涉及的是已发表的论断,而只有实验才触及世界。正如我们在第五篇文章中指出的,丰裕时代的瓶颈在于消化,因为结果到来的速度,快于人们验证、解释和吸收它们的速度。一份用一整族分析来回答、展示其推导过程并且记分的编译文献,直接服务于这个瓶颈,但并不消除它。科学家仍然要选择哪个问题重要,判断一项提议是否合乎情理,并把一个经过验证的结果变成别人可以检验的解释。
我们预期,评分记录会改变科学家使用这样一个数据库的方式,正如一台经过校准的仪器会改变他们对待一项测量的方式。一份报告自身正确频率的文献,是科学家可以像使用仪器那样使用的文献:不是因为它总是正确,而是因为它说明了自己正确的频率。
参考文献
- Swanson DR (1990). Medical literature as a potential source of new knowledge. Bulletin of the Medical Library Association 78(1): 29–37. https://pmc.ncbi.nlm.nih.gov/articles/PMC225324/. 综述了三对在逻辑上相关联却互不引用的文献。对于鱼油与雷诺综合征,25篇和34篇文章之间没有共同的文章或作者,两年后报告的一项32名患者的随机试验支持了这一推断;作者说这种方法既不是配方,也不是算法。
- DiGiacomo RA, Kremer JM, Shah DM (1989). Fish-oil dietary supplementation in patients with Raynaud's phenomenon: a double-blind, controlled, prospective study. The American Journal of Medicine 86(2): 158–164. doi:10.1016/0002-9343(89)90261-1. 三十二名患者接受了鱼油或橄榄油。在原发性雷诺综合征中,服用鱼油的11人中有5人、服用橄榄油的9人中有1人已无法再被寒冷诱发出发作;在继发性雷诺综合征中未发现获益。
- Tshitoyan V, Dagdelen J, Weston L, Dunn A, Rong Z, Kononova O, Persson KA, Ceder G, Jain A (2019). Unsupervised word embeddings capture latent knowledge from materials science literature. Nature 571(7763): 95–98. doi:10.1038/s41586-019-1335-8. 用大约330万篇(3.3 million)摘要训练的词向量为候选热电材料排序。用2009年之前的摘要重建后,前五位中有三种后来被报告为热电材料或被提出可能是热电材料,另有两种从未被研究过;在83种材料上,该排序与实测性能的秩相关为0.59和0.52。
- Ioannidis JPA (2005). Why most published research findings are false. PLoS Medicine 2(8): e124. doi:10.1371/journal.pmed.0020124. 一个模型,其中一项具有统计学显著性的发现为真的概率,取决于先验比值、统计效能、一个偏倚项和团队数目;作者论证说,设计和分析上的灵活性会加大偏倚。其示例中的数字是假设,不是测量值。
- Stefan AM, Schönbrodt FD (2023). Big little lies: a compendium and simulation of p-hacking strategies. Royal Society Open Science 10(2): 220346. doi:10.1098/rsos.220346. 在5%水平上、没有真实效应的模拟:报告10个互不相关的结局中最好的一个时,假阳性约为40%;采用12条离群值规则时将近30%;较温和的策略则约为7.5%至10%。
- Steegen S, Tuerlinckx F, Gelman A, Vanpaemel W (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science 11(5): 702–712. doi:10.1177/1745691616658637. 运行数据处理选择的每一种合理组合。对于一项已发表的研究,120项分析给出7个显著结果,而原文报告的是p = 0.012;作者称他们的这组选择只是一个子集。
- Simonsohn U, Simmons JP, Nelson LD (2020). Specification curve analysis. Nature Human Behaviour 4(11): 1208–1214. doi:10.1038/s41562-020-0912-z. 把所有合理设定下的估计值放在一起展示,并对照打乱重排的数据进行联合检验:一个例子中1,728种里有37种显著(联合p = 0.85),另一个例子中90种里有85种显著(p < 0.002)。
- Greenberg SA (2009). How citation distortions create unfounded authority: analysis of a citation network. BMJ 339: b2680. doi:10.1136/bmj.b2680. 在围绕一个论断、由242篇论文和675次引用构成的网络中,指向十篇原始数据论文的214次引用里,94%指向了其中支持该论断的四篇;该研究对引用作了分类,并没有检验该论断是否为真。
- Shumailov I, Shumaylov Z, Zhao Y, Papernot N, Anderson R, Gal Y (2024). AI models collapse when trained on recursively generated data. Nature 631(8022): 755–759. doi:10.1038/s41586-024-07566-y. 一个语言模型一代接一代地在上一代的输出上微调,会最先丢掉原始分布的尾部;在每一步保留10%的原始数据,则只留下轻微的退化。该结果针对的是训练,而不是生成文本的存储。
- Platt JR (1964). Strong inference. Science 146(3642): 347–353. doi:10.1126/science.146.3642.347. 一篇演讲,论证各个领域在这样做时进展最快:设计出备选假说和能够排除其中一部分的判决性实验,然后对剩下的假说加以细化;它把这种方法归功于Bacon和Chamberlin,并以分子生物学和高能物理学中的例子立论,没有实测证据。
- Bareinboim E, Correa JD, Ibeling D, Icard T (2022). On Pearl's hierarchy and the foundations of causal inference. In Probabilistic and Causal Inference: The Works of Judea Pearl, ACM Books, pp. 507–556. doi:10.1145/3501714.3501743. 证明了因果层级的三层(观察、干预、设想反事实)几乎从不相互坍缩,因此观察性数据需要一张假定的因果图,才能计算出干预效应;作者补充说,这并不是一个一般性的不可能性结果。
- Uzzi B, Mukherjee S, Stringer M, Jones B (2013). Atypical combinations and scientific impact. Science 342(6157): 468–472. doi:10.1126/science.1240474. 在1,790万篇(17.9 million)论文中,把高度的常规性与尾部的新颖被引期刊配对结合起来的论文,每100篇中有9.11篇高被引,而背景水平为每100篇5篇,所涉论文发表于1990年至2000年;这是与引用之间的一种关联。
- Sourati J, Evans JA (2023). Accelerating science with human-aware artificial intelligence. Nature Human Behaviour 7(10): 1682–1696. doi:10.1038/s41562-023-01648-z. 在文本之外加入“谁写过什么”,使预测发现的精确率高于纯文本基线,在能源材料上提高约100%,在药物重定位上提高43%。为避开科学家扎堆之处而选出的候选对象,仅以基于理论的评分来评判。
- Gu X, Krenn M (2026). Generating interesting scientific ideas using knowledge graphs and LLMs: evaluations with 100 research group leaders. Proceedings of the National Academy of Sciences 123(46): e2611349123. doi:10.1073/pnas.2611349123. 110位课题组负责人对为其个人定制的想法给出了4,451条评分,其中36.7%是兴趣一项的最低分,24.9%是5分制中的4分或5分;按已收集的评分排序,前五位的精确率为49%,而基础率约为25%。这些评分衡量的是个人兴趣,而不是正确性。
- Si C, Yang D, Hashimoto T (2024). Can LLMs generate novel research ideas? A large-scale human study with 100+ NLP researchers. ICLR 2025. arXiv:2409.04109. 盲法评审者在新颖性上给模型生成的想法打的分高于人类研究者的想法(5.64对4.84),仅限于语言研究中有关提示(prompting)的课题;每个课题生成的4,000个想法中约有200个不重复。
- Davies A, Veličković P, Buesing L, Blackwell S, Zheng D, Tomašev N, Tanburn R, Battaglia P, Blundell C, Juhász A, Lackenby M, Williamson G, Hassabis D, Kohli P (2021). Advancing mathematics by guiding human intuition with AI. Nature 600(7887): 70–74. doi:10.1038/s41586-021-04086-x. 一个模型的归因把数学家引向了纽结理论中的一种关系和表示论中的一种关系;他们在两个领域各证明了一条定理,表示论中还有一个进一步的猜想至今未决。
- Davis E (2021). Deep learning and mathematical intuition: a review of (Davies et al. 2021). Preprint. arXiv:2112.04324. 认为对于纽结方面的结果,传统统计方法很可能就已足够,而表示论方面的结果确实需要那个深度学习模型。
- Schut L, Tomašev N, McGrath T, Hassabis D, Paquet U, Kim B (2025). Bridging the human–AI knowledge gap through concept discovery and transfer in AlphaZero. Proceedings of the National Academy of Sciences 122(13): e2406675122. doi:10.1073/pnas.2406675122. 四位特级大师学习了由提取自AlphaZero的概念构建的题目;此后四人在出自同样概念、此前未见过的题目上都解出了更多,增幅从十二道题中的一道到五道不等。作者称这项研究是概念验证,并指出启动效应(priming)是一个可能的混杂因素。
- Gottweis J, Weng W-H, Daryin A, Tu T, et al. (2026). Accelerating scientific discovery with Co-Scientist. Nature 655(8122): 487–496. doi:10.1038/s41586-026-10644-y. 针对急性髓系白血病,专家选出的五个重定位候选药物中有三个降低了细胞系的活力,一次自主运行给出的三个候选药物中有一个明显有活性;作者称这一验证是初步的。
- Gneiting T, Raftery AE (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association 102(477): 359–378. doi:10.1198/016214506000001437. 把评分规则定义为:当报告自己的真实信念使期望得分最大时是适当的,当只有这一报告使其最大时是严格适当的;Brier评分和对数评分是严格适当的,而文中提出的预测目标是在校准的前提下追求锐度。
- Dreber A, Pfeiffer T, Almenberg J, Isaksson S, Wilson B, Chen Y, Nosek BA, Johannesson M (2015). Using prediction markets to estimate the reproducibility of scientific research. Proceedings of the National Academy of Sciences 112(50): 15343–15347. doi:10.1073/pnas.1516179112. 在41项已完成的心理学研究重复中,25项失败。由研究者组成的市场正确判断了41项中的29项;在交易之前对同一批研究者所作的调查判对了40项中的23项。
- Camerer CF, Dreber A, Holzmeister F, Ho T-H, Huber J, Johannesson M, Kirchler M, Nave G, Nosek BA, Pfeiffer T, et al. (2018). Evaluating the replicability of social science experiments in Nature and Science between 2010 and 2015. Nature Human Behaviour 2: 637–644. doi:10.1038/s41562-018-0399-z. 在21项实验中,13项重复成功。信念与重复结果之间的秩相关,预测市场为0.84,调查为0.76。
- Yang Y, Youyou W, Uzzi B (2020). Estimating the deep replicability of scientific findings using human and artificial intelligence. Proceedings of the National Academy of Sciences 117(20): 10762–10768. doi:10.1073/pnas.1909046117. 一个用96篇被重复过的心理学论文的文本训练的模型,在交叉验证中达到0.68的准确率,而一律预测失败为0.61;在来自其他重复项目的317篇论文上为0.65至0.78。
- Minikel EV, Painter JL, Dong CC, Nelson MR (2024). Refining the impact of genetic evidence on clinical success. Nature 629(8012): 624–629. doi:10.1038/s41586-024-07316-0. 在29,476个处于临床开发中的靶点–适应证配对里,具有人类遗传学证据支持的配对从Ⅰ期走到上市的可能性是没有这种支持的配对的2.6倍。这一关联是回顾性的,作者指出,它并不给出一项遗传学发现变成一种药物的概率。
- Nelson MR, Tipney H, Painter JL, et al. (2015). The support of human genetic evidence for approved drug indications. Nature Genetics 47(8): 856–860. doi:10.1038/ng.3314. 较早的那项估计:选择具有遗传学证据支持的靶点,可能使临床开发的成功率翻倍。
- ter Schure J, Grünwald P (2025). ALL-IN meta-analysis: breathing life into living systematic reviews and prospective meta-analyses. F1000Research 11: 549, version 2. 借助e值,在没有任何一项试验存在效应时,不断累积的证据在任何时刻越过阈值的概率至多为所声明的水平,无论分析更新得多么频繁;该方法是为随机试验开发的,其区间比传统分析的更宽。