学術文献の検索エンジンは論文のリストを返し、それを読むことは科学者に任されます。5番目の論考で私たちは、それとは別のものを描きました。1つの研究分野をコンパイルして、リビングデータベースにしたものです。それぞれの論文は監査されて、その主張が依存している条件を保つエビデンスカプセルになり、大五元のはしごの同じ5つの一手が、1つのトピックのすべてのカプセルにわたって、1つ上の水準で実行されます。この論考は、科学者がそのデータベースに何を問えるのかについてのものです。
私たちが目指しているのは、AI時代の学術検索エンジンです。科学者が問いを立てます。システムは、論文の形をしたもので答えます。すなわち、問い、答えが依拠したカプセルと公開データセット、実行した解析、結果、そしてその結果の限界となるものです。その答えは記録されます。ほかの科学者がそれを読み、異議を唱え、順位をつけ、次の問いはより豊かな記録から出発します。私たちは、このようなシステムが、どの1本の論文も述べていないアイデアを浮かび上がらせ、しかもそれを人がたどれる形で行うと期待しています。
そこに到達するには3つの設計上の規則が必要で、そのどれもが、4番目の論考のはしごの一手を、システム自身の出力に当てはめるものです。答えは、宣言された、正当化できる解析の族を、1つの対象として報告しなければなりません。答えは、エビデンスとは別の棚に置かれなければなりません。そして最上段は、その本来の姿、すなわち説明を消去していく方法として使われなければなりません。そうすれば、最上段が科学者に手渡すものは、記録のなかでまだ何によっても説明されていない部分と、それに決着をつける実験になります。以下はすべて、私たちが構築している設計を述べたものです。
誰も一緒に読んだことのない知識
1986年、シカゴ大学の情報科学者Don Swansonは、医学文献の2つのまとまりが一度も出会っていないことに気づきました。25本の論文が、食事から摂る魚油は血液粘度を下げ、血小板凝集を抑制し、赤血球をより変形しやすくするというエビデンスを示していました。レイノー症候群についての34本の論文は、その同じ血液の因子が、少なくとも一部の患者で異常であるというエビデンスを示していました。この2つの集合には共通する論文も著者もなく、互いに引用もしていませんでした [1]。そのため、魚油がレイノー症候群の患者に役立つかもしれないという考えは、公刊された文献のなかに2つの半分に分かれて置かれていて、その両方を手にしている読み手はいませんでした。
Swansonがこの議論を発表した2年後、32人の患者を対象としたプラセボ対照ランダム化試験が、魚油は誘発された発作の発現を遅らせたと報告しました [1]。その研究の本報告の抄録は、有益性を原発性レイノー症候群について示しています。原発性では、魚油を摂った11人のうち5人で発作を誘発できなくなったのに対し、オリーブ油を摂った9人では1人でした。続発性レイノー症候群については、有益性はなかったと報告しています [2]。Swansonは自ら一般的な教訓を引き出しました。科学は自らの成長に専門分化によって応じ、つながりを見落としがちになる、という教訓です [1]。
今日では、ソフトウェアがはるかに大きな隔たりを越えて見渡すことができます。Tshitoyanらは、材料科学の論文の抄録およそ330万件(3.3 million)で単語ベクトルを訓練し、「thermoelectric」(熱電)という語との類似度によって材料を順位づけました。2009年より前に出版された抄録だけからモデルを作り直したところ、その上位5つの候補のうち3つが、のちに熱電材料として報告または示唆されました [3]。こうした順位づけは注意を向けさせるもので、ある候補になぜ数か月の実験を費やす価値があるのか、その理由を組み立て直す作業は科学者に委ねられます。Swanson自身の方法は、それとは逆の性格を持っていました。彼はそれを、レシピでもアルゴリズムでもないと呼びました。あらゆる段階で、検索する人の知識に依存していたからです [1]。私たちが述べるエンジンは、彼の推論の根拠を保ちながら、ソフトウェアが扱える規模で機能することを意図したものです。
規則1:答えは解析の族全体であり、一緒に示される
このエンジンには、つい作りたくなる形があります。ある問いに対して、手持ちの統計学、バイオインフォマティクス、データサイエンスの手法をすべて実行し、有意になったものを何でも書き上げる、というものです。そのようなエンジンは、偽の発見を生む機械になるでしょう。Ioannidisは単純なモデルでその理由を示しました。統計的有意性に達した知見のうち真であるものの割合は、検定される仮説のうちそもそも真であるものが少ないほど、デザインと解析のバイアスが大きいほど、そして同じ問いを検定するチームが多いほど下がります。そして彼は、柔軟なデザインと解析がそのバイアスを高めると論じました [4]。オミクスデータでは、選択肢はすぐに掛け算で増えていきます。正規化、共変量、バッチ補正、そして検定そのものです。真の効果がなく閾値を5%とするシミュレーションでは、互いに無関係な10個のアウトカムのうち最良のものを報告すると偽陽性は約40%になり、外れ値を除く12通りの規則のなかから選ぶと30%近くになりました [5]。これらのシミュレーションがモデル化しているのは、いくつかの変種を手作業で試す人です。エンジンは何千通りも試すことができます。
はしごの第3段である「安定化」は、検定の族全体を1つの対象として扱わなければならないという規則です。これをエンジン自身の仕事に当てはめると、答えとは何かが変わります。答えは最良の結果ではありません。答えは、宣言された、正当化できる解析の族にわたる結果の広がりであり、それぞれの解析が推定している量ごとにまとめて一緒に示され、正当化できる場合には同時検定が添えられます。族の範囲は、答えとともに記録されます。統計学者はすでにこれに名前をつけています。マルチバース分析(multiverse analysis)では、データを処理する正当化できるやり方をすべて実行し、すべての結果を報告します。その最初の実証では、 p = 0.012 の出版済みの結果が120通りの解析になり、そのうち有意だったのは7つでした [6]。仕様曲線(specification curve)は、妥当なすべての仕様から得られた推定値を図示し、シャッフルし直したデータに対して同じ解析を実行した結果と比べて、それらを同時に検定します。その例の1つでは、1,728通りの仕様のうち37通りが有意でしたが、同時検定の結果は p = 0.85 でした。別の例では、90通りのうち85通りが有意で、同時検定の p は0.002を下回りました [7]。
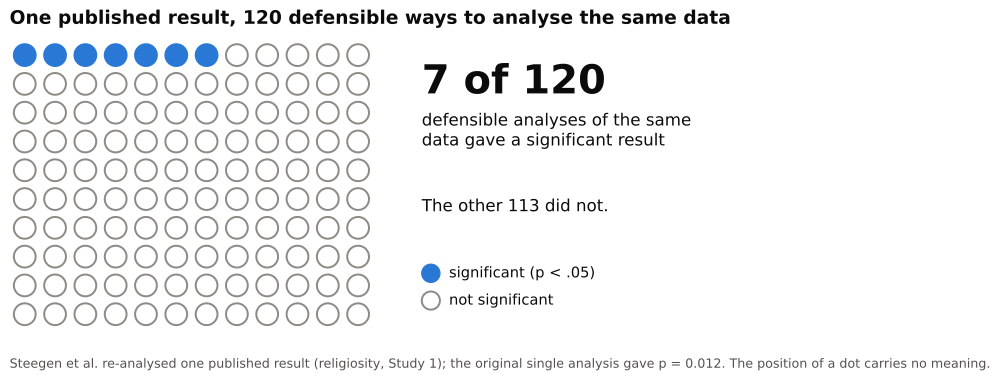
塗りつぶしの円はp < .05で有意、白抜きの円は有意でない。出典:参考文献[6]。
したがって、エンジンの答えは、たとえば次のように読めるかもしれません。規則が許す解析の経路のうち、ほとんどは同じ方向の効果を示し、そうならない経路はどれも、細胞組成を調整しないままにした経路である、と。科学者は、1つの p 値からよりも、この1文から多くを学びます。そしてそれは、論文にはめったに書く余地のない種類の結果です。
規則2:答えとエビデンスは別々の棚に置かれる
2つ目の誘惑は、それぞれの答えを、もう1本の論文としてデータベースに戻し入れ、コレクションが自分自身を糧にして育つようにすることです。困るのは、そうするとエビデンスが自分自身を引用し始めることです。5番目の論考で、私たちはこれの人間版に出会いました。ある1つの主張をめぐって、それを検証した論文への214件の引用のうち94%が、主張を支持する4本の論文に向けられ、仮説が引用だけによって事実になったのです [8]。自らの答えをエビデンスとして数えるシステムは、同じことを機械の速度で行うことになります。
機械学習にも関連する結果があります。言語モデルを、世代を重ねて、前の世代が生成したテキストでファインチューニングしていくと、モデルはまず、元のデータの分布の裾にあるまれな事例を失いました。毎回、元のデータの10分の1を残しておくと、劣化はわずかにとどまりました [9]。この知見はモデルの訓練についてのものであって、データベースについてのものではなく、私たちはこれを、類推による警告として受け取っています。まれで扱いにくい観察こそ、発見がたいてい始まる場所であり、自らの要約を糧にする記録は、そうした観察をならして消してしまいます。この結果は、元の観察を保存する理由になります。私たちのデータベースは、そこに来歴の規則を加えます。導出された答えは、それが使ったエビデンスと区別できる状態を保つ、という規則です。
第4段である「階層化」は、エビデンスの水準を分けておくもので、ここではデータベースに2つの棚を与えます。1つ目の棚には観察が置かれます。監査済みの論文とデータのカプセルです。2つ目の棚には導出された成果が置かれます。エンジンの答えであり、そのそれぞれが、使ったカプセルのバージョンに結びつけられています。導出された答えは、読むことも、引用することも、異議を唱えることも、順位をつけることも、ほかの答えと組み合わせ直すこともできます。記録された依存関係を通じて別の解析の参考になることはできますが、追加の独立したエビデンスとして数えられることは決してありません。答えが1つ目の棚に移る道は1つだけです。誰かがそれを検証し、その実験または新しい研究の結果が、ほかのものと同じように監査されて、カプセルとして入ることです。ですから、このシステムは確かに使われるたびに成長しますが、そのエビデンスが成長するのは、現実の世界に問い合わせたときだけです。
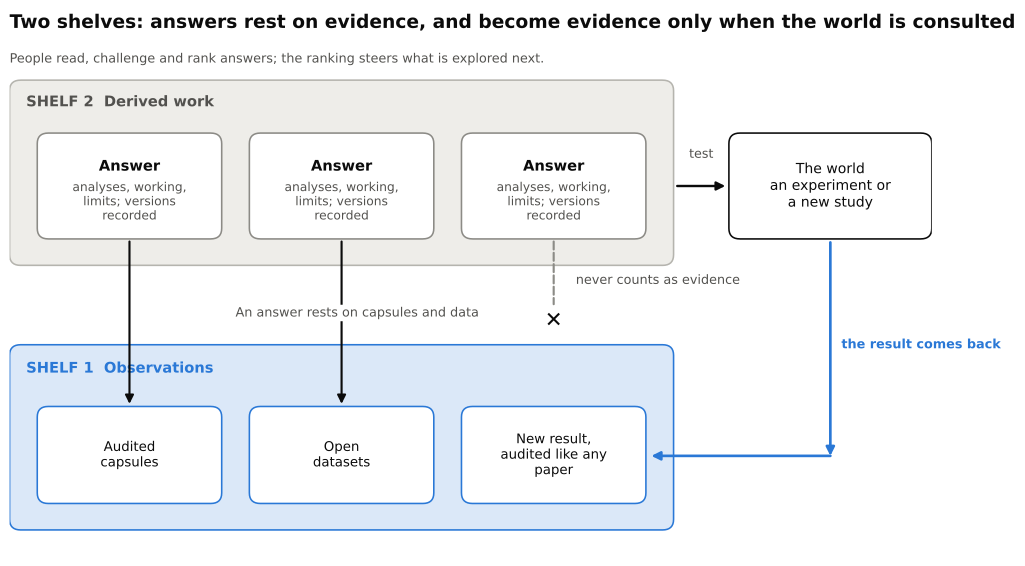
答えは上の棚に置かれ、下の棚を引用する。答えがエビデンスになるのは検証を通じてだけで、その結果は監査済みのカプセルとして下の棚に戻る。
規則3:第5段は消去し、残ったものが発見である
4番目の論考で私たちは、はしごの最上段である を、「自己省察」と呼ぶ一手として読みました。数学では、この体系は非可述的な内包を許します。ある種類のすべての集合(新しく作られる集合自身も含みます)にわたって量化する条件によって、集合を作るのです。私たちの読み方は、あの論考と同じく、類推です。科学では、因果的な主張は、同じ観察についての競合する説明に対して成り立たなければなりません。ですから、それを検証するということは、1本の道をたどることではなく、競合する説明の空間を見渡すことを意味します。
この段は説明を発明しません。記録と矛盾する説明を取り除きます。コンパイルされたトピックは、候補となる説明のそれぞれについて、それを支持するカプセル、それと矛盾するカプセル、そしてそれぞれがどのような条件のもとでそうだったのかを保持しています。条件とは、種、性別、曝露期間、アッセイ、多重性、そして特徴的なバイアスを伴う研究デザインです。その空間を見渡すことは、どの1本の論文にも含まれていないグラフの上での計算です。
規則1の解析にわたって、また独立したコホートにわたって成り立つ効果を想像してみてください。エンジンはそれを、文献が提示するそれぞれの説明に照らしてチェックします。既知の経路、バッチによるアーティファクト、一部の研究は調整し、ほかの研究は調整しなかった交絡因子、第2の経路を通じて作用する遺伝的バリアント、といった説明です。成り立たなかった説明にはそれぞれ、それと矛盾するカプセルを添えて印がつけられます。ありうる結末は3つです。1つの説明だけが生き残ることがあり、その場合エンジンは、どの論文も述べていない仮説を組み立てたことになります。複数の説明が生き残ることもあり、その場合エンジンは、それらの予測がどこで異なるかを示します。あるいは、1つも生き残らないこともあります。その場合エンジンはまず、効果そのもの、抽出、そして研究が共有している仮定をチェックしに戻ります。矛盾は、発見であるよりも誤りであることのほうが多いからです。それでも効果が成り立つなら、エンジンは価値あるものの位置を突き止めたことになります。記録のなかの何によっても説明されない、頑健な効果です。残った説明が異なる結果を予測するところでは、エンジンはそれらを切り分ける実験を提案し、そうでないところでは、欠けている測定を名指しします。説明のリストは文献が提示するものであり、それが完全であると知ることは誰にもできません。ですから、エンジンが手渡すのは提案です。これは、5番目の論考のトライアンギュレーションを、探索として実行したものです。
この方法には名前と歴史があります。1964年にJohn Plattは、これを強い推論(strong inference)と呼びました。対立する仮説を考案し、ありうる結果が、できるかぎりそのうちの1つ以上を排除するような決定実験を考案し、明瞭な結果が得られるようにそれを実行し、残ったものに対してこの手順を繰り返す、というものです。彼はその源流をFrancis Baconと、T. C. Chamberlinの複数仮説の方法にたどり、例と議論を根拠として、分子生物学と高エネルギー物理学の進歩の速さをこの方法の功績としました [10]。どんな仕事に対しても、彼が用いた試金石は1つの問いでした。あなたの実験は、どの仮説を反証するのですか。エンジンは、その問いを文献全体に一度に投げかけます。
これは控えめな意味で新しいものであり、私たちは、その控えめな意味こそが役に立つ意味だと考えています。発見とは、正確な輪郭を持つ空白であり、そこに至ったすべての段階は、人が開くことのできるチェックです。そこはまた、エンジンが引き渡しを行う場所でもあります。因果階層定理がその理由を述べています。例外的な場合を除けば、観察されたことは、それだけでは介入が何をもたらすかを定めず、観察から効果を計算するには、追加の因果的な仮定が必要です [11]。エンジンは、それぞれの答えとともにそれらの仮定を明示し、仮定が未決のまま残していることに実験が決着をつけられる箇所に印をつけます。
人間の判断が探索の舵を取る
エンジンは、利用に人の判断が伴うことで、使われるほど良くなります。科学者がどの問いを立てるか、どの答えを開くか、どれに異議を唱え、どれを高く順位づけるかは、すべて、分野の注意がどこにあり、どこにないかについてのシグナルです。こうしたシグナルは、注意を向ける先を決める助けになります。1,790万本(17.9 million)の論文を対象とした研究では、参考文献リストの大部分が慣例的な組み合わせで、そこに珍しい組み合わせが少しだけ含まれている論文は、高被引用になる可能性が2倍近く高くなっていました。高被引用はインパクトの1つの尺度です [12]。SouratiとEvansは、このことを発見のモデルに組み込みました。彼らは文献のテキストに、誰が何について書いてきたかの記録を加えました。するとそのモデルは、のちの発見を、テキストだけの手法と比べて、エネルギー材料では約2倍の適合率で、ドラッグリポジショニングでは43%高い適合率で予測しました。このモデルは、科学者が見ていないところを見るように調整することもでき、そこで提案された候補は、実験なしに、理論の上で評価されました [13]。人々の評価が生成器の舵を取れるという直接のエビデンスは、最近のものです。110人の研究グループリーダーが、システムがそれぞれのために生成したアイデアを評価したとき、4,451件の評価のうち36.7%が、興味深さについて最低の点でした。それまでに集まった評価によって新しいアイデアを順位づけると、上位5件に占める興味深いアイデアの割合はおよそ2倍になり、49%に達しました [14]。言語研究についての別の研究では、盲検の査読者が、モデルの研究アイデアを人間の研究者のものよりも新規性が高いと評価しましたが、モデルが生み出した互いに異なるアイデアはわずかでした。4,000件のうち、重複でないものは約200件です [15]。興味深さ、インパクト、新規性は、正しさではありません。スコアの記録は、そのためにあります。
したがって、エンジンには2つのモードがあり、科学者がそのどちらかを選びます。一方は分野に従い、慣例的なものに、珍しいものを少し組み合わせます。もう一方は、誰も試せる立場にいない組み合わせを探します。どちらのモードでも、次に何を探索するかを決めるのは人による順位づけであり、その探索が記録される場所が2つ目の棚です。
導出の過程を見せる
最初の節で見た順位づけは、導出を伴わずに届きます。それがこの順位づけの弱点です。エンジンの答えは、その導出そのものとして届きます。すなわち、答えが拠って立つカプセル、それぞれのカプセルが寄与する条件、そしてそれぞれのステップがはしごのどの段で行われたかです。科学者はこれらをNexitiaのキャンバス上で開き、チェックするのは科学者自身です。導出の過程をたどれない提案は、そもそも提案として科学者に届きません。
出版された研究は、この手順がなぜ重要かを示しています。どの事例でも、その結果が成果として認められるには、まず人がそれを理解する必要があったからです。結び目理論と表現論では、機械学習モデルが数学者にあるパターンを指し示し、数学者はそれぞれの分野で定理を1つ証明しました。表現論のもう1つの予想は、未解決のままです [16]。ある批評者は、結び目の結果は従来の統計学でもおそらく見つけられただろうが、もう一方はそうではない、と論じました [17]。その批判自体が有益な教訓です。価値は注意を向けさせることにあり、証明は人の側に残ったのです。Schutらは、チェスプログラムAlphaZeroから概念を抽出し、例題のパズルを通じて4人のグランドマスターに教えました。同じ概念から作られた未見のパズルでは、4人全員が以前より多く解きました。12問のうち、1人は5問多く解き、別の1人は1問だけ多く解きました。著者たちはこれを概念実証と呼んでいます [18]。生物学では、GoogleのCo-Scientistが、急性骨髄性白血病に対してリポジショニング(転用)する薬剤を提案しました。著者たち自身の細胞培養での試験では、専門家が選んだ5つの候補のうち3つが白血病細胞株の生存率を低下させ、システムが単独で選んだ3つの候補のうち1つが明確な活性を示しました。著者たちは、この検証を予備的なものと呼んでいます [19]。
私たちは、人間によるこの手順を設計のなかに組み込んでおり、偶然には任せません。提案を開き、あるカプセルの読み方に異を唱え、提案が変わるのを見ることのできる科学者は、導出の過程を目の前にして、査読者が行うのと同じチェックを行っているのです。
スコアを記録する
提案は、重要な問いを検証可能にすることによって自らの居場所を得ます。そしてその価値は、検証の結果が戻ってきたときに明らかになります。データベースはバージョン管理され、タイムスタンプが付いているので、それぞれの提案は、その結果が存在する前に、拠って立ったカプセルのバージョン、モデル、検索の設定とともにログに記録できます。ログに記録される各確率には、対象となるアウトカム、集団、期間が明示されます。その後アウトカムは、通常のレコードとして同じデータベースに届きます。結果を伴う新しい研究、追試、訂正、撤回です。時間が経つと、このログはスコアの記録になります。それは較正を示します。つまり、70%の見込みを与えられた提案のうち、約70%が実現した、ということです。また、予測を、基準率だけで得られたはずのスコアと比較します。予測に携わる人々は、こうした記録のための厳密な基準を持っています。スコアリングルールが適正(proper)であるとは、予測者が実際に信じていることを報告したときに、平均して最良の成績になることをいい、ブライアスコアと対数スコアは、その意味で厳密に適正です。同じ論文は、私たちが採用する目標も述べています。予測が較正されていることを条件として、予測をできるかぎり鋭くすることです [20]。基準率を繰り返すだけの記録は較正されていますが、科学者にはほとんど何も伝えません。
科学における予測は測ることができます。そして出版された試みは、それが機能することと、まだどれほど控えめなものであるかの両方を示しています。ある研究では、研究者たちによる予測市場が、心理学の41件の追試のうち29件を正しく言い当てました。つねに失敗を予測するという規則なら、正解は25件でした [21]。その後の、社会科学の21件の実験では、市場の信念による知見の順位は、追試による順位とよく似ており、順位相関は0.84でした [22]。96本の心理学論文のテキストだけを読んだモデルは、そのうち68%を正しく分類しました。つねに失敗を予測する場合は61%です [23]。そして、すでに臨床試験に入っている医薬品開発プログラムのなかでは、標的がその疾患についてヒトの遺伝学的な裏づけを持つものは、第1相から上市まで進む可能性が2.6倍でした [24]。それ以前の推定は約2倍でした [25]。これらの研究は、アウトカムをエビデンスの特徴に結びつけています。カプセルのデータベースは、その構造上、そうした特徴を記録し、アウトカムを、届くたびに記録していきます。Swansonはすでに、スコアが分けておかなければならない2つの場合を区別していました。知見が存在する前になされた予測と、すでに公刊されていた報告についての遡及予測(retrodiction)です [1]。
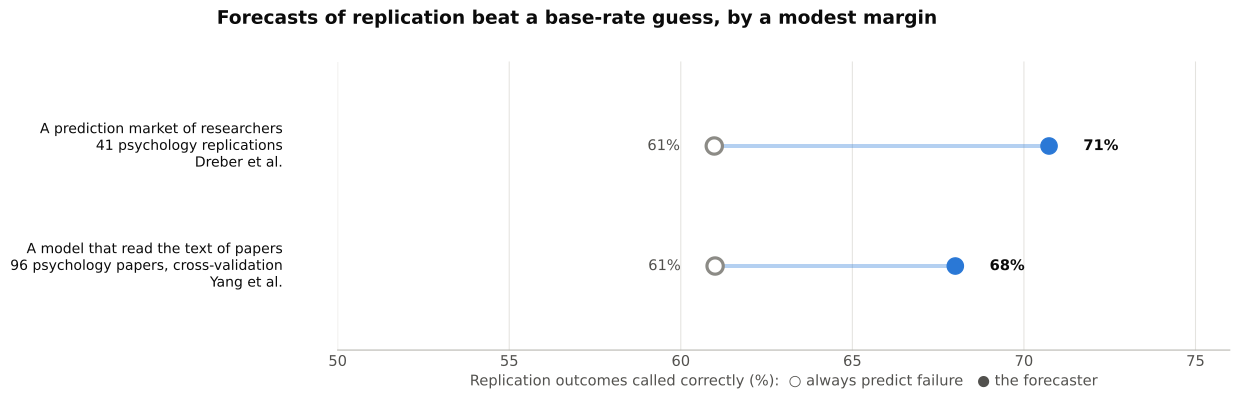
塗りつぶしの点が予測する側、白抜きの点が常に失敗と予測する規則である。2つの研究は異なる論文を使っているため、行どうしは比べない。出典:参考文献[21]、[23]。
新しい研究のたびに更新される記録は、どれほど頻繁に「発見だ」と声を上げるかも制御しなければなりません。出版されたある手法は、ランダム化試験についてこれを行います。その仮定のもとで、この手法は、効果がないときに、蓄積していくエビデンス(e値として表されます)が発見の閾値を一度でも越える確率を、解析がどれほど頻繁に更新されても制御します [26]。多くの問いを同時に追うエンジンには、それに加えて多重性の規則が必要であり、これもまた第3段です。
うまくいかなくなりうることが3つあり、設計はそのそれぞれに答えを用意しています。ラベルにはバイアスがかかりえます。検証、追試、撤回の対象になる主張は一部だけだからです。そのためスコアは、アウトカムの前になされた提案だけを使い、検証された提案のなかでの成績を記述します。読み手が選択を見て取れるように、いくつが検証されたのか、それらがどのように選ばれたのかを報告します。あとから得られた知識が予測に漏れ込むこともあります。撤回のステータスがその例です。すべての予測はエビデンスの締め切り時点を記録し、遡及的な評価については、あとから届いた情報が含まれていないかを別途確認します。そして著者は、どのチェックがスコアを上げるのかを知ると、チェックに合わせて書くかもしれません。生のファイルがあるところでは、カプセルのチェックはそれを使って統計量を再計算します。文章から取った主張は出典に結びつけられたままになり、欠けている入力は欠落として印がついたままになります。スコアは主張に付くものであり、人に付くことは決してありません。
科学者のもとに残るもの
提案が対象とするのは出版された主張であり、現実の世界に触れるのは実験だけです。5番目の論考で述べたように、豊富さの時代のボトルネックは消化です。人が検証し、説明し、吸収できるよりも速く、結果が届くからです。解析の族全体で答え、導出の過程を見せ、スコアを記録するコンパイルされた文献は、そのボトルネックに直接役立ちますが、それを取り除きはしません。どの問いが重要かを選び、提案がもっともらしいかどうかを判断し、検証された結果を、ほかの人が検証できる説明に変えるのは、やはり科学者です。
私たちは、スコアの記録が、科学者がこうしたデータベースを使って仕事をするやり方を変えると期待しています。較正された計測器が、科学者が測定値を扱うやり方を変えるのとよく似ています。どれほどの頻度で正しかったかを報告する文献は、科学者が計測器を使うのと同じように使える文献です。それがつねに正しいからではなく、どれほどの頻度で正しいかを告げるからです。
参考文献
- Swanson DR (1990). Medical literature as a potential source of new knowledge. Bulletin of the Medical Library Association 78(1): 29–37. https://pmc.ncbi.nlm.nih.gov/articles/PMC225324/. 論理的につながっていながら互いに引用していない文献の組を3つ概観しています。魚油とレイノー症候群については、25本と34本の論文に共通する論文も著者もなく、2年後に報告された32人の患者のランダム化試験がその推論を支持しました。著者はこの方法を、レシピでもアルゴリズムでもないと呼んでいます。
- DiGiacomo RA, Kremer JM, Shah DM (1989). Fish-oil dietary supplementation in patients with Raynaud's phenomenon: a double-blind, controlled, prospective study. The American Journal of Medicine 86(2): 158–164. doi:10.1016/0002-9343(89)90261-1. 32人の患者が魚油またはオリーブ油を投与されました。原発性レイノー症候群では、魚油群の11人中5人、オリーブ油群の9人中1人で、寒冷による発作を誘発できなくなりました。続発性レイノー症候群では有益性は認められませんでした。
- Tshitoyan V, Dagdelen J, Weston L, Dunn A, Rong Z, Kononova O, Persson KA, Ceder G, Jain A (2019). Unsupervised word embeddings capture latent knowledge from materials science literature. Nature 571(7763): 95–98. doi:10.1038/s41586-019-1335-8. およそ330万件(3.3 million)の抄録で訓練した単語ベクトルが、熱電材料の候補を順位づけました。2009年より前の抄録から作り直すと、上位5つのうち3つがのちに熱電材料として報告または示唆され、2つは一度も研究されませんでした。83種類の材料にわたって、この順位づけと測定された性能との順位相関は0.59と0.52でした。
- Ioannidis JPA (2005). Why most published research findings are false. PLoS Medicine 2(8): e124. doi:10.1371/journal.pmed.0020124. 統計的に有意な知見が真である確率が、事前オッズ、検出力、バイアスの項、チームの数に依存するモデルです。著者は、デザインと解析の柔軟性がバイアスを高めると論じています。その例に出てくる数値は仮定であって、測定値ではありません。
- Stefan AM, Schönbrodt FD (2023). Big little lies: a compendium and simulation of p-hacking strategies. Royal Society Open Science 10(2): 220346. doi:10.1098/rsos.220346. 真の効果がなく、有意水準を5%としたシミュレーションです。相関のない10個のアウトカムのうち最良のものを報告すると偽陽性は約40%、12通りの外れ値の規則では30%近く、より穏やかな戦略では約7.5%から10%でした。
- Steegen S, Tuerlinckx F, Gelman A, Vanpaemel W (2016). Increasing transparency through a multiverse analysis. Perspectives on Psychological Science 11(5): 702–712. doi:10.1177/1745691616658637. データ処理の選択の、妥当なすべての組み合わせを実行します。ある出版済みの研究では、元の論文が p = 0.012 を報告していたところ、120通りの解析で有意な結果は7つでした。著者たちは、自分たちの選択の集合を一部分だけだと述べています。
- Simonsohn U, Simmons JP, Nelson LD (2020). Specification curve analysis. Nature Human Behaviour 4(11): 1208–1214. doi:10.1038/s41562-020-0912-z. 妥当なすべての仕様から得られた推定値を一緒に示し、シャッフルし直したデータに照らして同時に検定します。ある例では1,728通りのうち37通りが有意で(同時検定の p = 0.85)、別の例では90通りのうち85通りが有意でした(p < 0.002)。
- Greenberg SA (2009). How citation distortions create unfounded authority: analysis of a citation network. BMJ 339: b2680. doi:10.1136/bmj.b2680. 1つの主張をめぐる242本の論文と675件の引用のネットワークで、一次データを含む10本の論文への214件の引用のうち94%が、主張を支持する4本に向けられていました。この研究は引用を分類するもので、主張が正しいかどうかは検証していません。
- Shumailov I, Shumaylov Z, Zhao Y, Papernot N, Anderson R, Gal Y (2024). AI models collapse when trained on recursively generated data. Nature 631(8022): 755–759. doi:10.1038/s41586-024-07566-y. 前の世代の出力で世代を重ねてファインチューニングされた言語モデルは、まず元の分布の裾を失います。各段階で元のデータの10%を残しておくと、劣化はわずかにとどまりました。この結果は訓練に関するもので、生成されたテキストの保存に関するものではありません。
- Platt JR (1964). Strong inference. Science 146(3642): 347–353. doi:10.1126/science.146.3642.347. 対立する仮説と、その一部を排除する決定実験を考案し、そのうえで残ったものを精緻化するときに、分野はもっとも速く進むと論じた講演です。BaconとChamberlinの功績を認め、分子生物学と高エネルギー物理学の例から論じていて、測定されたエビデンスはありません。
- Bareinboim E, Correa JD, Ibeling D, Icard T (2022). On Pearl's hierarchy and the foundations of causal inference. In Probabilistic and Causal Inference: The Works of Judea Pearl, ACM Books, pp. 507–556. doi:10.1145/3501714.3501743. 因果階層の3つの層(観察する、介入する、反事実を想像する)が互いに1つにつぶれることはほとんどないことを証明しています。そのため、観察データから介入の効果を計算するには、その前に因果ダイアグラムを仮定する必要があります。著者たちは、これは一般的な不可能性の結果ではないと付け加えています。
- Uzzi B, Mukherjee S, Stringer M, Jones B (2013). Atypical combinations and scientific impact. Science 342(6157): 468–472. doi:10.1126/science.1240474. 1,790万本(17.9 million)の論文のうち、引用する雑誌の組み合わせの大部分が慣例的で、その一部に新奇な組み合わせを含む論文は、1990年から2000年の論文で、100本あたり9.11本が高被引用でした。背景の割合は100本あたり5本です。これは被引用との関連です。
- Sourati J, Evans JA (2023). Accelerating science with human-aware artificial intelligence. Nature Human Behaviour 7(10): 1682–1696. doi:10.1038/s41562-023-01648-z. 誰が何について書いてきたかをテキストに加えると、予測された発見の適合率が、テキストだけのベースラインと比べて、エネルギー材料で約100%、ドラッグリポジショニングで43%上がりました。科学者が集まっているところを避けるように選ばれた候補は、理論に基づくスコアだけで判定されました。
- Gu X, Krenn M (2026). Generating interesting scientific ideas using knowledge graphs and LLMs: evaluations with 100 research group leaders. Proceedings of the National Academy of Sciences 123(46): e2611349123. doi:10.1073/pnas.2611349123. 110人のグループリーダーが、自分向けに個別化されたアイデアにつけた4,451件の評価のうち、36.7%が興味深さについて最低の点で、24.9%が5点満点の4または5でした。集まった評価による順位づけでは、上位5件での適合率は49%で、基準率は約25%でした。この評価が測っているのは個人的な興味であり、正しさではありません。
- Si C, Yang D, Hashimoto T (2024). Can LLMs generate novel research ideas? A large-scale human study with 100+ NLP researchers. ICLR 2025. arXiv:2409.04109. 盲検の査読者は、モデルが生成したアイデアに、人間の研究者のアイデアより高い新規性のスコアをつけました(5.64対4.84)。対象は、言語研究におけるプロンプティングのトピックだけです。トピックごとに生成された4,000件のアイデアのうち、重複でないものは約200件でした。
- Davies A, Veličković P, Buesing L, Blackwell S, Zheng D, Tomašev N, Tanburn R, Battaglia P, Blundell C, Juhász A, Lackenby M, Williamson G, Hassabis D, Kohli P (2021). Advancing mathematics by guiding human intuition with AI. Nature 600(7887): 70–74. doi:10.1038/s41586-021-04086-x. モデルのアトリビューション(attribution)が、数学者に結び目理論における1つの関係と表現論における1つの関係を指し示しました。数学者はそれぞれで定理を1つ証明し、表現論のもう1つの予想は未解決のままです。
- Davis E (2021). Deep learning and mathematical intuition: a review of (Davies et al. 2021). Preprint. arXiv:2112.04324. 結び目の結果には従来の統計学でおそらく十分だったこと、そして表現論の結果には深層学習モデルが確かに必要だったことを論じています。
- Schut L, Tomašev N, McGrath T, Hassabis D, Paquet U, Kim B (2025). Bridging the human–AI knowledge gap through concept discovery and transfer in AlphaZero. Proceedings of the National Academy of Sciences 122(13): e2406675122. doi:10.1073/pnas.2406675122. 4人のグランドマスターが、AlphaZeroから抽出した概念をもとに作られたパズルを学習しました。その後、4人全員が、同じ概念から作られた未見のパズルを以前より多く解き、その伸びは12問中1問から5問でした。著者たちはこの研究を概念実証と呼び、交絡因子の可能性としてプライミングを挙げています。
- Gottweis J, Weng W-H, Daryin A, Tu T, et al. (2026). Accelerating scientific discovery with Co-Scientist. Nature 655(8122): 487–496. doi:10.1038/s41586-026-10644-y. 急性骨髄性白血病について、専門家が選んだリポジショニングの候補5つのうち3つが細胞株の生存率を低下させ、自律的な実行から得られた3つの候補のうち1つが明確な活性を示しました。著者たちは、この検証を予備的なものと呼んでいます。
- Gneiting T, Raftery AE (2007). Strictly proper scoring rules, prediction, and estimation. Journal of the American Statistical Association 102(477): 359–378. doi:10.1198/016214506000001437. スコアリングルールを、自分の真の信念を報告することで期待スコアが最大になるときに適正、その報告だけが期待スコアを最大にするときに厳密に適正と定義しています。ブライアスコアと対数スコアは厳密に適正であり、予測の目標は、較正を条件とした鋭さであると述べています。
- Dreber A, Pfeiffer T, Almenberg J, Isaksson S, Wilson B, Chen Y, Nosek BA, Johannesson M (2015). Using prediction markets to estimate the reproducibility of scientific research. Proceedings of the National Academy of Sciences 112(50): 15343–15347. doi:10.1073/pnas.1516179112. 完了した心理学研究の追試41件のうち、25件が失敗しました。研究者による市場は、41件のうち29件を正しく言い当てました。取引の前に同じ研究者に行った調査は、40件のうち23件を言い当てました。
- Camerer CF, Dreber A, Holzmeister F, Ho T-H, Huber J, Johannesson M, Kirchler M, Nave G, Nosek BA, Pfeiffer T, et al. (2018). Evaluating the replicability of social science experiments in Nature and Science between 2010 and 2015. Nature Human Behaviour 2: 637–644. doi:10.1038/s41562-018-0399-z. 21件の実験のうち、13件が再現されました。信念と再現との順位相関は、予測市場で0.84、調査で0.76でした。
- Yang Y, Youyou W, Uzzi B (2020). Estimating the deep replicability of scientific findings using human and artificial intelligence. Proceedings of the National Academy of Sciences 117(20): 10762–10768. doi:10.1073/pnas.1909046117. 追試が行われた96本の心理学論文のテキストで訓練したモデルは、交差検証で0.68の正解率に達しました。つねに失敗を予測した場合は0.61です。ほかの追試プロジェクトの317本の論文では、0.65から0.78でした。
- Minikel EV, Painter JL, Dong CC, Nelson MR (2024). Refining the impact of genetic evidence on clinical success. Nature 629(8012): 624–629. doi:10.1038/s41586-024-07316-0. 臨床開発中の、標的と適応症の29,476組のうち、ヒトの遺伝学的な裏づけのある組は、第1相から上市まで進む可能性が2.6倍でした。この関連は後ろ向きのものであり、著者たちは、これが遺伝学的な知見が薬になる確率を与えるものではないと注記しています。
- Nelson MR, Tipney H, Painter JL, et al. (2015). The support of human genetic evidence for approved drug indications. Nature Genetics 47(8): 856–860. doi:10.1038/ng.3314. 遺伝学的な裏づけのある標的を選ぶことで、臨床開発の成功率が2倍になりうるとした、それ以前の推定です。
- ter Schure J, Grünwald P (2025). ALL-IN meta-analysis: breathing life into living systematic reviews and prospective meta-analyses. F1000Research 11: 549, version 2. e値を使うと、どの試験にも効果がないときに、更新されていくエビデンスが閾値を一度でも越える確率は、解析がどれほど頻繁に更新されても、定められた水準以下になります。ランダム化試験のために開発されたもので、区間は従来の解析より広くなります。